生信小记:Seurat的常见分析工作流程:以PBMC_3K数据集为例
更新日志
2025/4/26
- 更正了“确认数据集维度”中,对肘部图意义解释的错误。
- 修改了“执行非线性降维”引语中,对于PCA降维不足之处的表述。
- 在“创建Seurat对象”中,新增对于读入文件的解释。
- 修正了一些排版错误。
在网上找了好几篇Seurat包的教程发现对新手都不太友好……遂自己写了一篇……
创建Seurat对象
我们将对10X Genomics免费提供的PBMC数据集进行分析,包括2700个由Illumina NextSeq测序平台测序的单细胞。我们的原始数据包括3个文件:barcodes.tsv、genes.tsv、matrix.mtx。分别用于存储每个单细胞的细胞条形码、基因的标识符和名称、存储基因表达数据。
数据的读取
Read10X()函数可以从10X cellranger pipeline的输出中读取数据,并形成一个唯一的分子识别(UMI)计数矩阵。矩阵中的每个值代表所测序的每个细胞中的每个特征(如基因)。对于h5文件格式的文件,可以用Read10X_h5()读取。
10X Cell Ranger Pipeline 是 10X Genomics 公司开发的一套标准化生物信息分析工具,专门用于处理其单细胞测序平台(如 Chromium)生成的数据。它的核心功能是将原始的测序数据(fastq 文件)转化为可用于下游分析的基因表达矩阵。
分子识别(UMI)计数矩阵:在PCR扩增中,同一mRNA分子经PCR扩增后,会产生多个重度的测序片段,如不加干预会导致测得的mRNA表达量偏高。为了避免这种情况,我们在逆转录生成cDNA时会在每个mRNA分子上加上唯一的UMI序列和细胞Barcode(细胞条形码)。这时同一个mRNA经扩增后产生的多个重复序列的UMI完全相同,在数据分析时可以借此消除扩增重复而产生的偏差。
1 | #install.packages("dplyr") |
Seurat对象的创建
在这一步中,我们将创建一个Seurat对象,用于储存我们读入的原始数据和分析结果(如PCA或聚类结果)。
1 | pbmc <- CreateSeuratObject(counts = pbmc.data, project = "pbmc3k", min.cells = 3,min.features = 200) |
- 输出结果
1 | > pbmc <- CreateSeuratObject(counts = pbmc.data, project = "pbmc3k", min.cells = 3,min.features = 200) |
标准预处理工作流程
质量控制(QC)和选择细胞进行进一步分析
单细胞测序计数高度复杂,在测序过程中,细胞死亡或破裂、空微珠(未捕获细胞的微珠,仅包括少量环境RNA)、双胞体或多胞体(两个或多个细胞被包裹到同一微滴中)、环境RNA污染等,都会为测序引入噪声和偏差。因此,我们需要对原始数据进行质量控制(QC)。
常用的质量控制指标包括:
- 细胞独特基因数量:低质量细胞中表达的基因数量很少,空微珠仅有少数环境RNA污染,因此检测到的基因数量偏低。同时,双胞体或多胞体中,单个微珠中包含了两个及两个以上的细胞,因此检测到的基因数量会偏高。
- 细胞内分子总数:细胞内分子总数和细胞独特基因数量密切相关,因此也可以借此筛除不合格的数据。
- 线粒体基因比例:即线粒体基因UMI占总UMI的比例。在死亡或破裂的细胞中,线粒体RNA泄露而更容易被捕获,其线粒体基因比例偏高;而在空微珠中,仅有少量污染的环境RNA,因此其线粒体基因比例偏低。
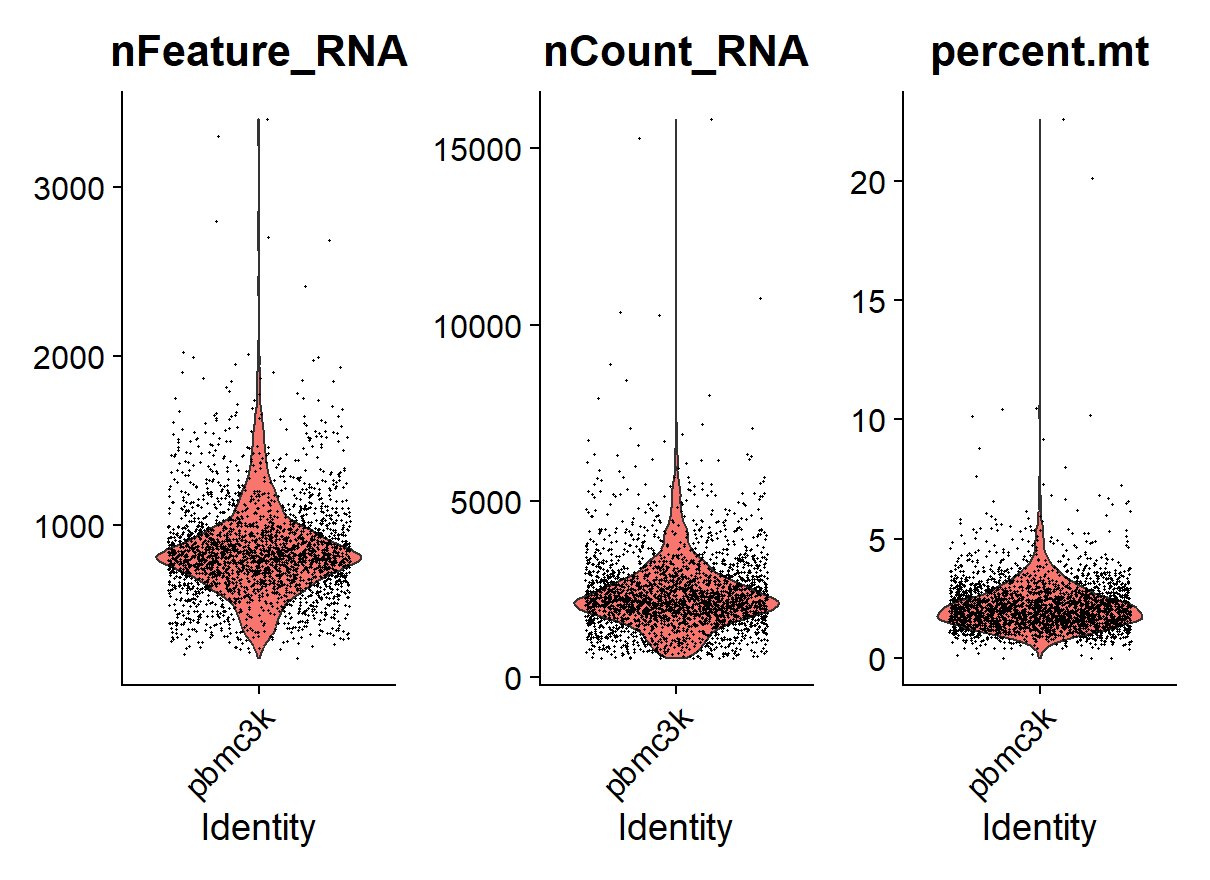
在这里,我们采用上述指标作为QC指标。其中,我们以“MT-”开头的所有基因的集合作为一组线粒体基因,利用PercentageFeatureSet()函数计算线粒体基因比例。然后,我们将QC指标进行可视化,借此筛选细胞。
1 | #计算线粒体基因比例 |
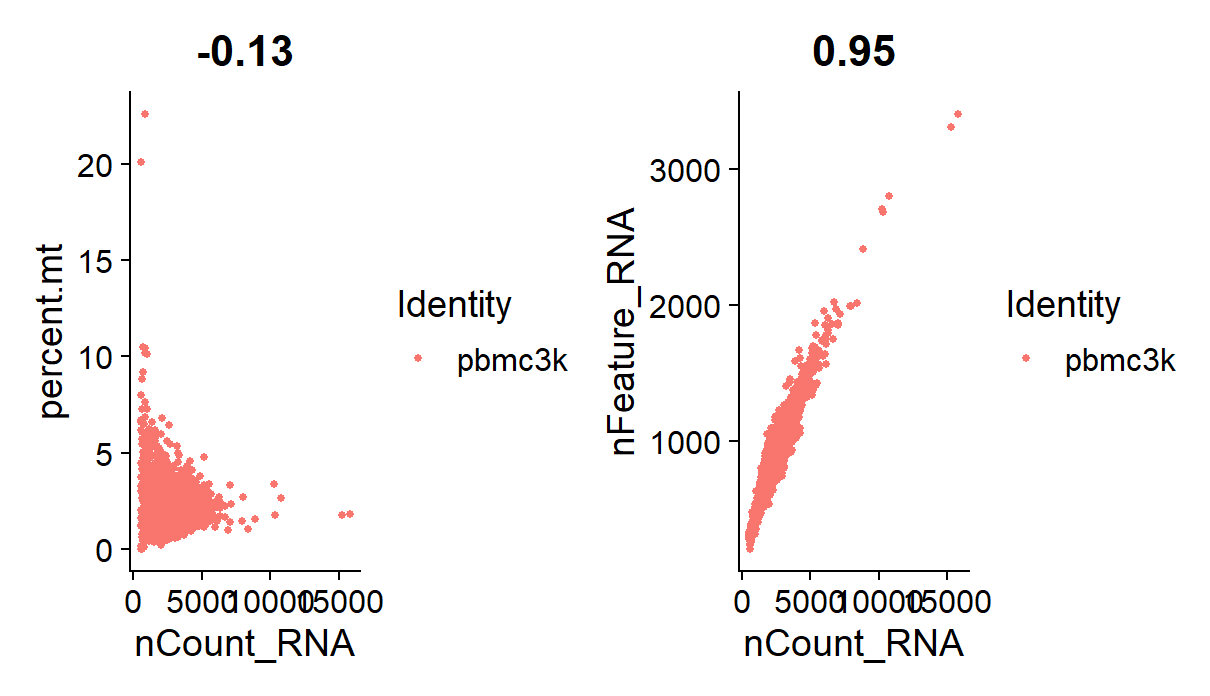
接下来,我们利用FeatureScatter()函数,生成并组合nCount_RNA和percent.mt,nCount_RNA和nFeature_RNA的散点图,有利于我们从多维视角,更精准地识别低质量细胞并确定合理的过滤标准。
| 模式特征 | 可能原因 |
|---|---|
| 低nCount_RNA和高percent.mt | 细胞破裂或死亡 |
| 高nCount_RNA和高nFeature_RNA | 双胞体或多胞体 |
| 低nCount_RNA和低nFeature_RNA | 空微珠或环境RNA污染 |
1 | plot1 <- FeatureScatter(pbmc, feature1 = "nCount_RNA", feature2 = "percent.mt") |
最后,我们根据下述标准,过滤低质量细胞。
- 基因数量(特征计数)超过2500或少于200。
- 线粒体计数大于5%。
1 | pbmc <- subset(pbmc, subset = nFeature_RNA > 200 & nFeature_RNA < 2500 & percent.mt < 5) |
数据标准化
由于测序技术的缺陷,每个细胞测序深度的差异难以保证完全相同。测序深度高的细胞所检测到的总UMI数(可以理解为总mRNA数)偏多,而测序深度浅的细胞所检测到的总UMI数偏少,而这种差异往往会掩盖真正的生物学表达差异。为了消除这种技术性偏差,一般情况下我们会使用一种全局缩放标准化方法”LogNormalize”(先叫它“对数标准化法”叭),该方法的原理是:将每个细胞的基因表达值除以该细胞基因的总表达量,再乘以缩放因子数(一般为10000),最后对结果进行对数转换得到标准化的表达量。
1 | pbmc <- NormalizeData(pbmc, normalization.method = "LogNormalize", scale.factor = 10000) |
对数标准化法通过消除细胞间总UMI数的差异,消除了测序深浅对分析结果造成的偏差。然而,细胞间总UMI数的差异并不一定(或者说并不全是)由测序深度的差异造成的,也有可能是细胞间“天然”的表达量差异。而忽略这种“天然”差异、一刀切地消除细胞间总UMI数的差异,也会对分析结果造成影响,产生偏差。为了更精准地分离上述偏差,可以使用Seurat包中的“SCTransform”法进行数据标准化,在本文不进一步展开。
识别高变基因
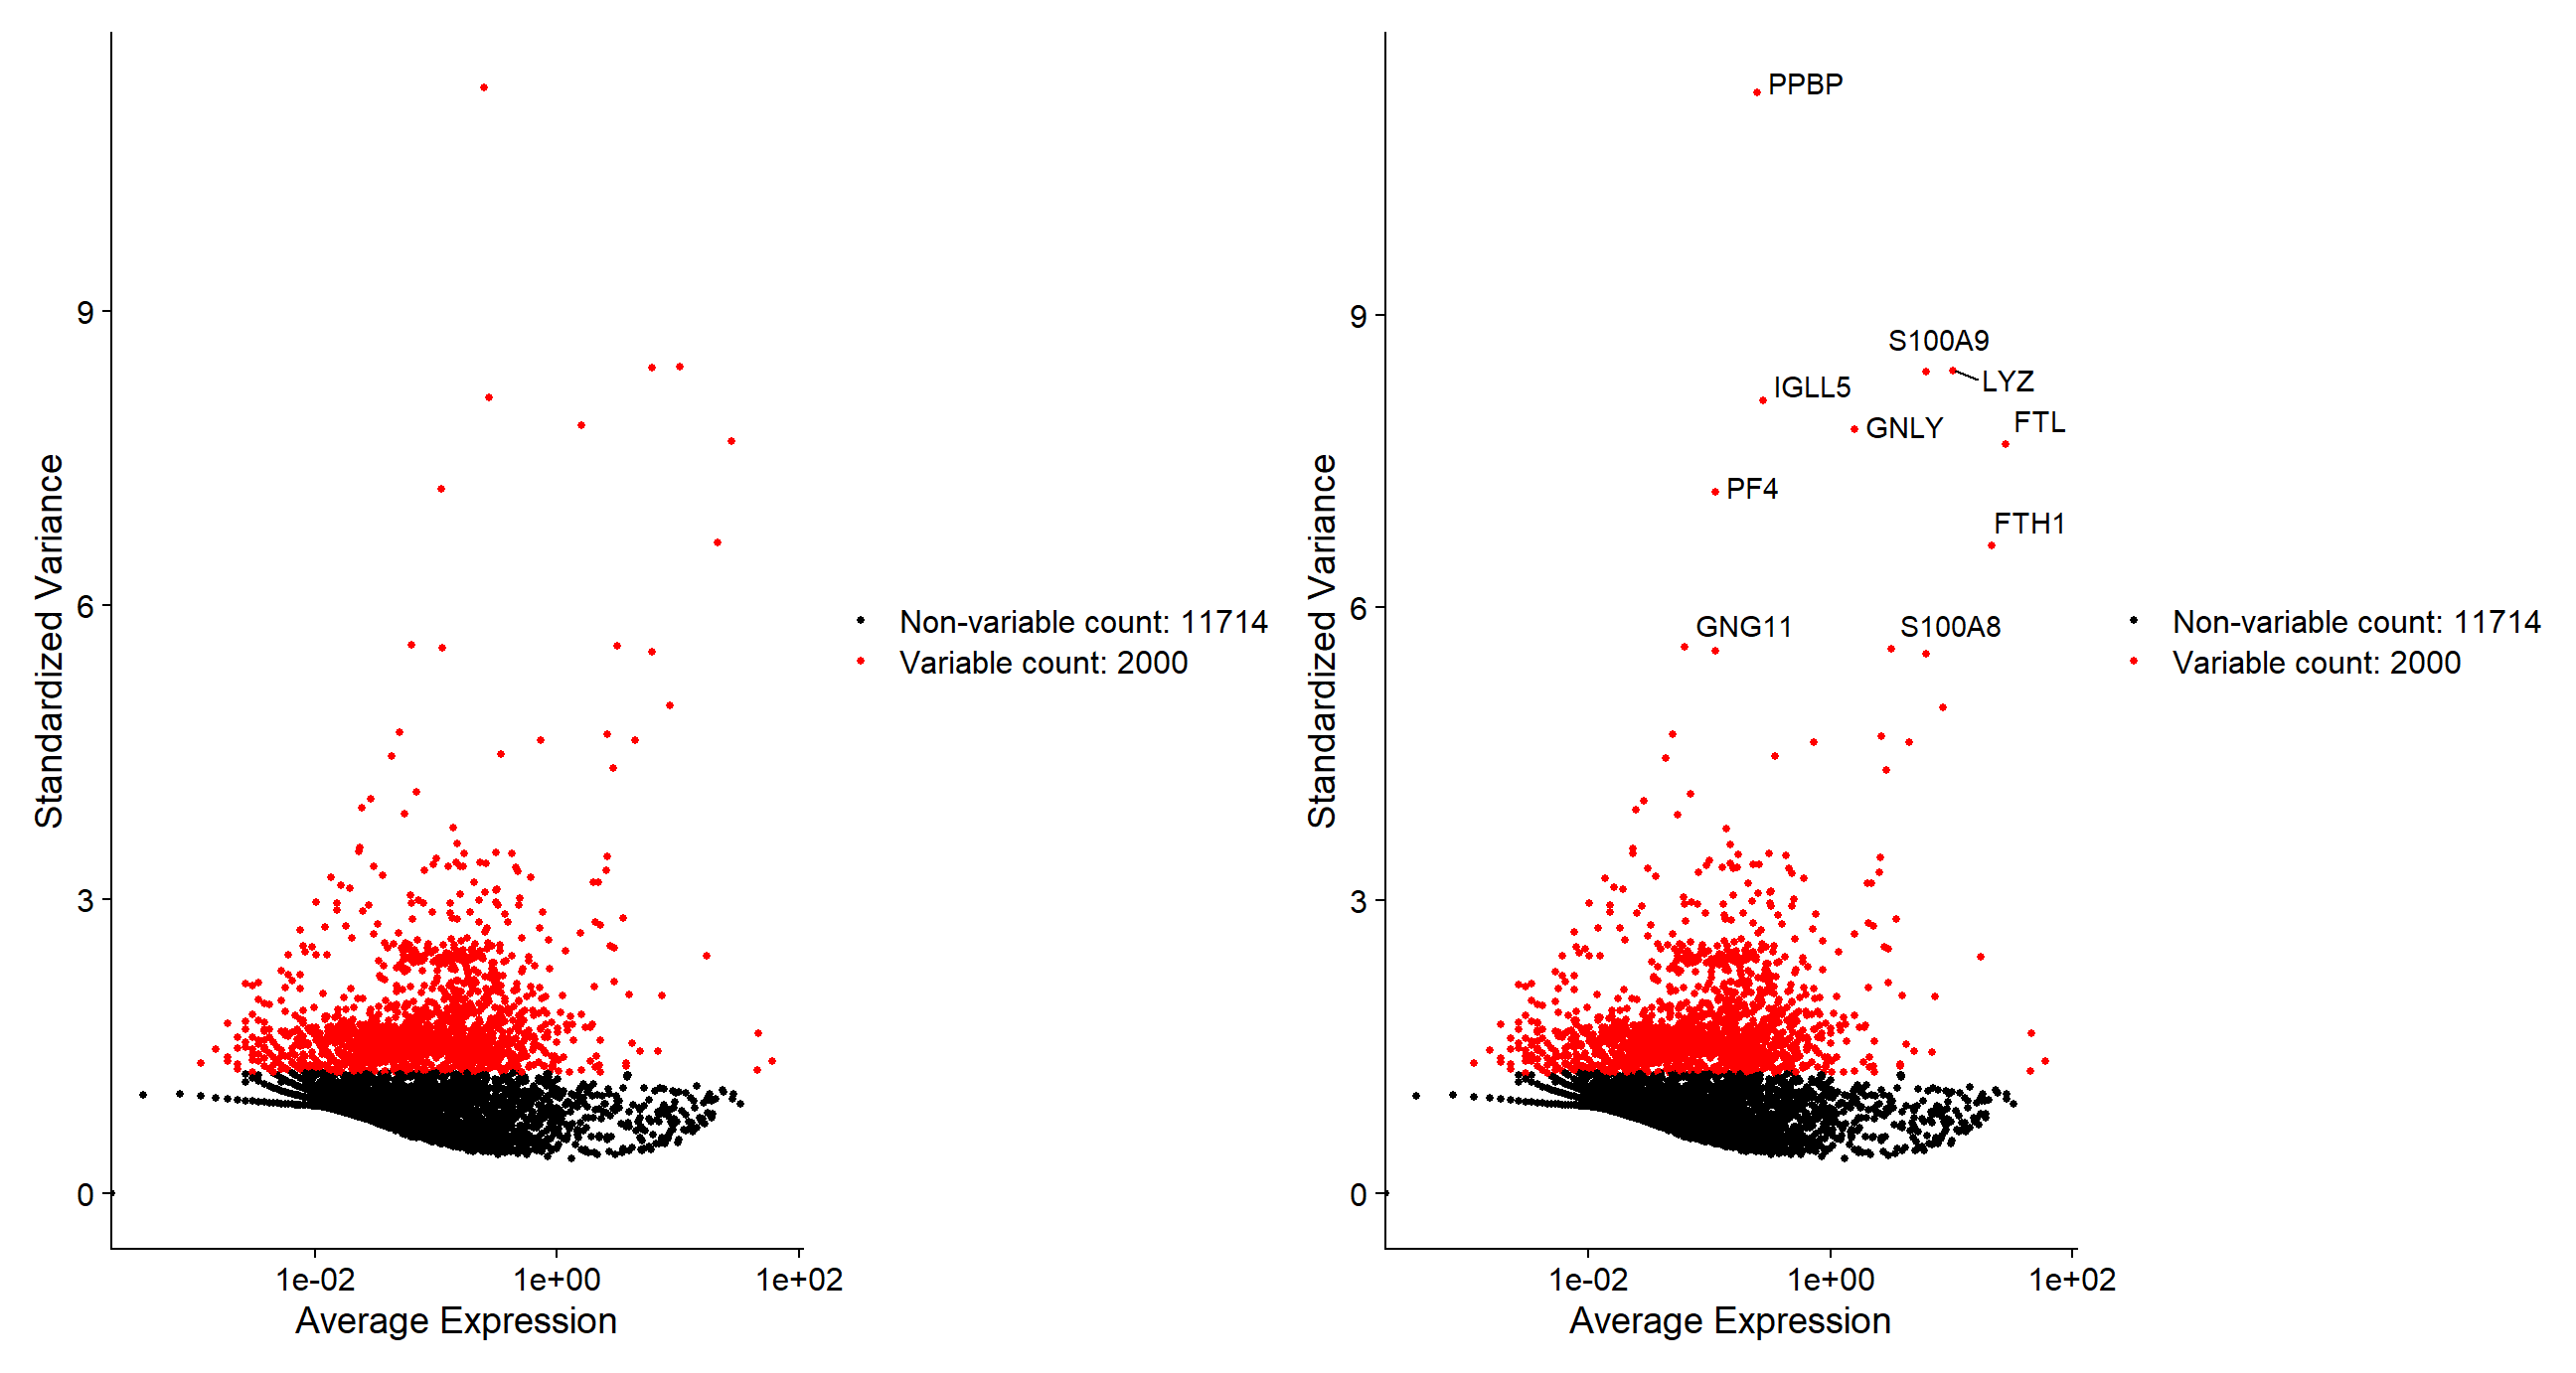
高变基因(Highly Variable Genes,HVGs)是指不同细胞之间表达差异显著的一类基因(这里需要和高表达基因作区分,高变基因侧重于“方差大”,而高表达基因则侧重于“均值大”)。鉴定高变基因有利于更加突出单细胞数据集中的生物信号。
在进行筛选之前,我们需要先理顺在前面步骤已经处理的和尚未处理的偏差。在质量控制这一步中,我们清除了低质量细胞,排除了破裂或死亡细胞、双胞体/多胞体等不合格细胞的影响;在数据标准化这一步中,我们消除了技术限制所带来的不同细胞间总UMI数的差异。尽管如此,由于技术限制,我们很难保证在单个细胞内不同mRNA均得到了同等水平的扩增,这也会对分析产生影响,尤其对于低表达基因,测序技术的偏差往往远大于其真实表达水平的差异。而对于中高表达基因,其真实表达水平的差异往往会远大于测序技术所带来的偏差,此时后者可以忽略。因此我们需要在消除上述技术偏差的前提下筛选高变基因。常用的方法有vst法、mean.var.plot法、dispersion法等,它们都是基于均值-方差关系(即表达量-表达差异关系)进行筛选的方法。此处选择vst法进行筛选。
1 | pbmc <- FindVariableFeatures(pbmc, selection.method = "vst", nfeatures = 2000) |
数据缩放(Z-score标准化)
为了理解数据缩放的必要性,首先我们需要对PCA降维算法具有一些初步了解。
在测序之后,我们可以得到一组有n个基因表达水平的信息,这些基因之间相互影响,而我们需要找出这些基因之间的相互关系,确定不同细胞基因表达模式的不同。如果只有2个基因,我们会考虑使用一个二维的坐标系来表示不同的细胞,x轴、y轴分别表示两个基因的表达水平,而坐标系中的每个点则代表每一个细胞。如果两个点的距离越近,则说明这两个细胞的基因表达模式更加相近,两个细胞越有可能是同一种类的细胞(这时的图像比较直观);如果有3个基因,那么就可以用三维的坐标系(还能用);但测序结果中往往有许许多多个基因,这时候很难以图像的形式直观反映(许许多多维的图……怎么想都想不出来叭)。这时候我们需要对数据进行降维,去繁化简,将高维数据的特征反映在低维的图像上,从而为分析带来便利。
PCA算法的作用在于将一个$n$维的数据降低至$k$维的数据($n>k$),使得数据更加直观化。这$k$维中的每一维,我们称为主成分(PC),其反映了最能区分不同种类细胞的最主要差异(可以理解为,最能区分不同种类细胞的基因表达模式)。举个通俗的例子来说,一个城市的经济水平可以通过GDP、人均收入、消费水平、三大产业的比例等等许多指标反映($n$维),这时候如果我们需要比较$m$个城市的经济水平,那我们手头上就有一个$n×m$的表格,一眼望过去难以直观对比不同城市的发展情况。通过PCA降维分析,我们总结出了几个最关键的因素:整体经济规模(对应GDP、人均收入、消费水平)、产业结构差异(对应三大产业分别的占比),等等等等($k$维)。这一些我们总结出来的“最关键因素”也就是主成分。通过这种降维操作,我们将一个$n×m$的表格简化成为一个$n×k$的表格,比较起来就相对简单多了。我们将其对应至单细胞测序分析中,“城市经济水平”即对应“细胞基因表达模式”,“GDP、人均收入、消费水平、三大产业的比例”即对应“各个基因的表达水平”,“整体经济规模”“产业结构差异”则对应不同的基因表达水平的特定组合,这一组合可以反映不同细胞的总体基因表达模式的重要特征。
PCA的原理在此处不详细展开,但其核心为协方差的计算,这是我们现在需要关注的部分。协方差反映两个或多个因素之间的关联强度,简化版的协方差的计算公式为: $\text{Cov}(X,Y)=\frac{1}{n-1}\sum_{i=1}^{n}(x_i-\bar{X})(y_i-\bar{Y})$ 。在一个细胞中,不同基因的表达水平的数量级可能存在巨大差异,而这种数量级差异会对分析结果造成巨大影响。
举例来说,假设我们现在有X、Y两个基因的表达水平信息,如下:
基因X |
基因Y |
|---|---|
| 5 | 15 |
| 10 | 30 |
| 15 | 45 |
不难看出,两个基因的表达量呈完全正相关关系,此时直接计算两个基因之间的协方差,结果为25。
如果拿到的X、Y两个基因的表达水平信息如下:
基因X |
基因Y |
|---|---|
| 5 | 100 |
| 10 | 200 |
| 15 | 300 |
此时两个基因的表达水平仍然呈正相关关系,但如果直接计算两个基因之间的协方差,结果为500。
由上可见,两种情况中两个基因的关联强度都是一样强的(完全正相关)。但由于第二种情况中Y基因表达水平的数量级远远大于第一种情况,协方差的计算结果也出现了巨大的差异。这时如果直接进行比较,反而会得到“第二种情况中两种基因的关联强度远远大于第一种情况”的错误结论。因此,为了纠正这种情况,我们需要将数据“缩放”至同一数量级,在此基础上再进行降维分析。
Z-score标准化可以消除这种差异,其可以将每个变量的数据转换为均值为0、标准差为1的分布:$z=\frac{x-μ}{σ}$,其中$μ$为变量的均值,$σ$为变量的标准差。对上述两种情况的数据进行标准化之后,其结果一致如下:
基因X(标准化后) |
基因Y(标准化后) |
|---|---|
| -1 | -1 |
| 0 | 0 |
| 1 | 1 |
此时计算两个基因之间的协方差,结果均为1,表明它们具有相同的相关性模式。(有没有发现,标准化后的协方差其实就等于原始数据的相关系数!)
在Seurat包中,ScaleData()函数可以实现对数据的Z-score标准化,即①使每个基因的表达值偏倚,使得细胞间的平均表达为0;②对每个基因的表达值进行缩放,使得细胞间的方差为1。借此可以在保留协方差(即不同基因表达量之间的关系)的同时,将不同数量级表达水平的基因转化到同一水平,从而消除高表达基因的主导作用。
1 | all.genes <- rownames(pbmc) |
执行线性降维
接下来,我们会对缩放后的数据进行PCA分析。默认情况下只会输入先前确定的HVGs,如需选择不同的子集,可以使用argument进行定义。
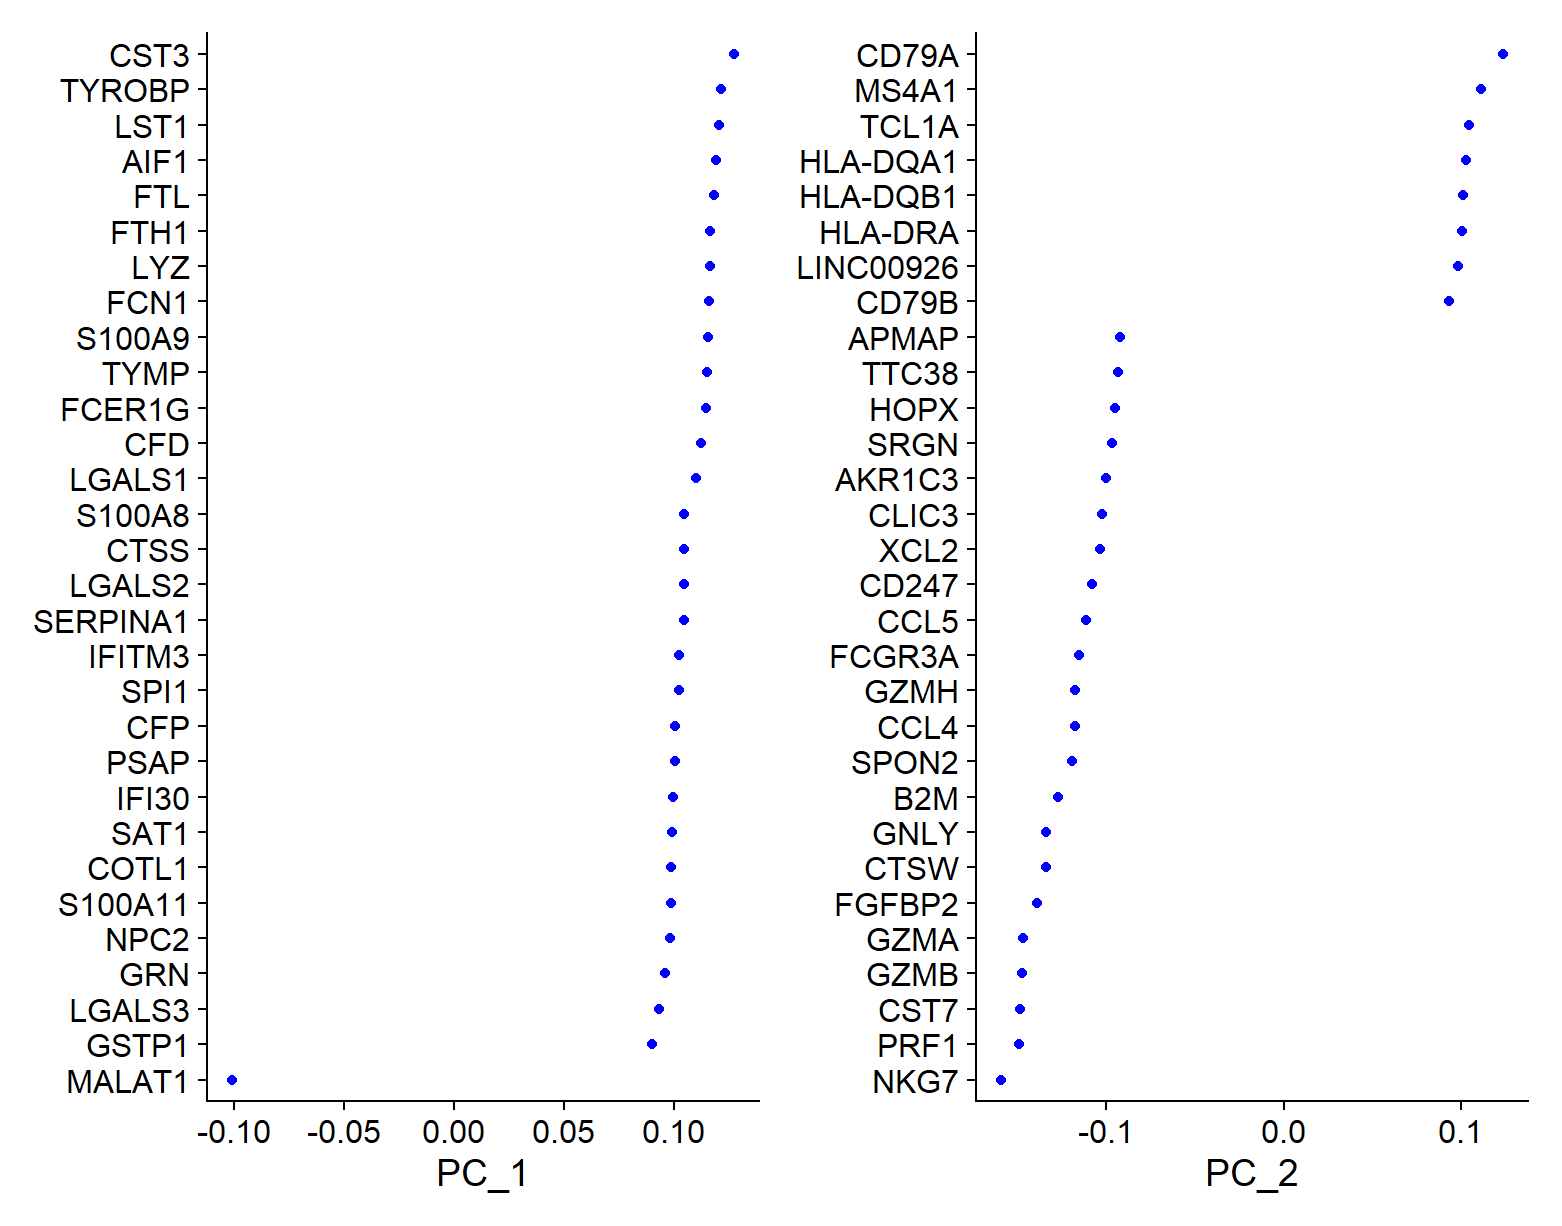
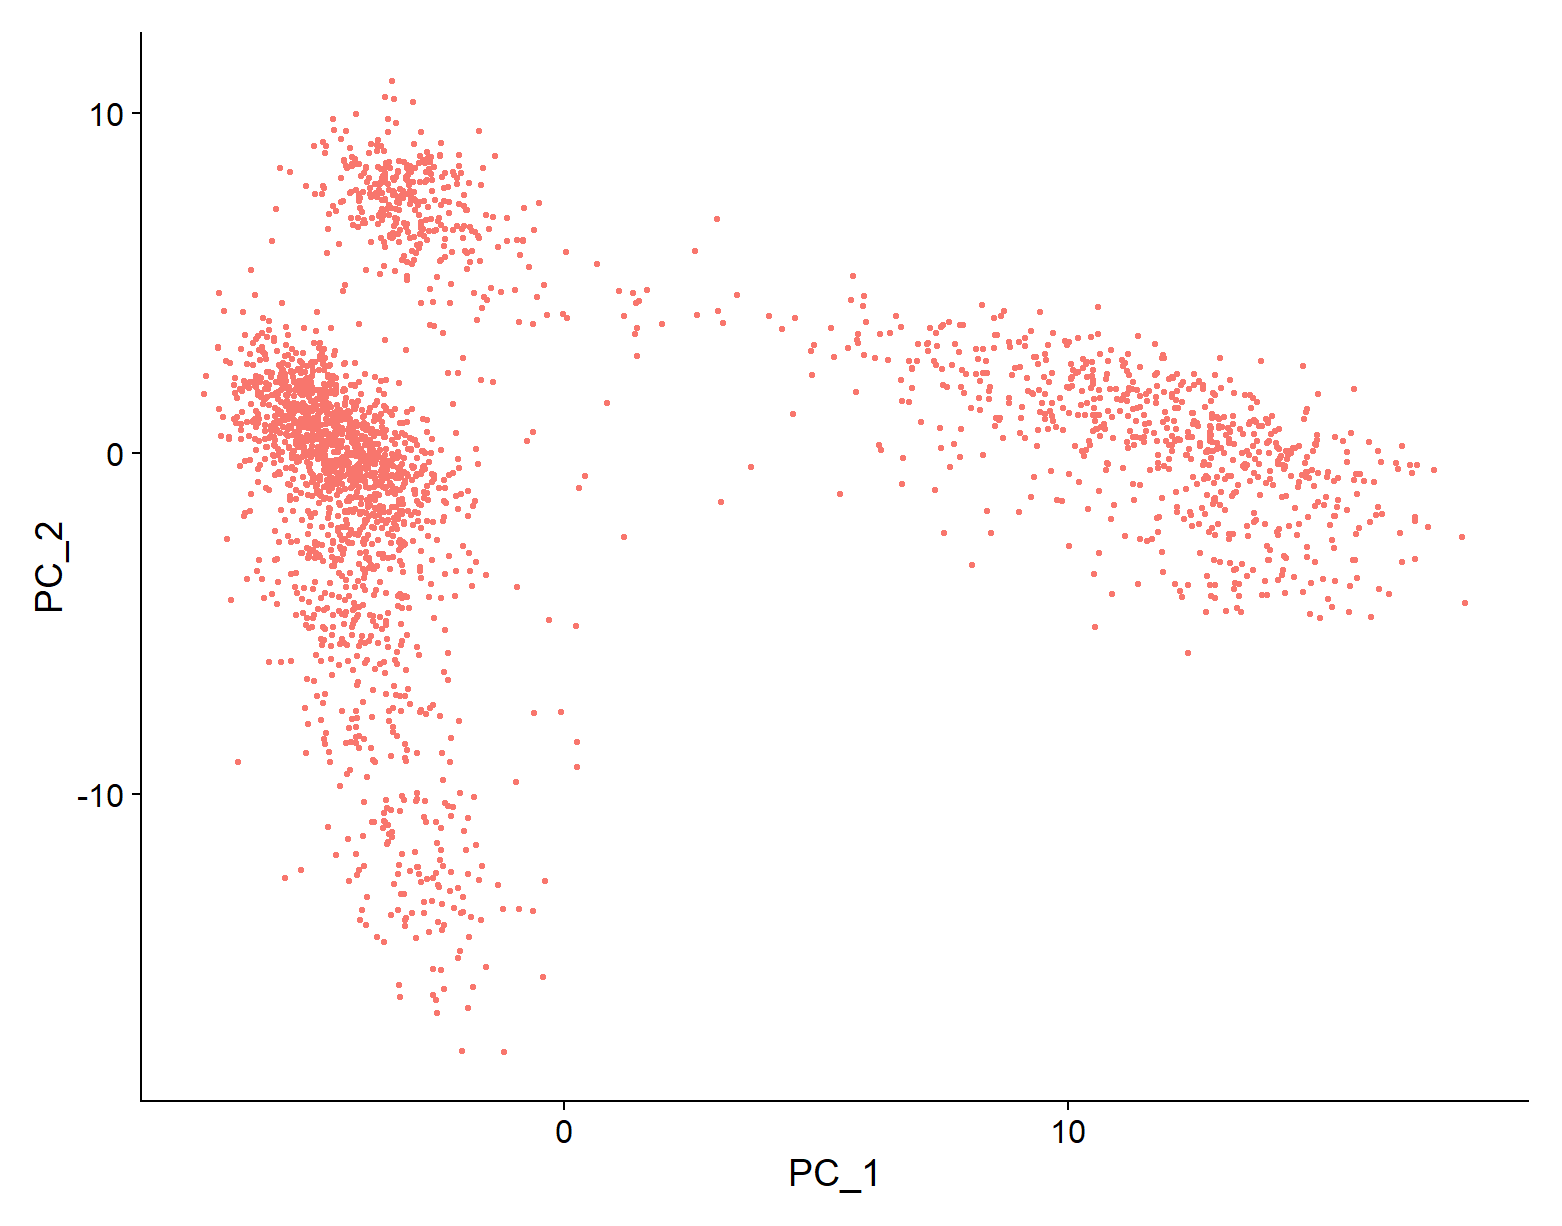
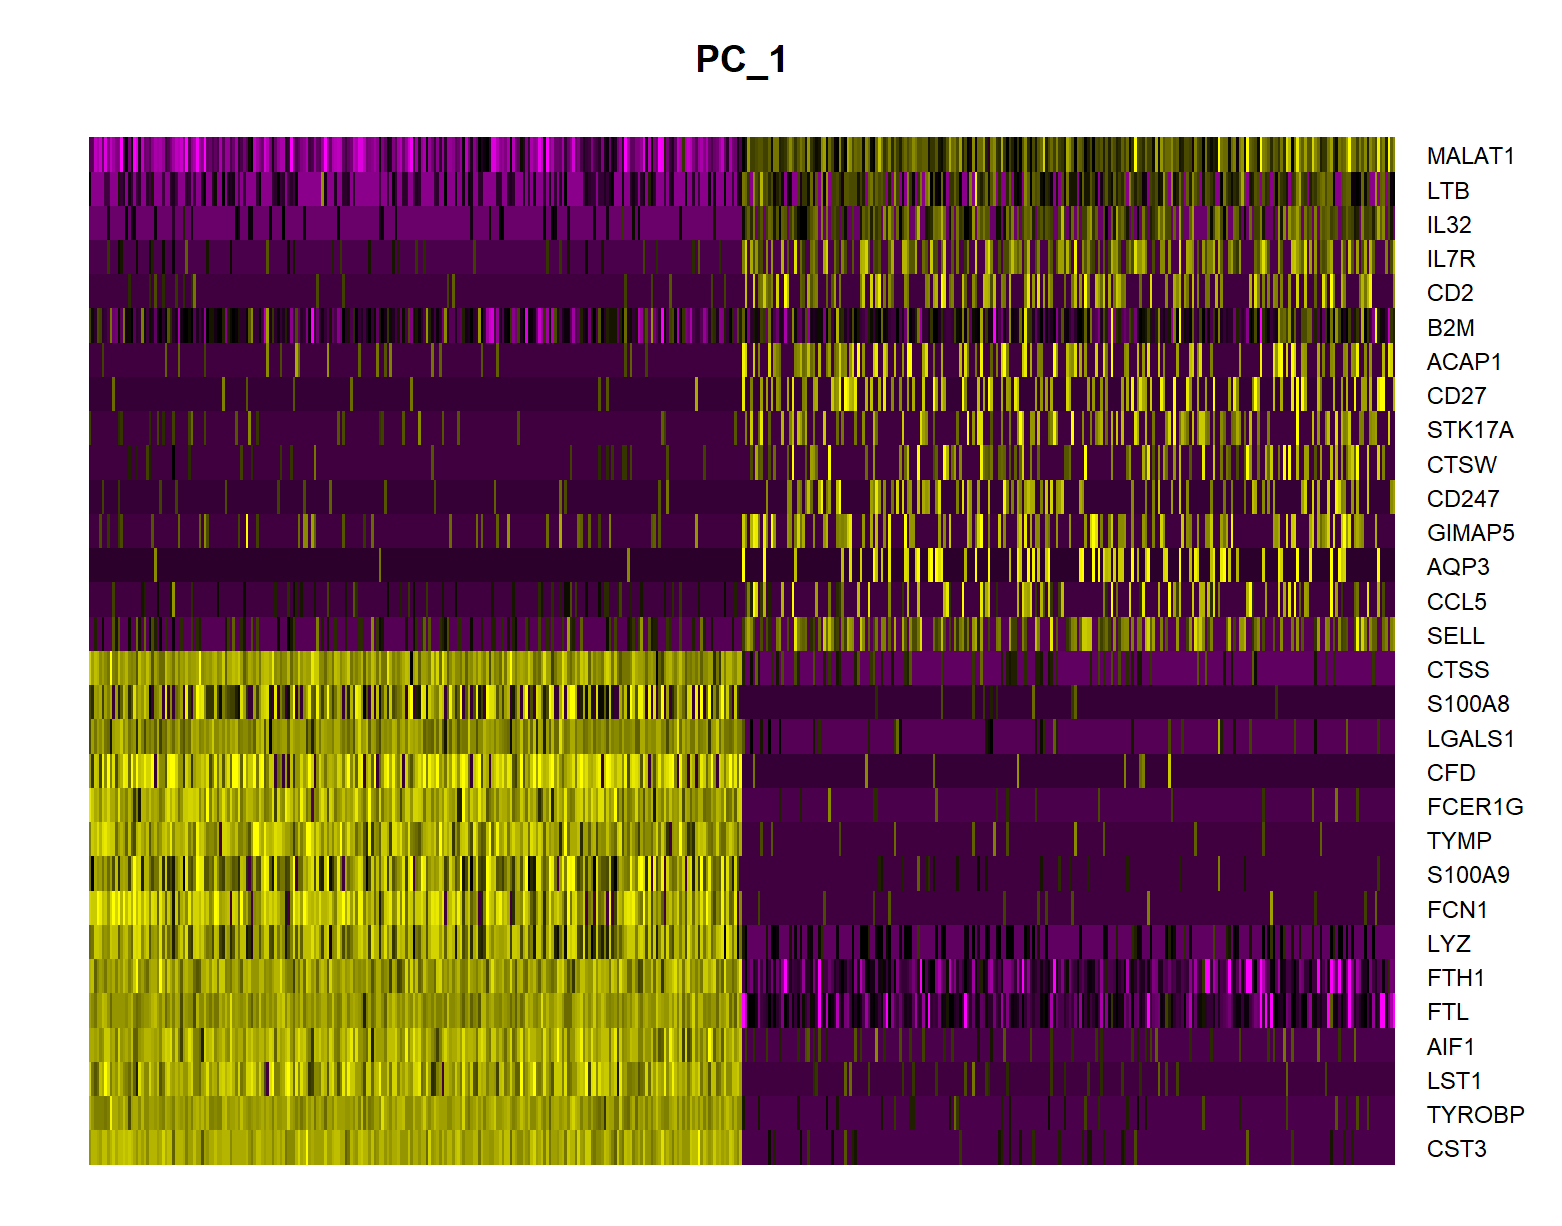
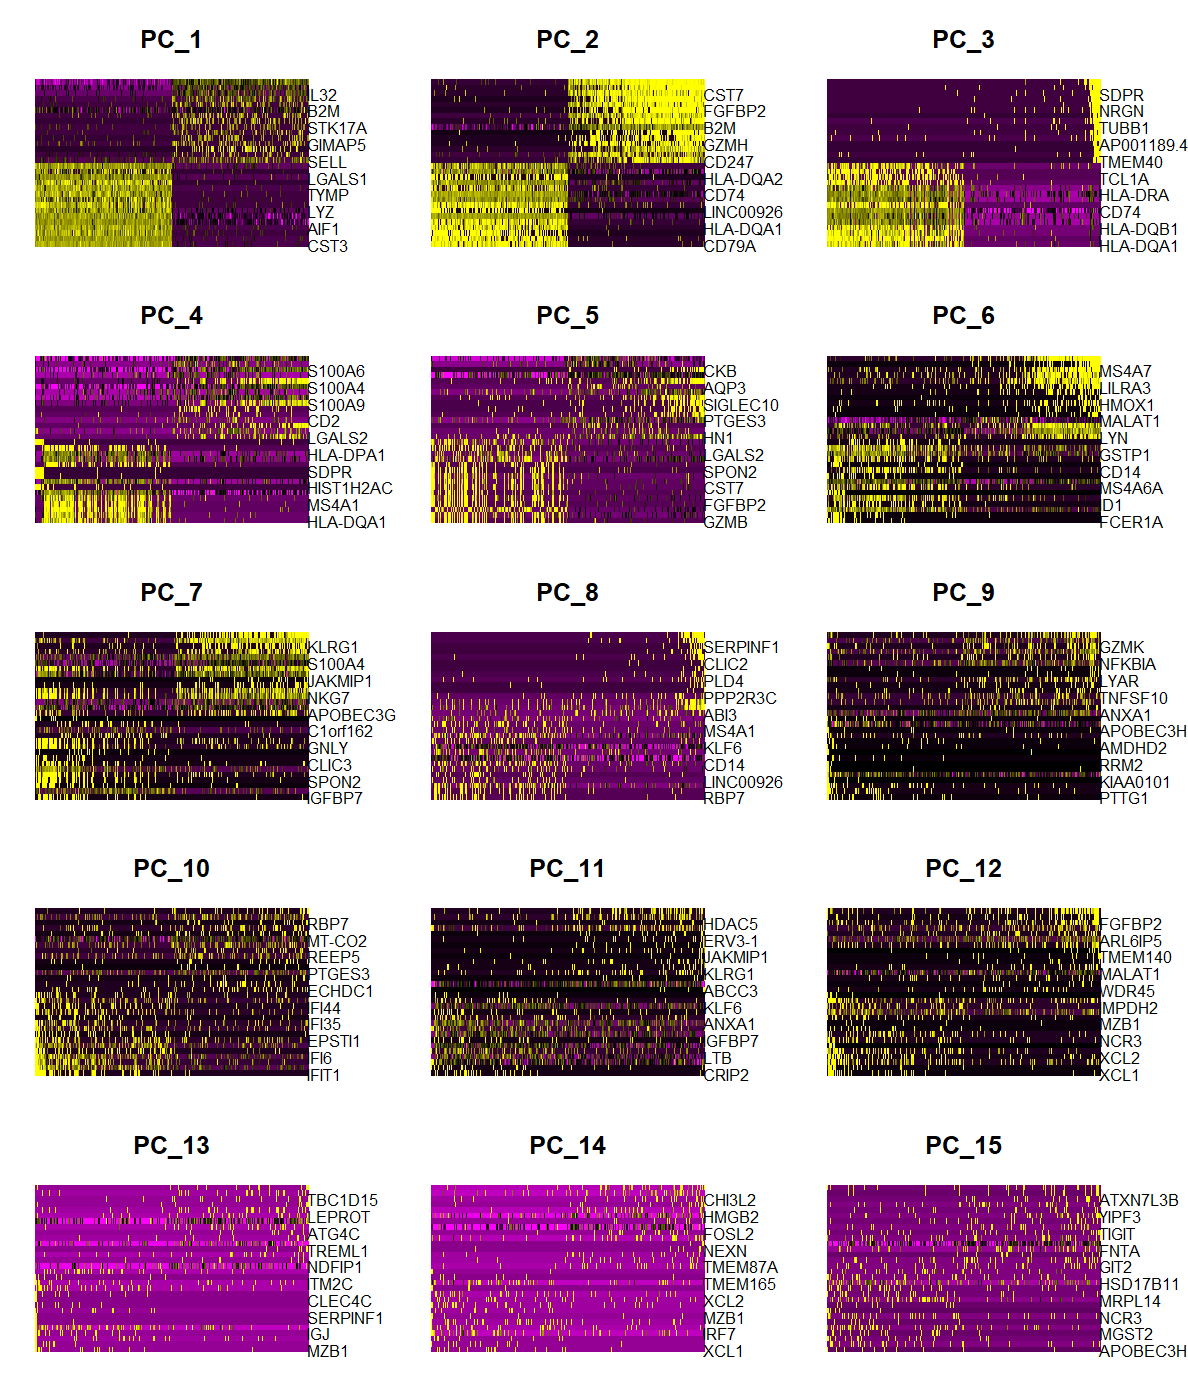
对于PCA分析的结果,Seurat包提供了多种可视化的方式,包括VizDimReduction()、DimPlot()和DimHeatmap()等。
1 | pbmc <- RunPCA(pbmc, features = VariableFeatures(object = pbmc)) |
- 运行结果
1 | > pbmc <- RunPCA(pbmc, features = VariableFeatures(object = pbmc)) |
1 | > #可视化PCA |
运用VimDimLoadings()进行可视化:
1 | VizDimLoadings(pbmc, dims = 1:2, reduction = "pca") |
运用DimPlot()进行可视化:
1 | DimPlot(pbmc, reduction = "pca") + NoLegend() |
运用DimHeatmap()进行可视化:
1 | DimHeatmap(pbmc, dims = 1, cells = 500, balanced = TRUE) |
1 | DimHeatmap(pbmc, dims = 1:15, cells = 500, balanced = TRUE) |
确认数据集的维度
在上一步中,我们通过PCA降维算法得到了若干个主成分。但如果我们选择全部的主成分进行下一步分析,一方面会导致计算量增大,不利于大数据集的分析;另一方面会导致过度细分细胞簇,不够直观。但反之,如果我们选择的主成分过少,则会导致细胞分簇的精度下降,不足以体现出不同种类细胞的生物学差异。因此,我们需要平衡二者,选择一个适当的主成分数量进行进一步分型。
肘部图可以通过计算并比较在选择不同数量的主成分进行聚类分簇后,每个细胞距离其所属簇中心的距离平方和(有资料称其为惯性、SSE),来确定选择主成分最佳数量。SSE数值越大,说明拟合的精度越低;反之亦然。
1 | ElbowPlot(pbmc) |
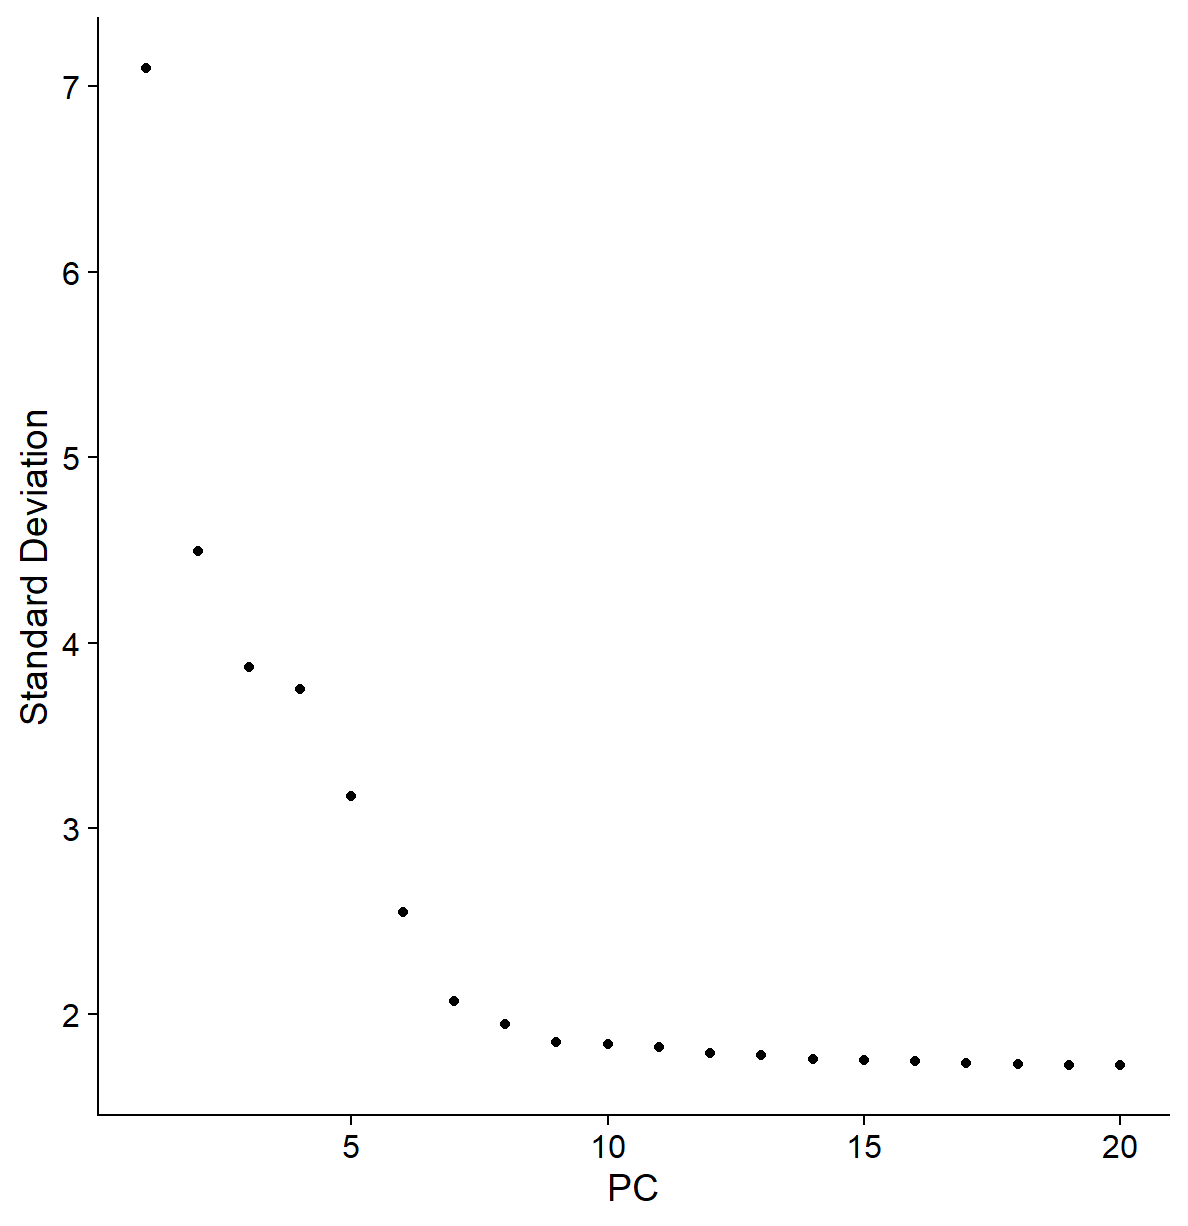
通过上图我们不难看出,选择的主成分数量小于10之前,随着主成分数量的增加,SSE下降的非常快,说明精度随主成分数量的增加而迅速提升;但当选择的主成分数量超过10,SSE的下降速度反而变缓,说明性价比下降。因此,选择10个左右的主成分进行下一步分析比较适合。
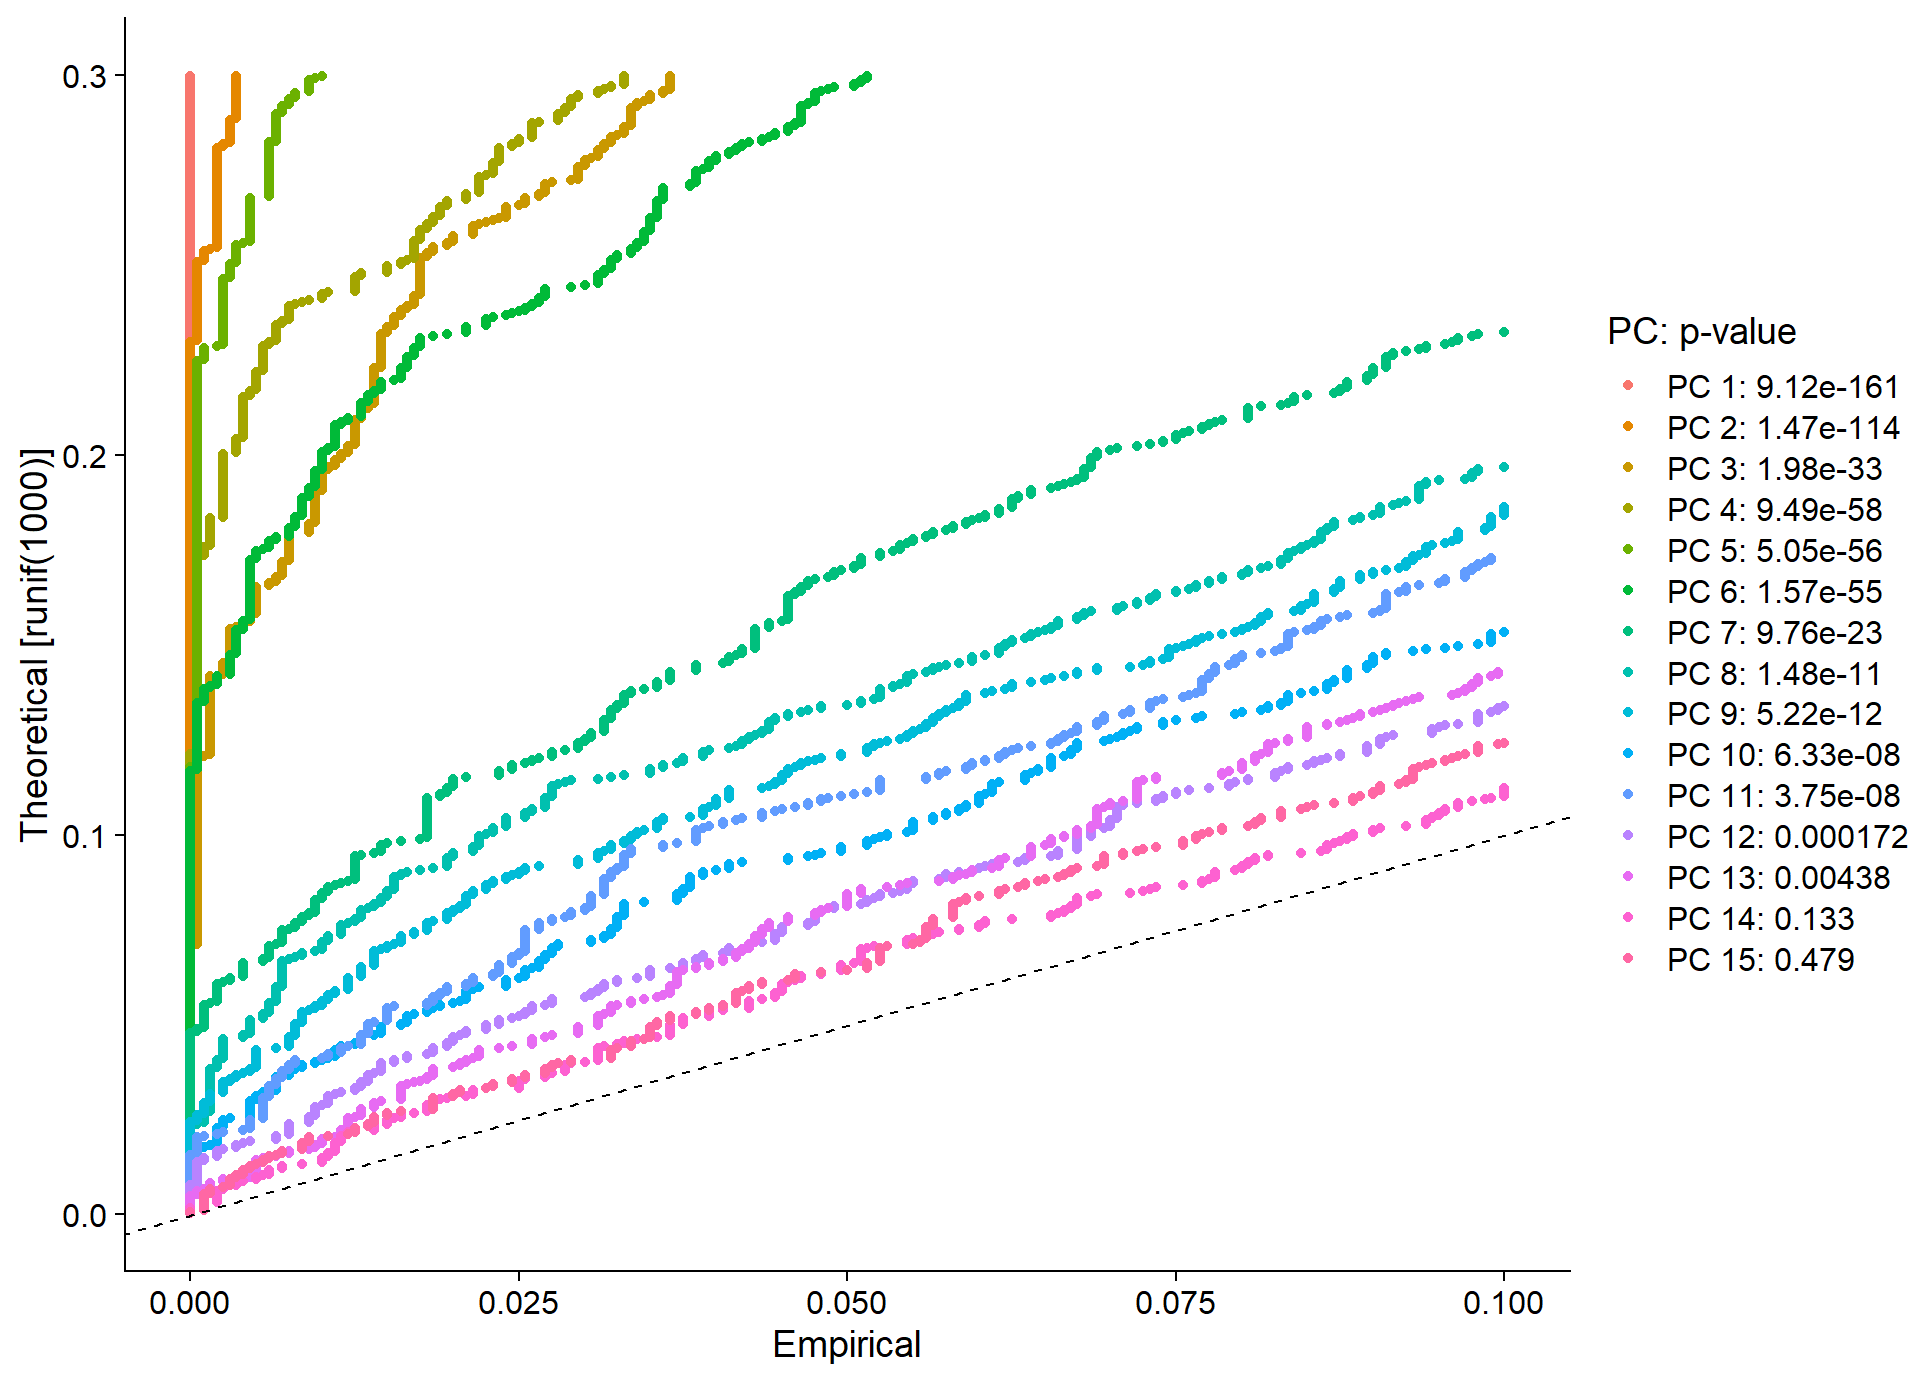
值得一提的是,除了肘部图之外,我们还可以利用JackStrawPlot()函数对主成分进行筛选。但对于较大的数据集,其计算过程往往需要很长时间,因此肘部图仍然是最效率的选择。(为了得到下面这个图,我的电脑跑了三分钟,而肘部图几乎秒出……)
1 | pbmc <- JackStraw(pbmc, num.replicate = 100) |
细胞聚类
在上面几步中,我们确认了不同细胞集群基因表达模式的主要变异方向,将$n×m$的表格降维到了$n×k$的表格。但是,我们还没有对降维后的数据进行分析,还没有确认“哪些细胞属于哪一类”。在这一步中,我们将会将降维后的数据划分为若干组(簇),每组代表一种潜在的细胞类型或状态,也就是细胞聚类。
细胞聚类分为领域图构建和聚类两步,前者通常用KNN算法($K$-Nearest Neighbors)进行;而聚类则有多种方法,Seurat包中默认使用Louvain算法。大致原理如下:
- KNN算法($K$-Nearest Neighbors):通过测量降维后数据中每个细胞间的距离,找到距离每个细胞最近的$K$个细胞(这时我们称这些细胞为“邻居”),借此可以构建一个邻域图(其实就是一个拓扑图)。
- Louvain算法:在通过KNN算法构建领域图的基础上,根据细胞距离的远近将所有划分为不同的“社区(community)”(即不同的细胞集群)。
1 | pbmc <- FindNeighbors(pbmc, dims = 1:10) #KNN算法 |
- 运行结果:
1 | > pbmc <- FindNeighbors(pbmc, dims = 1:10) |
执行非线性降维(UMAP/$t$-SNE)
PCA降维可以对细胞进行初步分群,但其分群还不够精确直观。PCA没有很直观的可视化方法将不同细胞簇很好地分开来。以下图为例,我们只能选取两个主成分进行可视化,但就像简单粗暴地把一个纸团拍扁,尽管保留了整体的轮廓,但有可能因为纸团在压缩过程中发生重叠,丢失了哪一边是顶部、哪一边是底部的信息。因此为了更好地鉴别各个细胞群,我们需要更加精细地处理这些数据。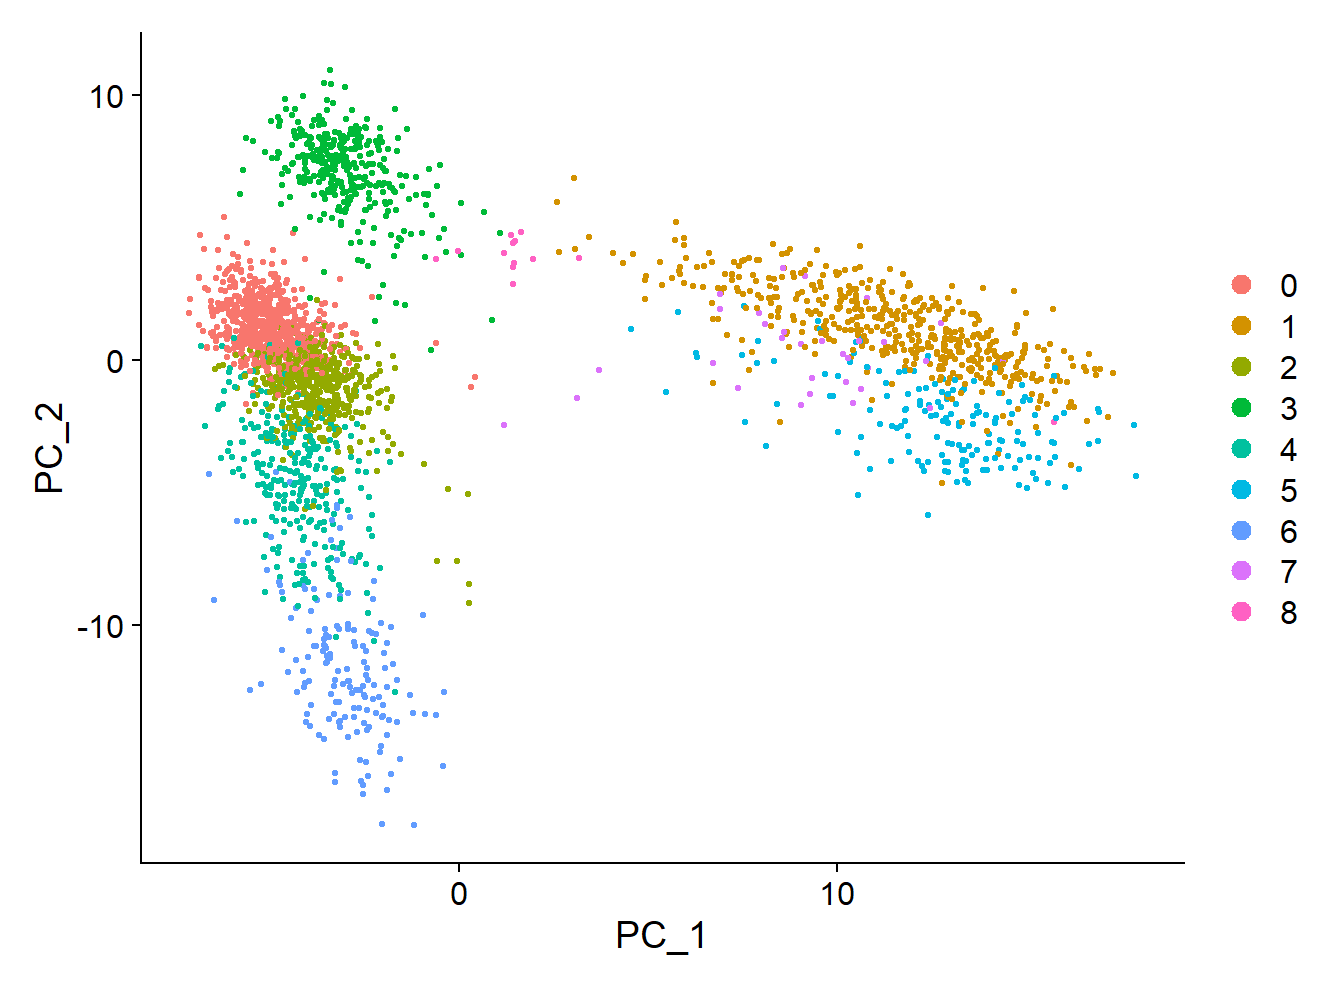
在未经处理的高维数据中,我们想象用一个点来代表一个细胞。在高维空间中,同一种类细胞所代表的点之间的距离就会更近;非同类细胞之间的距离将会更远。依此原理,我们可以通过计算两两细胞间的距离,并根据点与点之间的距离生成一个二维图像。在高维空间中距离相近的两个点,在二维图像中距离也拉近;而在高维空间中距离较远的两个点,在二维图像中距离也会拉远,这就可以更好地反映出不同细胞群的区别。这就是UMAP和$t$-SNE算法的基本原理。
UMAP算法和$t$-SNE算法的思路总体相同,但存在一些细节上的差异。$t$-SNE算法会计算所有点与点之间的距离,并将其转化为$t$分布,结果就是在高维数据中两个距离较近的点,在降维后的数据中距离将会更近;而在高维数据中两个距离较远的点,在降维后的数据中距离也将拉远,会更有利于不同细胞集群的区分;而UMAP算法则只会计算距离某个点最近的$k$个点的距离(很像KNN算法),并且也不会对计算得到的距离进行$t$分布转化,因此通过UMAP算法降维后的图中,两点间距离会更有可比性。
此处以UMAP算法为例进行降维:
1 | pbmc <- RunUMAP(pbmc, dims = 1:10) |
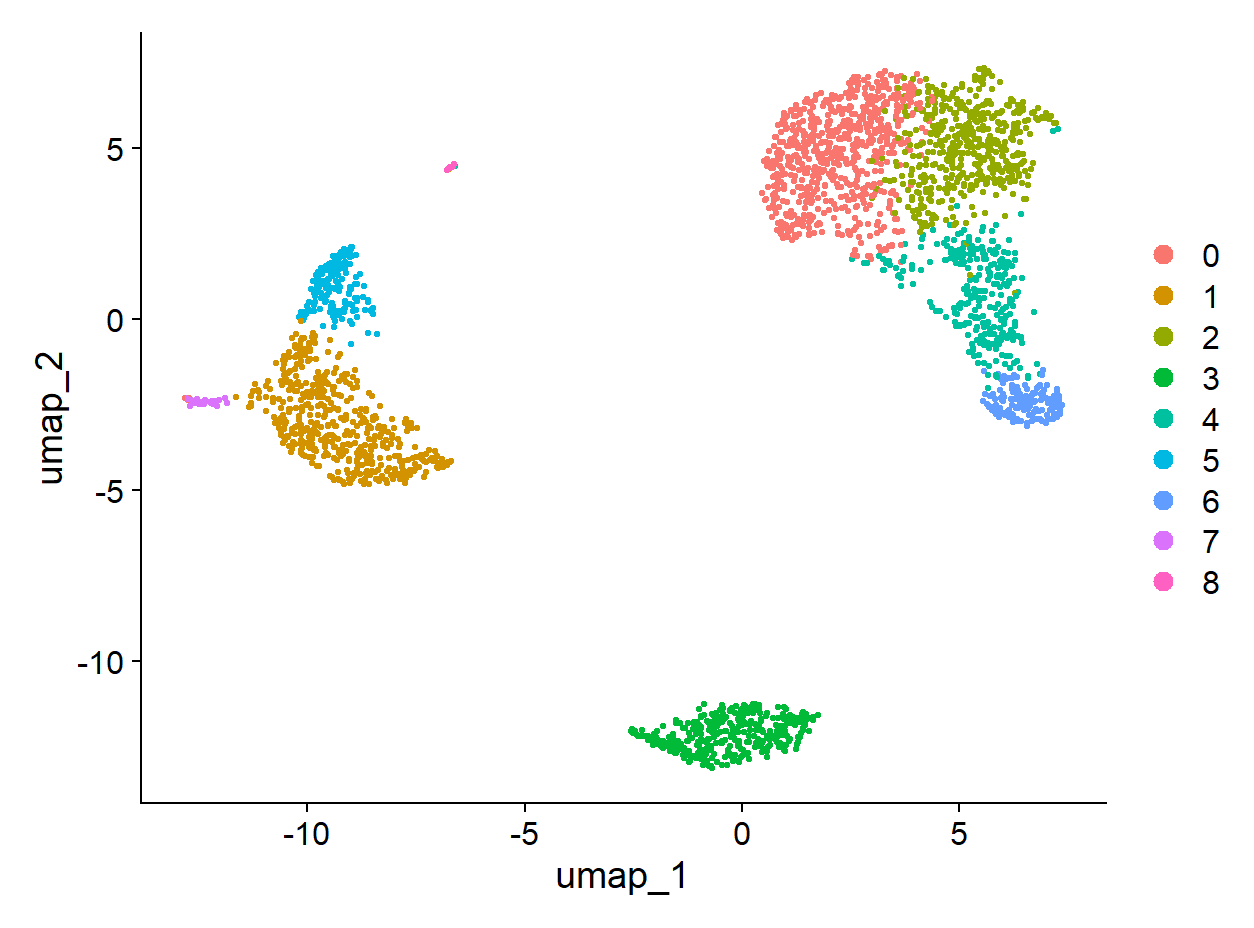
此时可以用下面的代码保存该结果,在需要时不需要重新运行上面的计算(计算量太大了……)。
1 | #检查output目录是否存在,若不存在则创建 |
鉴定差异表达基因(DEGs)
Seurat包可以通过差异表达分析寻找不同细胞簇之间的表达基因,默认情况下其将会寻找所有上调和下调的基因。FindAllMarkers()函数会对所有细胞集群自动进行差异表达分析,我们也可以利用FindMarkers()函数对特定的细胞集群寻找。
1 | cluster2.markers <- FindMarkers(pbmc, ident.1 = 2) #和其他所有细胞簇进行对比,寻找细胞簇2的差异表达基因 |
- 运行结果
1 | > head(cluster2.markers, n = 5) |
- 结果解读:
- p_val:原始p值(未校正的多重假设检验结果)
- avg_log2FC:目标细胞簇与其他细胞簇的平均log2倍变化(正值表示上调)
- pct.1:目标细胞簇中表达该基因的细胞比例
- pct.2:其他细胞簇中表达该基因的细胞比例
- p_val_adj:(利用Bonferroni或BH方法)校正后的p值
1 | cluster5.markers <- FindMarkers(pbmc, ident.1 = 5, ident.2 = c(0, 3)) #和细胞簇0和细胞簇3对比,寻找细胞簇5的差异基因 |
- 运行结果
1 | > head(cluster5.markers, n = 5) |
1 | #和其他细胞簇对比,寻找每一个细胞簇的标志基因(设置仅寻找上调基因) |
- 运行结果
1 | > pbmc.markers %>% |
利用ROC检验,可以筛选出有统计学意义且生物学意义显著的差异表达基因。
1 | cluster0.markers <- FindMarkers(pbmc, ident.1 = 0, logfc.threshold = 0.25, test.use = "roc", only.pos = TRUE) |
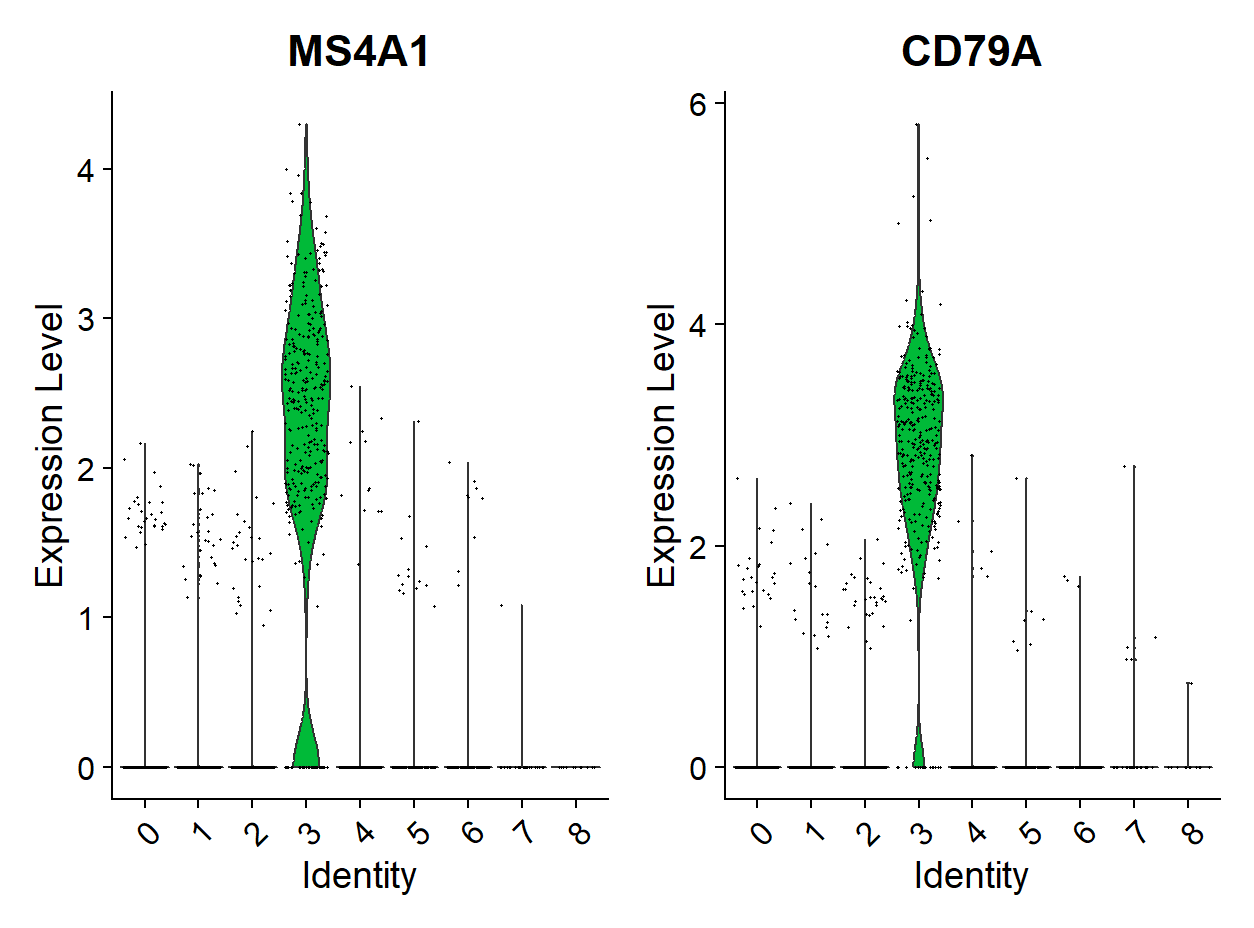
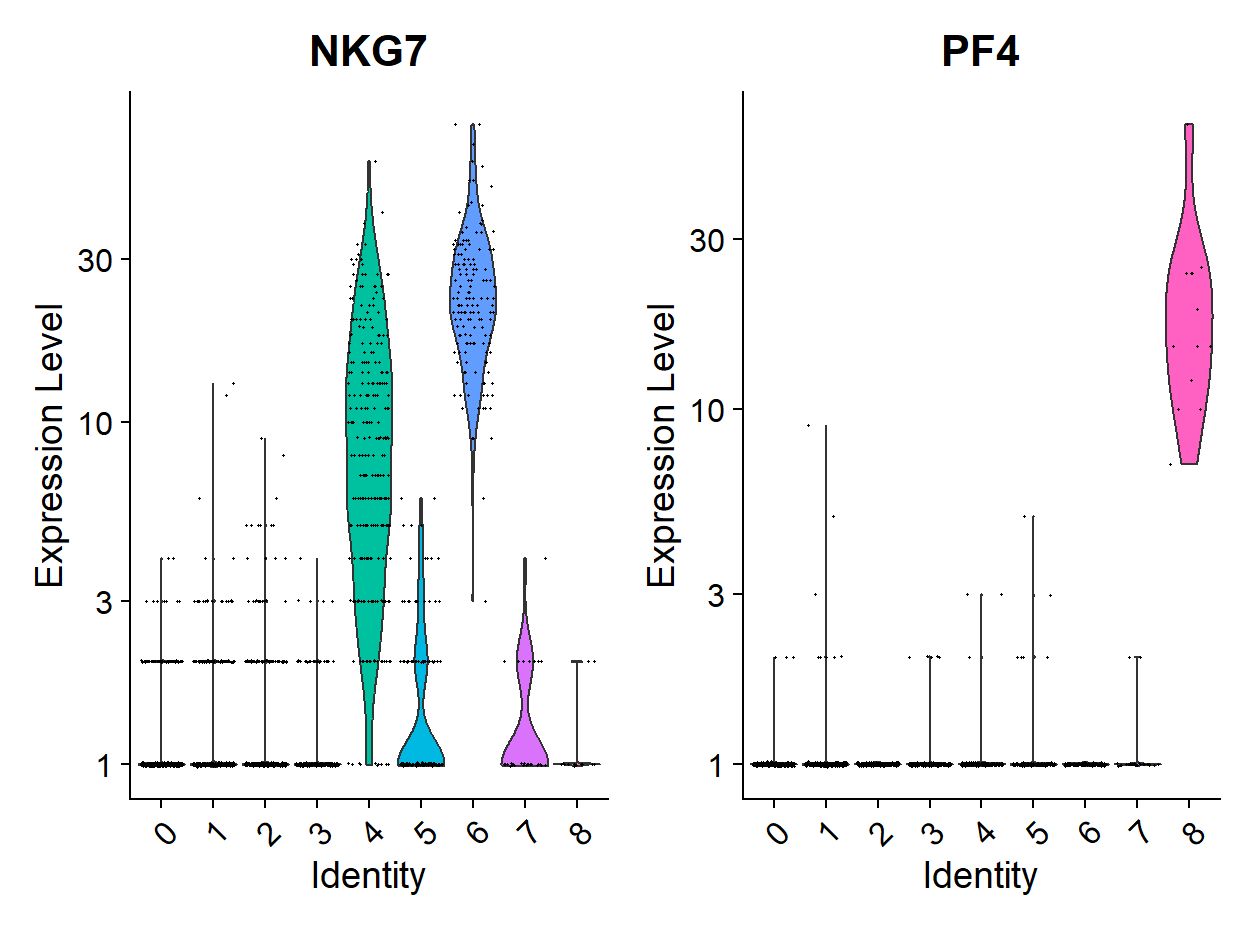
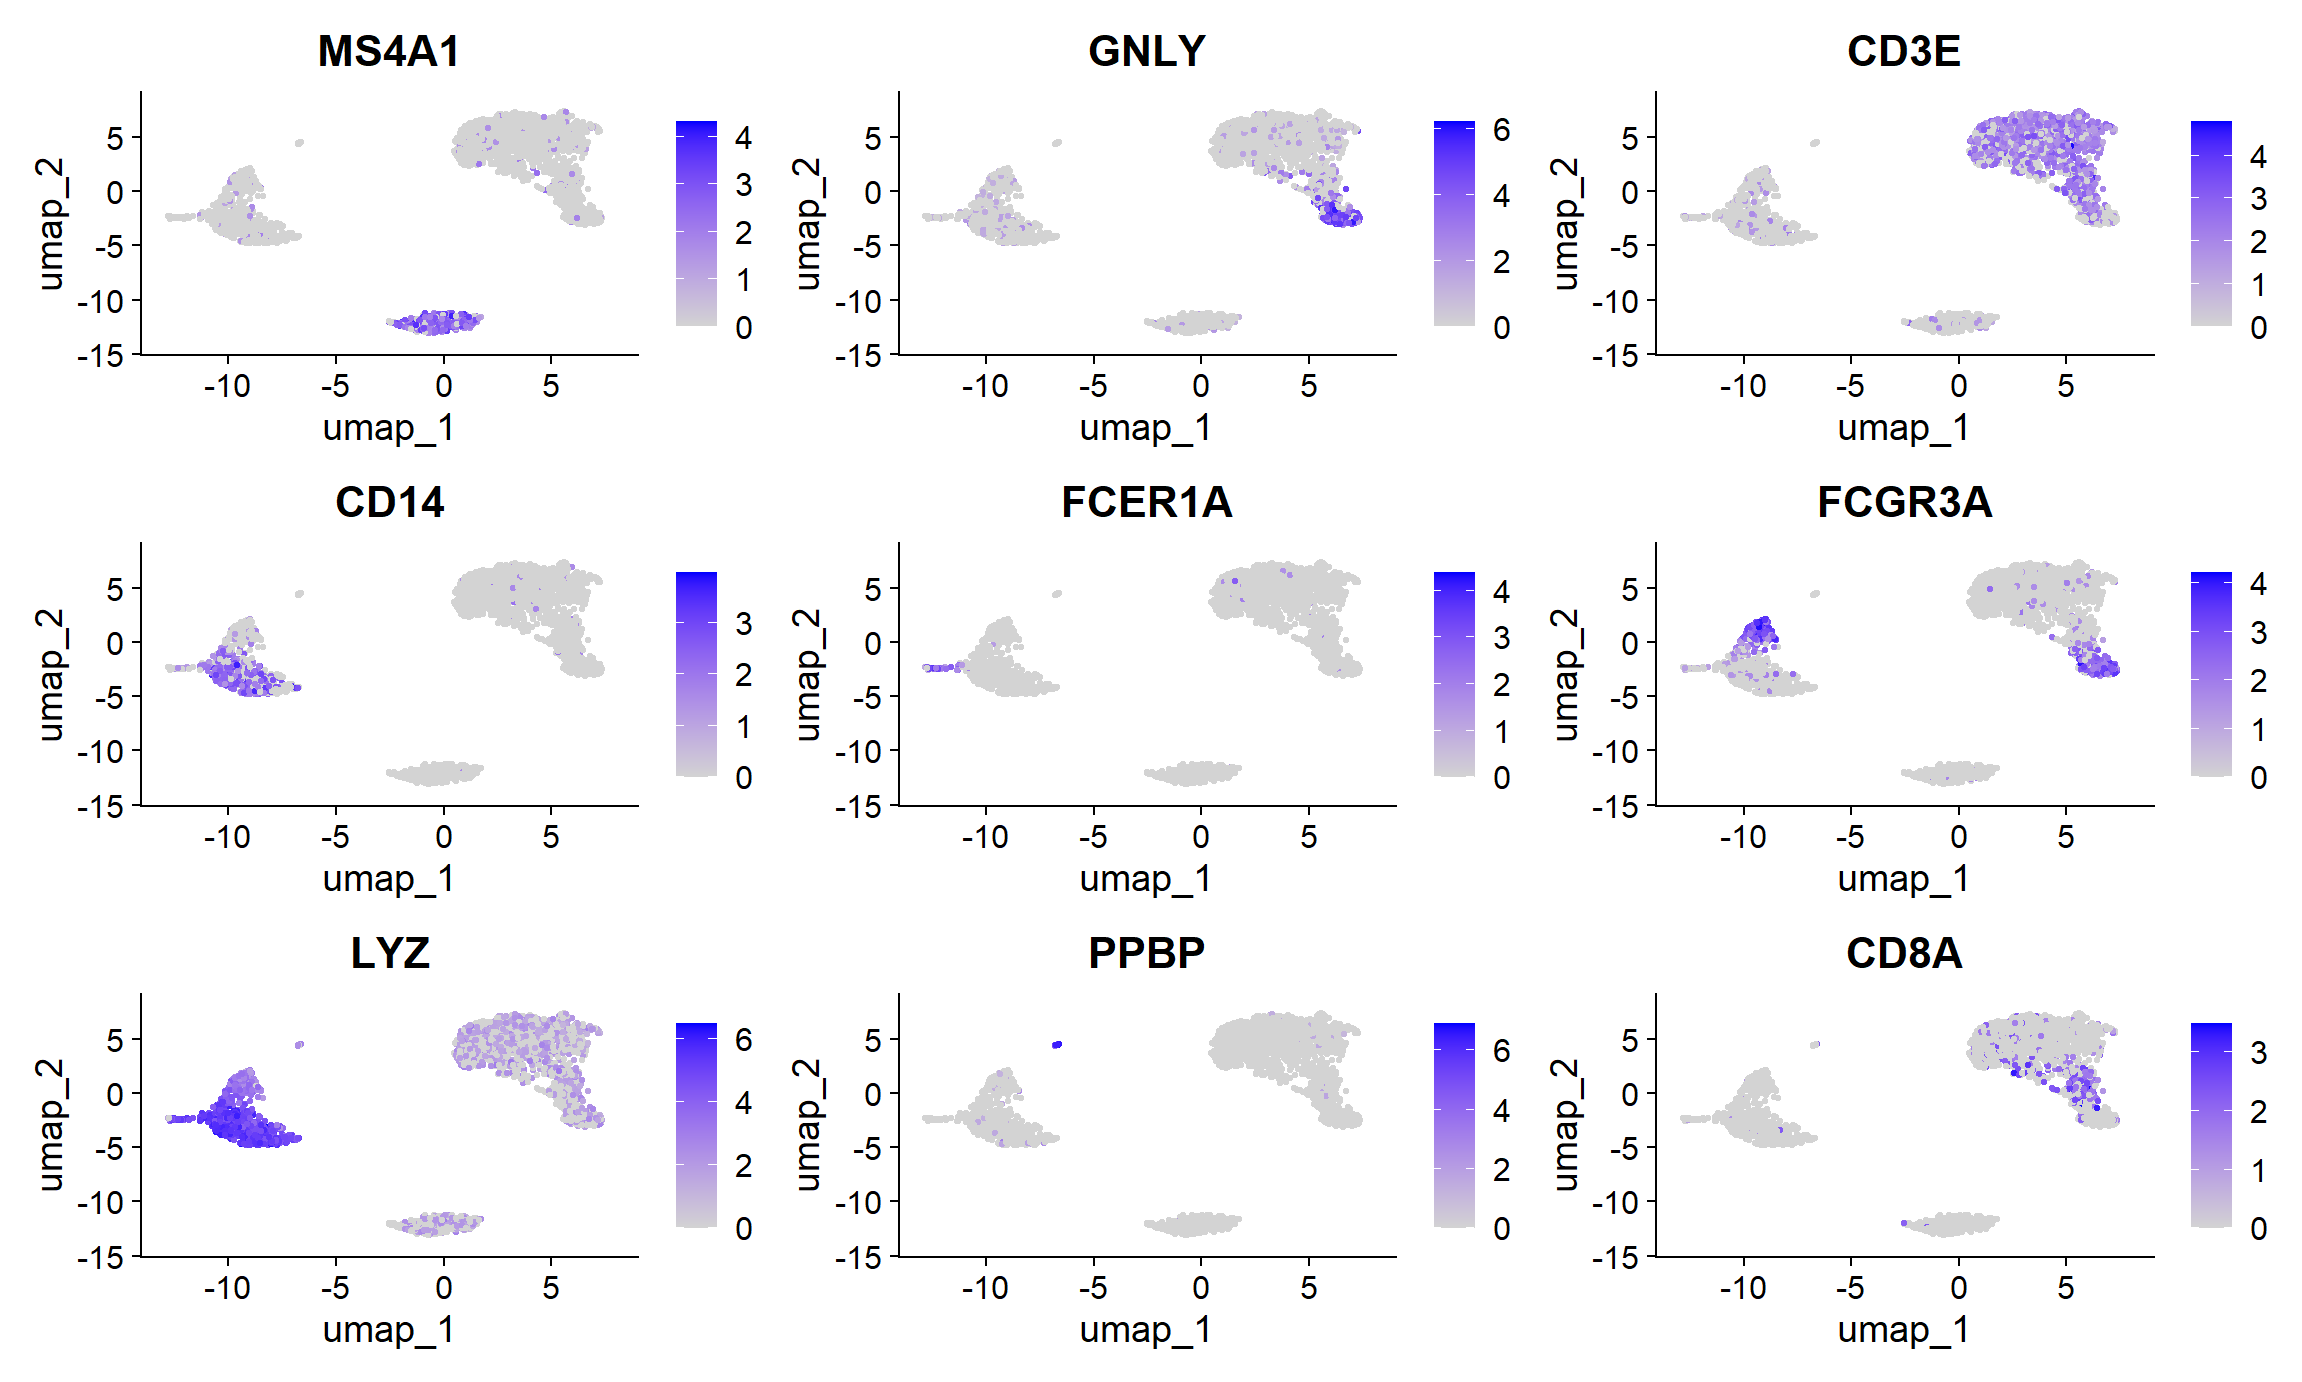
我们可以用VinPlot()函数和FeaturePlot()函数来使得差异基因可视化。其中前者可以显示某个或某些基因在不同细胞集群的表达概率分布,后者可以在PCA或UMAP图上可视化表达特征基因。
1 | VlnPlot(pbmc, features = c("MS4A1", "CD79A")) |
1 | VlnPlot(pbmc, features = c("NKG7", "PF4"), slot = "counts", log = TRUE) |
1 | FeaturePlot(pbmc, features = c("MS4A1", "GNLY", "CD3E", "CD14", "FCER1A", "FCGR3A", "LYZ", "PPBP", "CD8A")) |
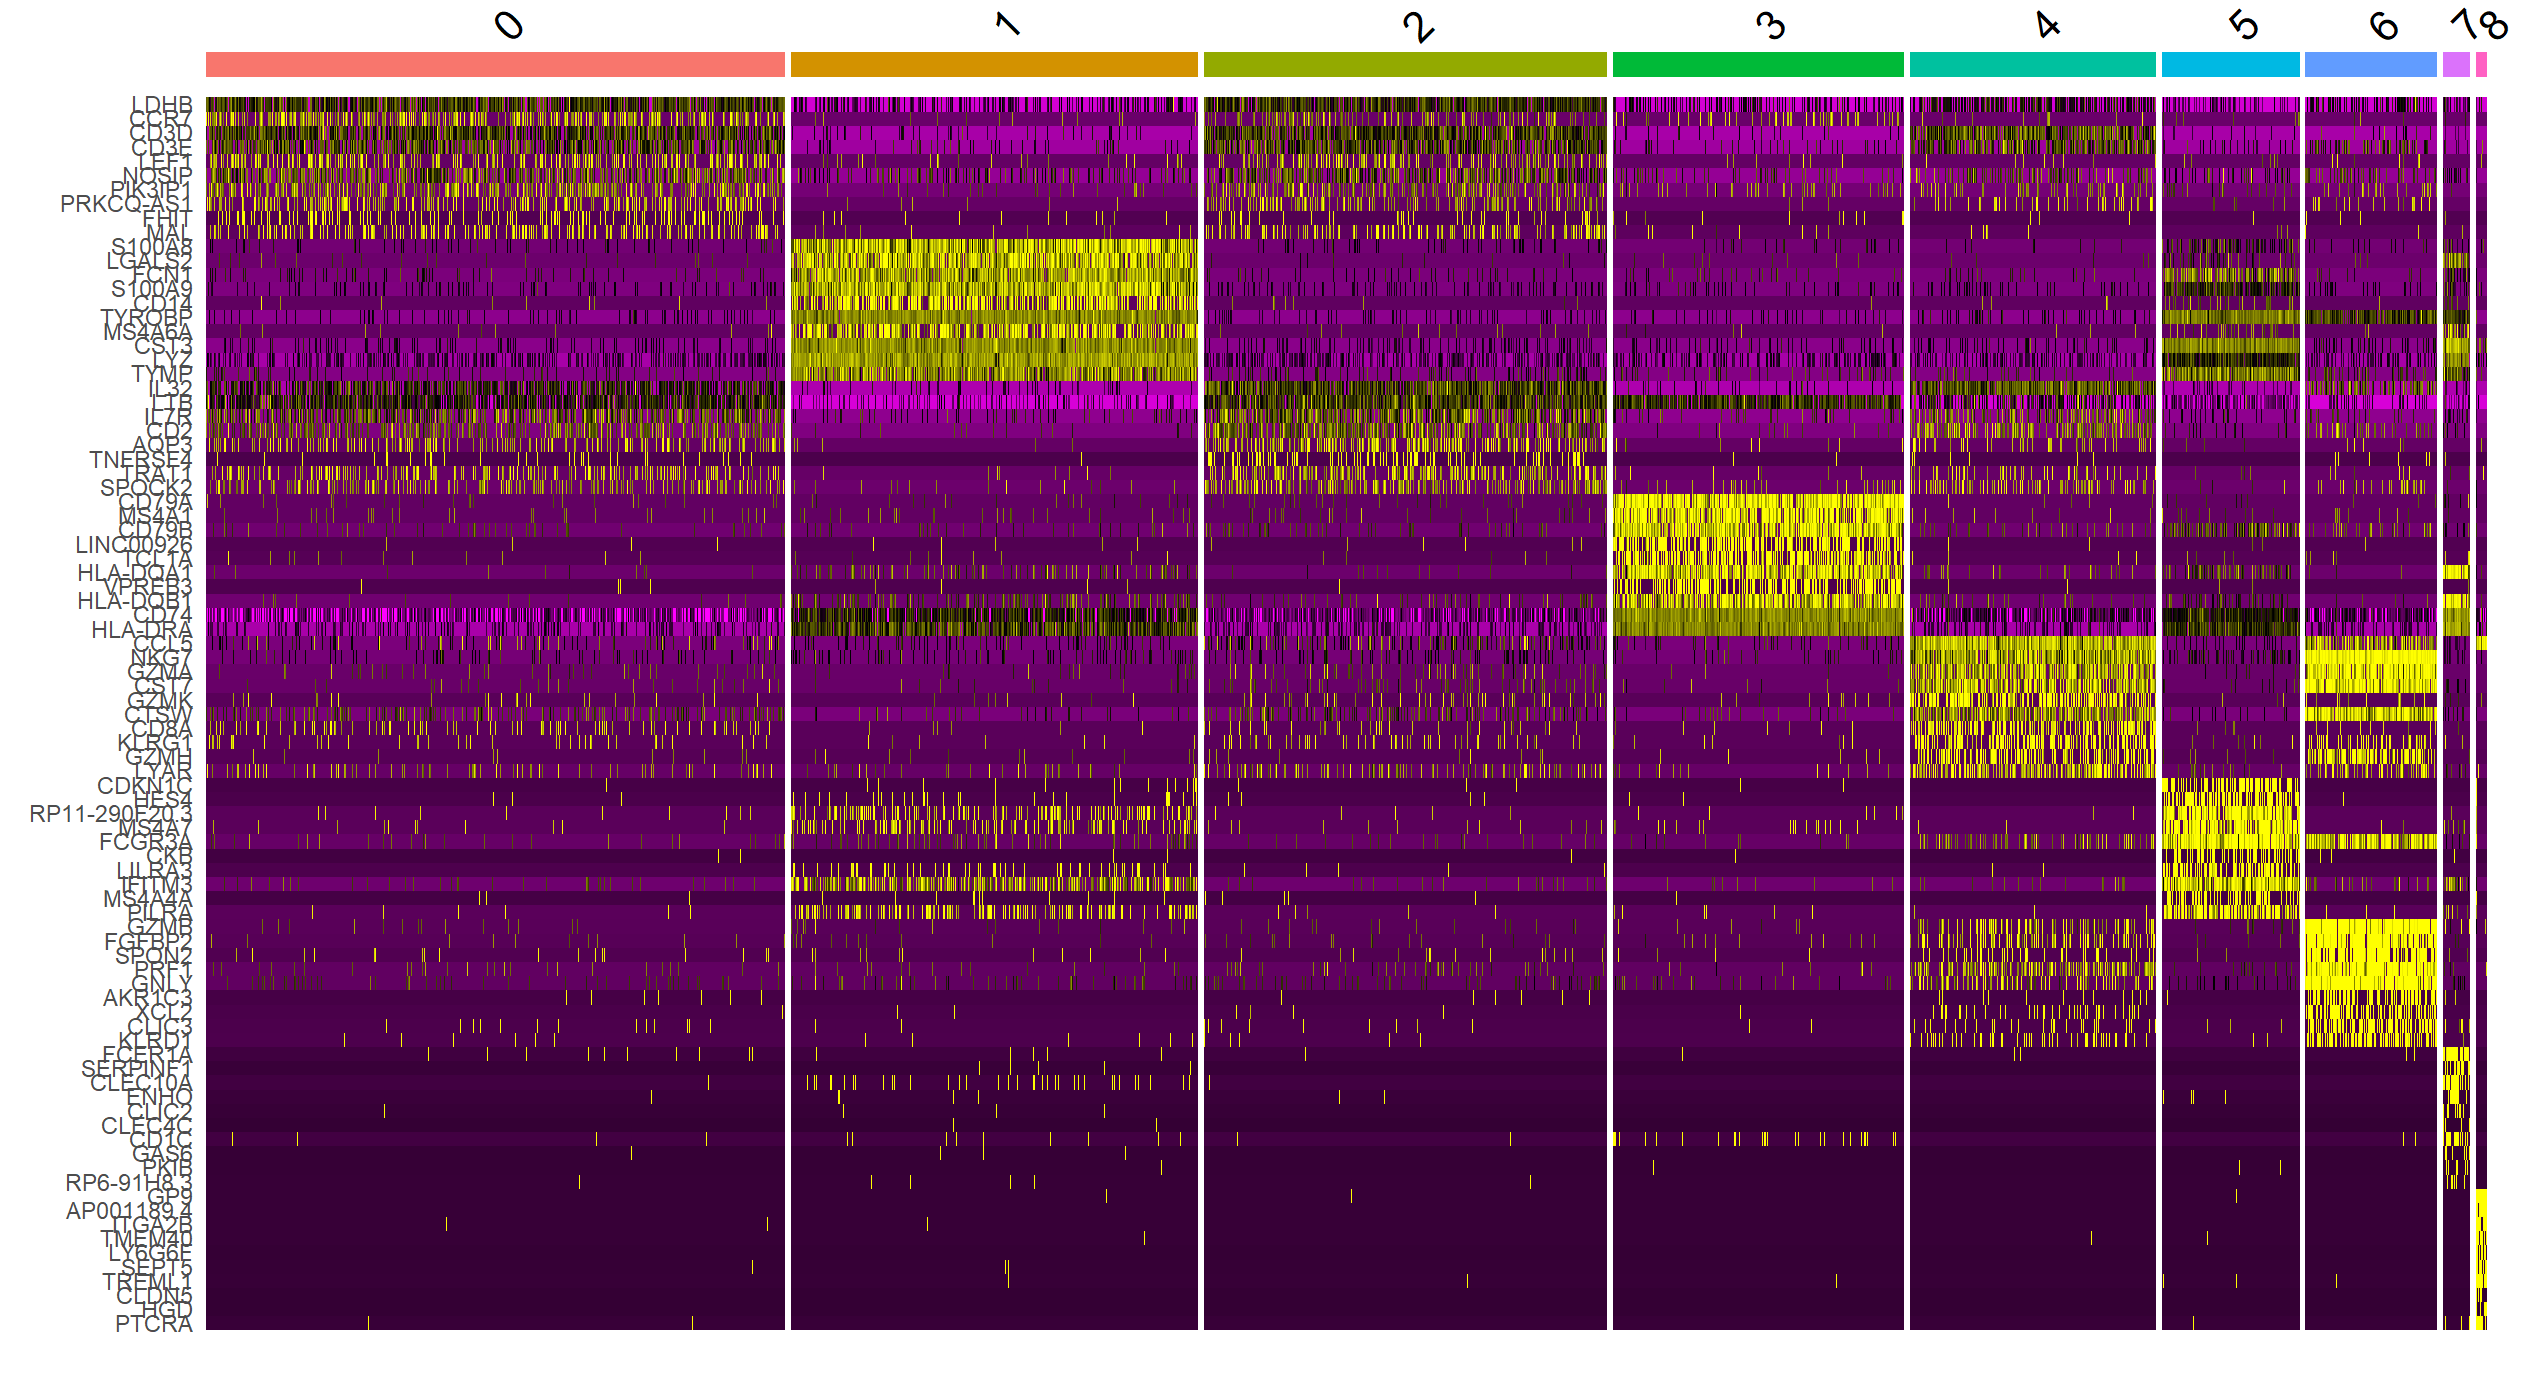
通过DoHeatmap()函数,我们可以生成一个不同细胞簇标志基因在所有细胞簇表达水平差异的热图。
1 | pbmc.markers %>% |
注释细胞类型
在上一步中,我们发掘出了每一个细胞簇的标志基因。基于现有的研究成果,我们可以将标志基因和细胞类型对应起来(如下表),然后给我们的图象进行标注。
| 细胞簇 | 标志基因 | 细胞类型 |
|---|---|---|
| 0 | IL7R, CCR7 | Naive CD4+ T |
| 1 | CD14, LYZ | CD14+ Mono |
| 2 | IL7R, S100A4 | Memory CD4+ |
| 3 | MS4A1 | B |
| 4 | CD8A | CD8+ T |
| 5 | FCGR3A, MS4A7 | FCGR3A+ Mono |
| 6 | GNLY, NKG7 | NK |
| 7 | FCER1A, CST3 | DC |
| 8 | PPBP | Platelet |
1 | new.cluster.ids <- c("Naive CD4 T", "CD14+ Mono", "Memory CD4 T", "B", "CD8 T", "FCGR3A+ Mono", "NK", "DC", "Platelet") |
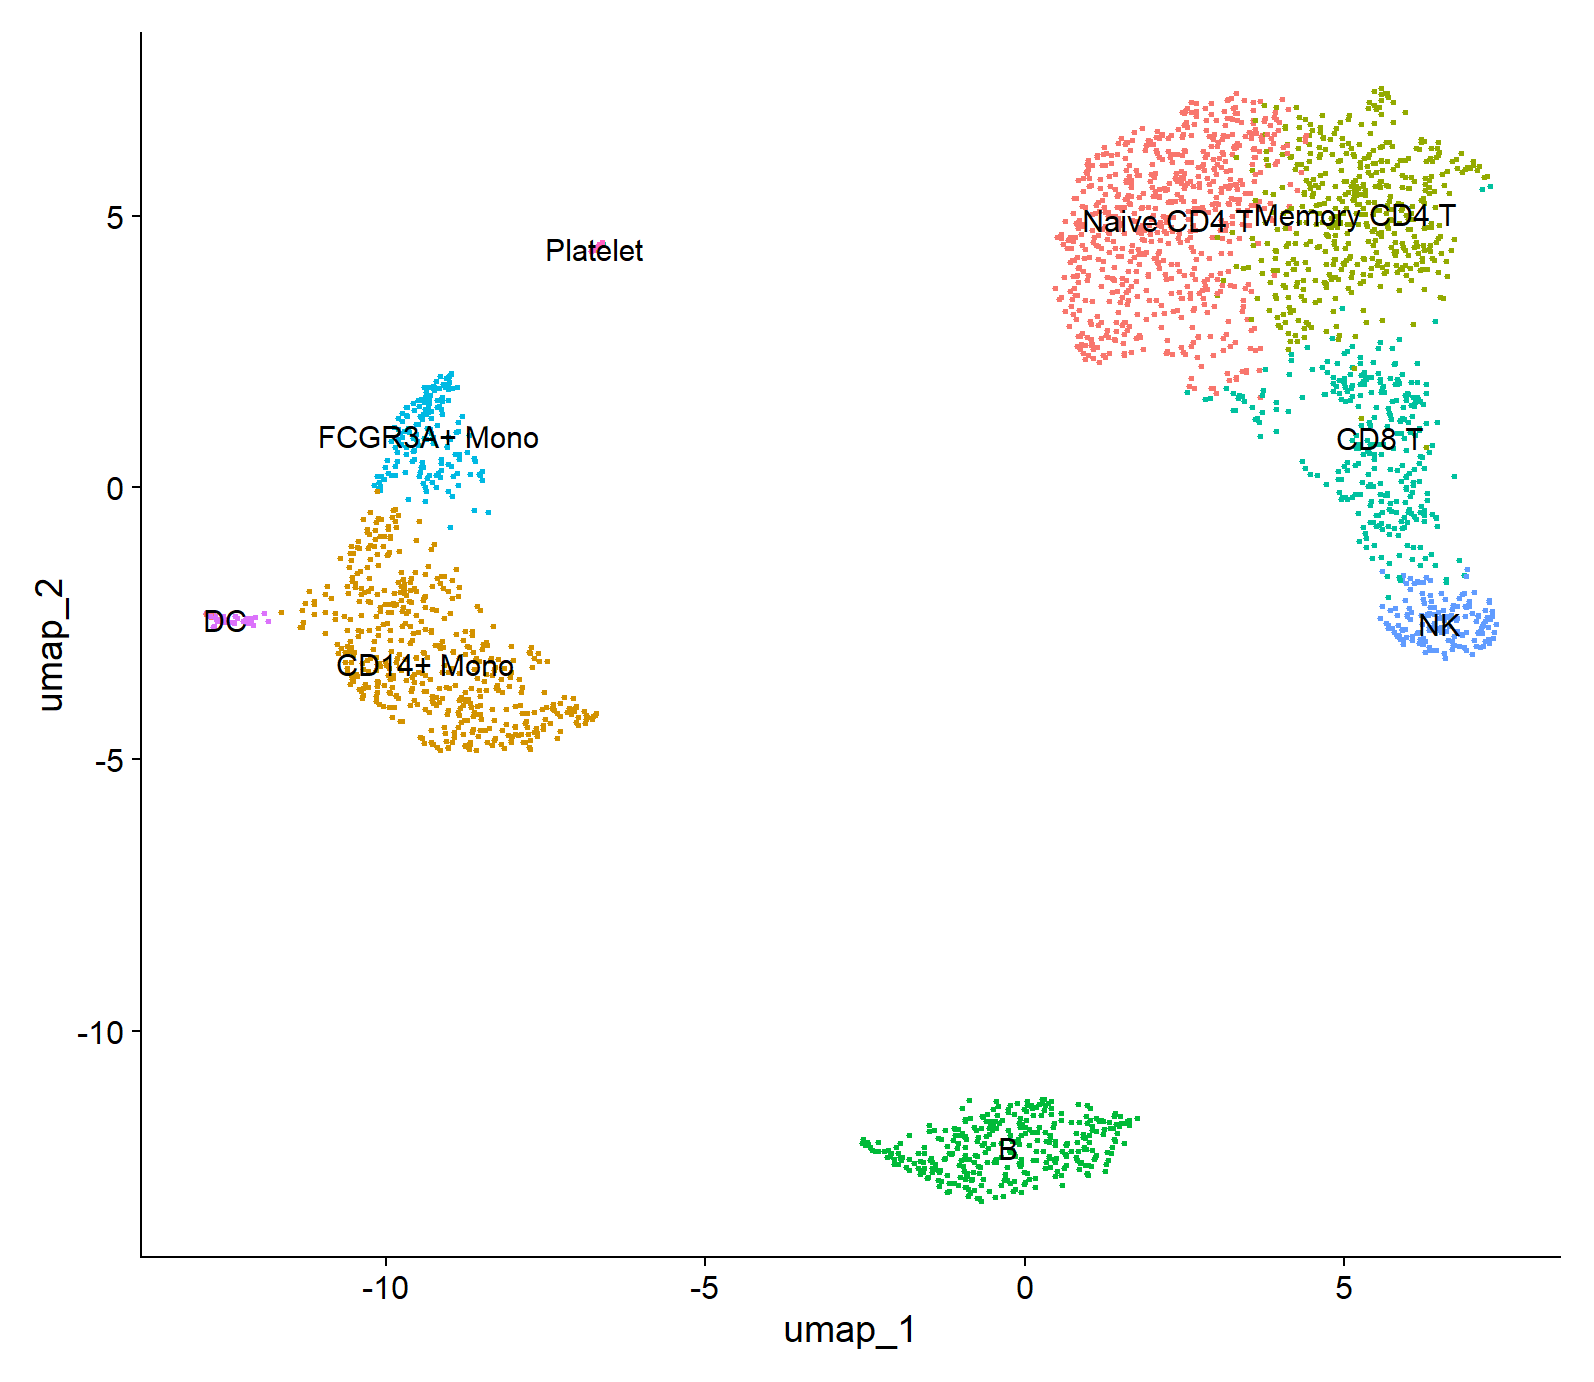
导出最终的图片:
1 | #install.packages("ggplot2") |
保存运算结果:
1 | saveRDS(pbmc, file = "C:/Users/86150/Downloads/pbmc3k_filtered_gene_bc_matrices/output/pbmc3k_final.rds") |
下班收工!!
完整代码
1 | #install.packages("dplyr") |
Nahida
也许是各种学习小记的集合。
正在播放1 / 2