在这篇教程中,我们会沿用上一篇教程处理好的数据来进行演示。

先做一些前期准备,安装并加载好R包,下载并加载好数据(或者直接运用上一篇教程中处理好的数据)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
install.packages(c("Seurat","patchwork","ggplot2","SeuratData"))

#下载SeuratData包时报错显示:package ‘SeuratData’ is not available for this version of R
#根据网络上给出的解决措施,改用下面的方法下载该R包
install.packages("remotes")
remotes::install_github("satijalab/seurat-data")
#运行后在下方Console栏中输入1并回车

library(Seurat)
library(patchwork)
library(ggplot2)
library(SeuratData)
SeuratData::InstallData("pbmc3k")

pbmc3k.final <- LoadData("pbmc3k", type = "pbmc3k.final") #加载处理后的数据集
pbmc3k.final$groups <- sample(c("group1", "group2"), size = ncol(pbmc3k.final), replace = TRUE)
#将所有细胞随机分为两组,模拟实验中的不同处理条件
#nol()用于获取细胞的数量(列数)
#sample()函数用于生成随机的分组标签,replace=true表示可以重复分发分组标签
#这里的分组仅为方便教学使用,没有生物学意义
features <- c("LYZ", "CCL5", "IL32", "PTPRCAP", "FCGR3A", "PF4")
pbmc3k.final
  • 运行结果
1
2
3
4
5
An object of class Seurat 
13714 features across 2638 samples within 1 assay
Active assay: RNA (13714 features, 2000 variable features)
3 layers present: data, counts, scale.data
2 dimensional reductions calculated: pca, umap

五种可视化标志基因的方法

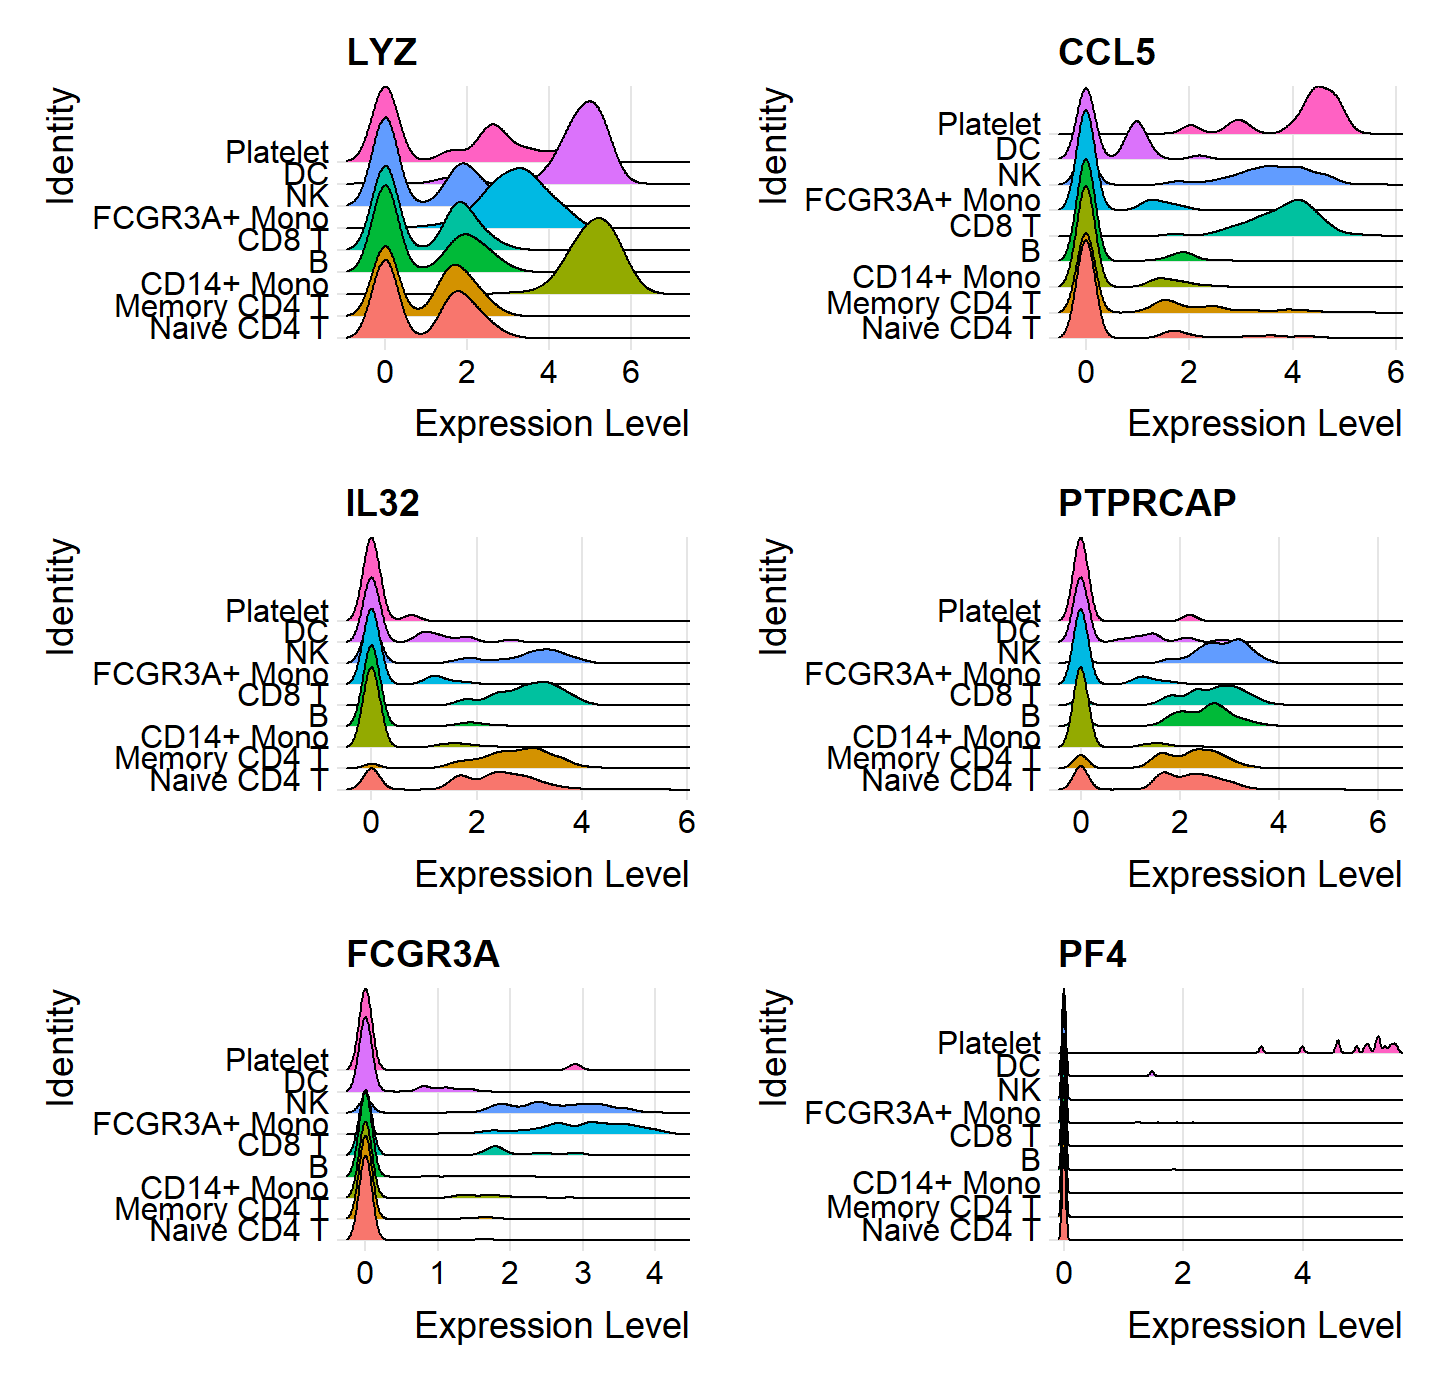
山脊图(Ridge Plots)

山脊图可以反映在细胞集群中,某个基因的大体表达分布。

1
2
RidgePlot(pbmc3k.final, features = features, ncol = 2)
#ncol为列数的意思,也就是设置生成的图为两列。

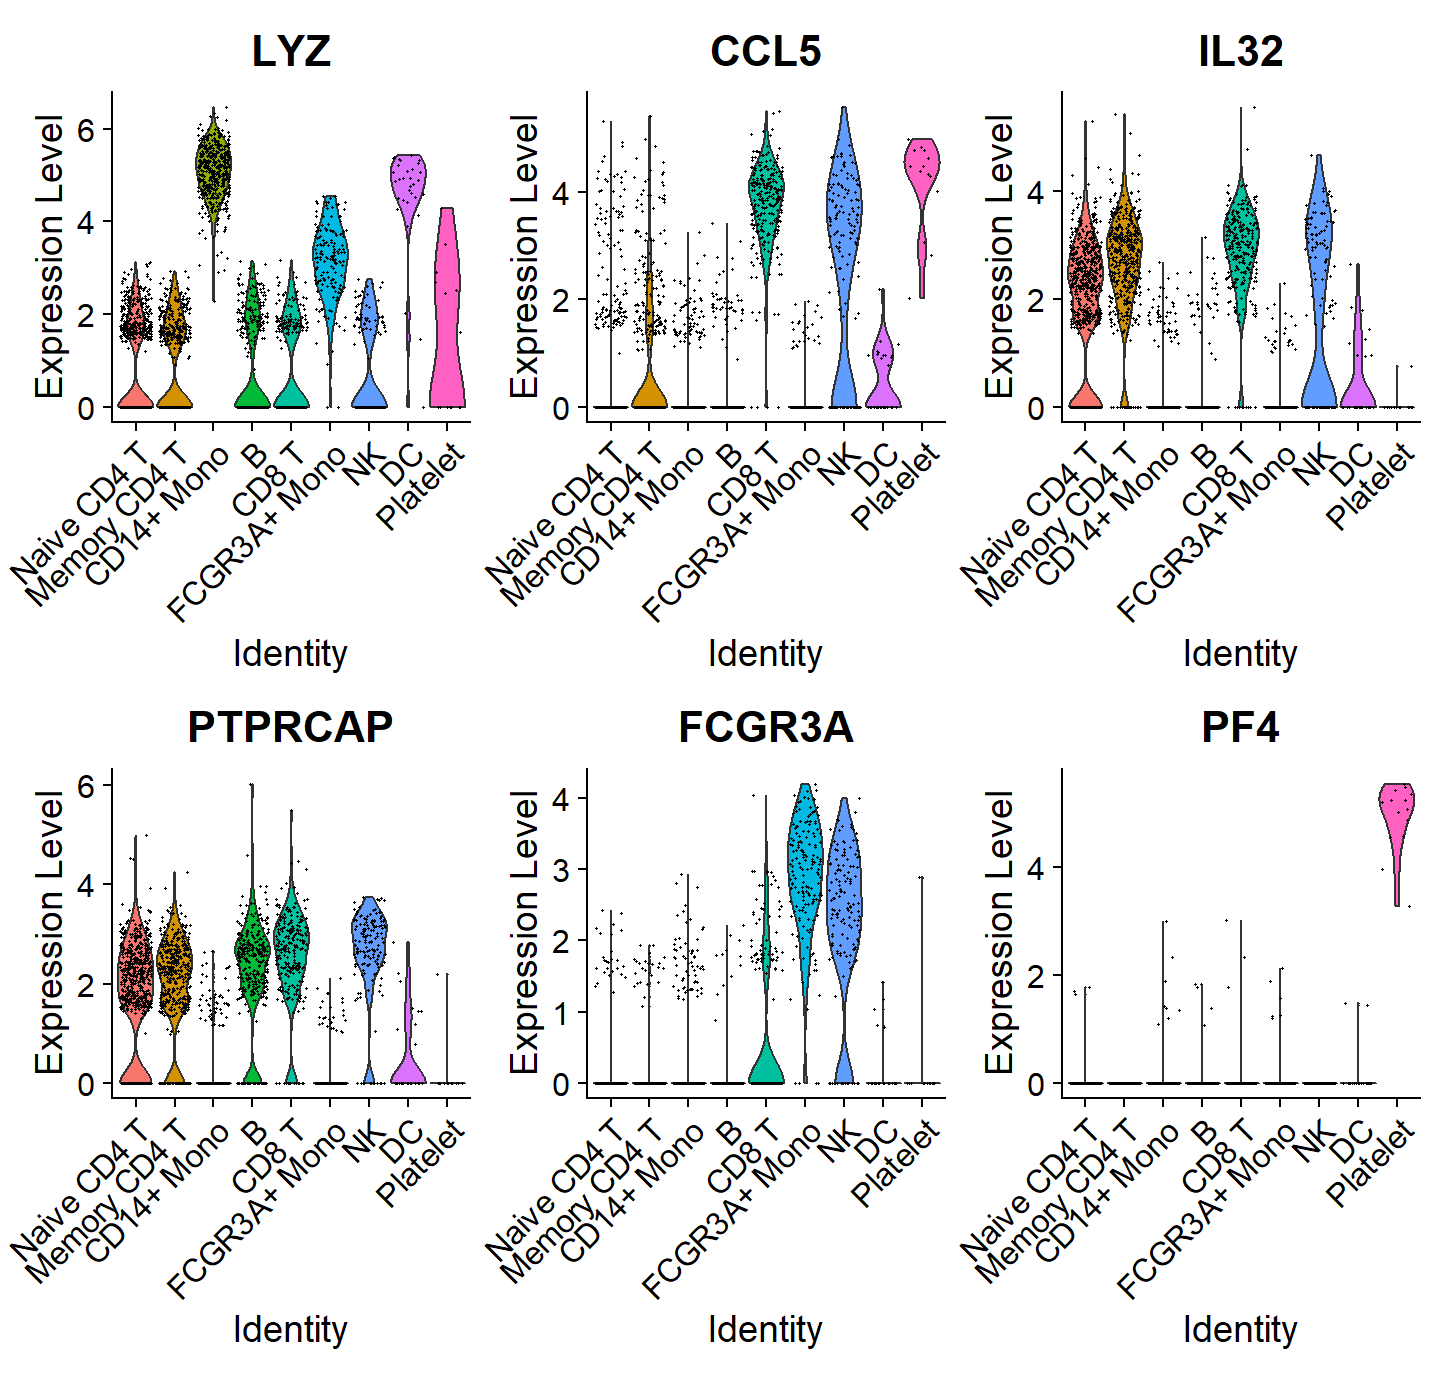
小提琴图(Violin Plots)

意义同上。

1
VlnPlot(pbmc3k.final, features = features)

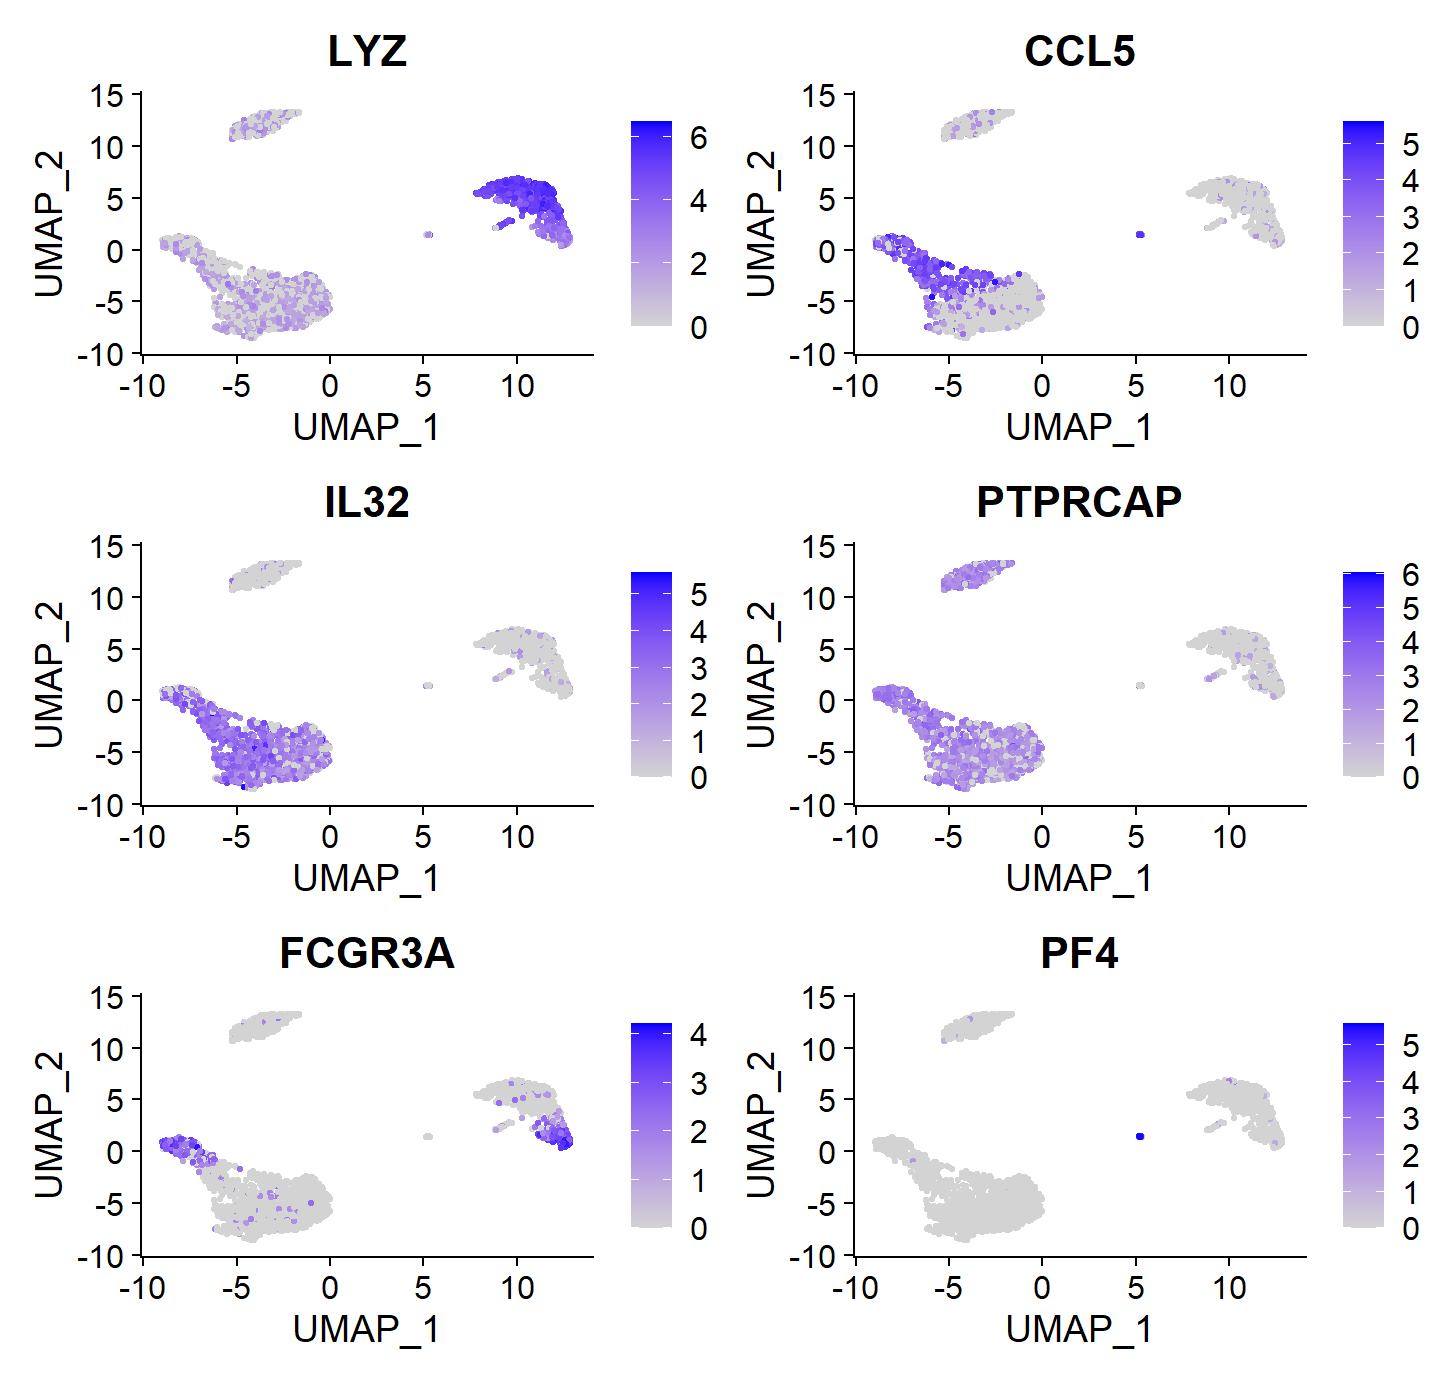
特征图(Feature Plots)

可以在降维后的图象中展示不同基因的表达情况。

1
FeaturePlot(pbmc3k.final, features = features)

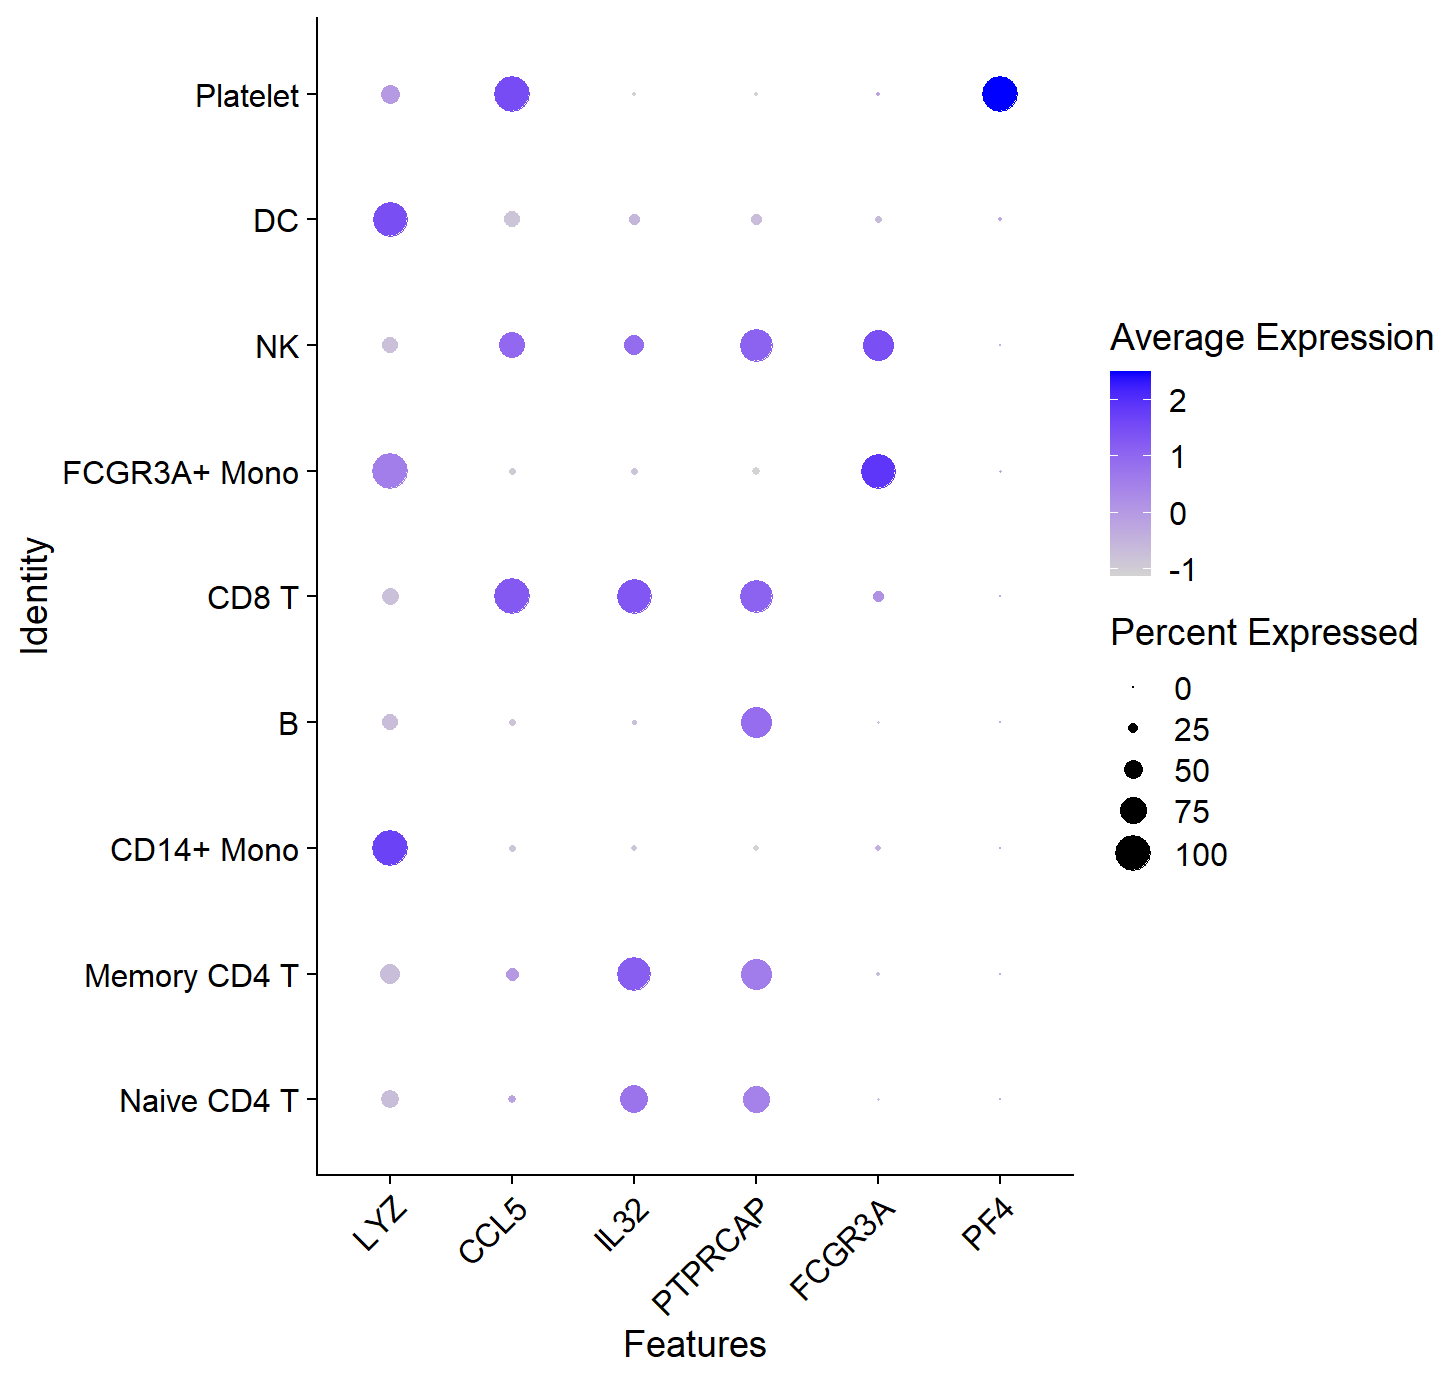
点图(Dot Plots)

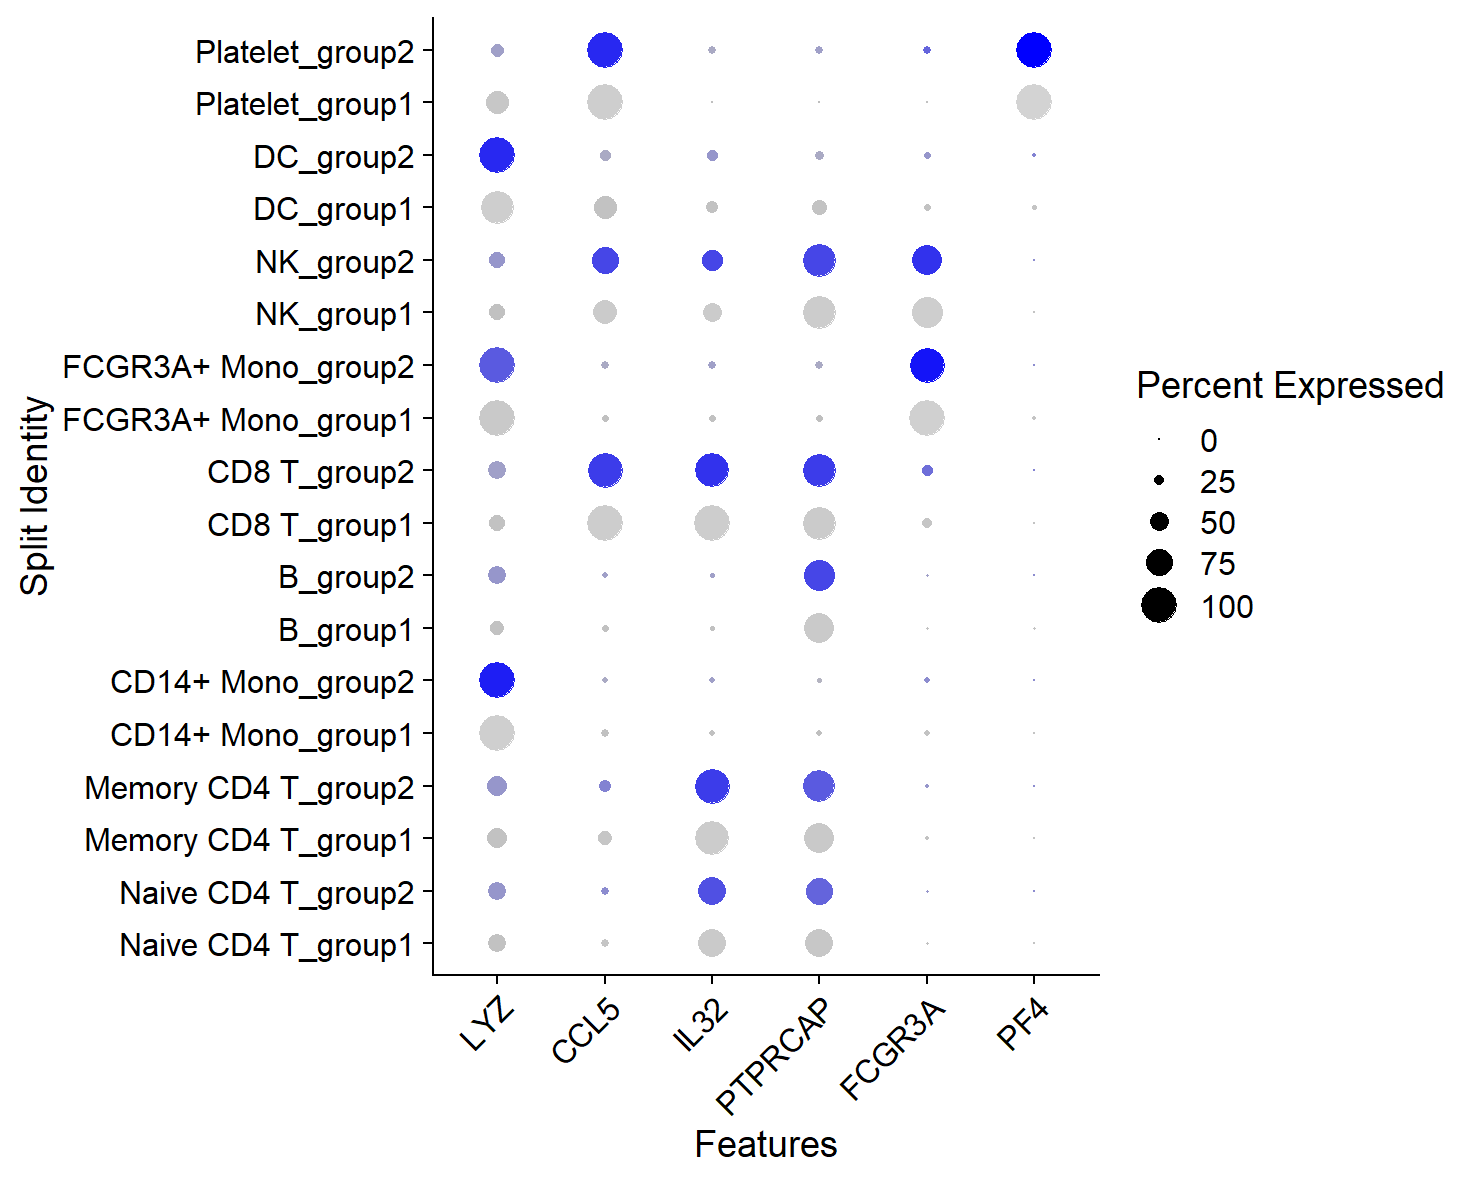
在点图中,点的大小表示在细胞集群中,表达某个基因的细胞所占比例;而点的颜色深浅则代表在细胞集群中,某个基因的平均表达水平。

1
2
DotPlot(pbmc3k.final, features = features) + RotatedAxis()
#RotatedAxis()可以使得坐标轴标签旋转一定角度,防止坐标轴上的标签出现重叠的情况。

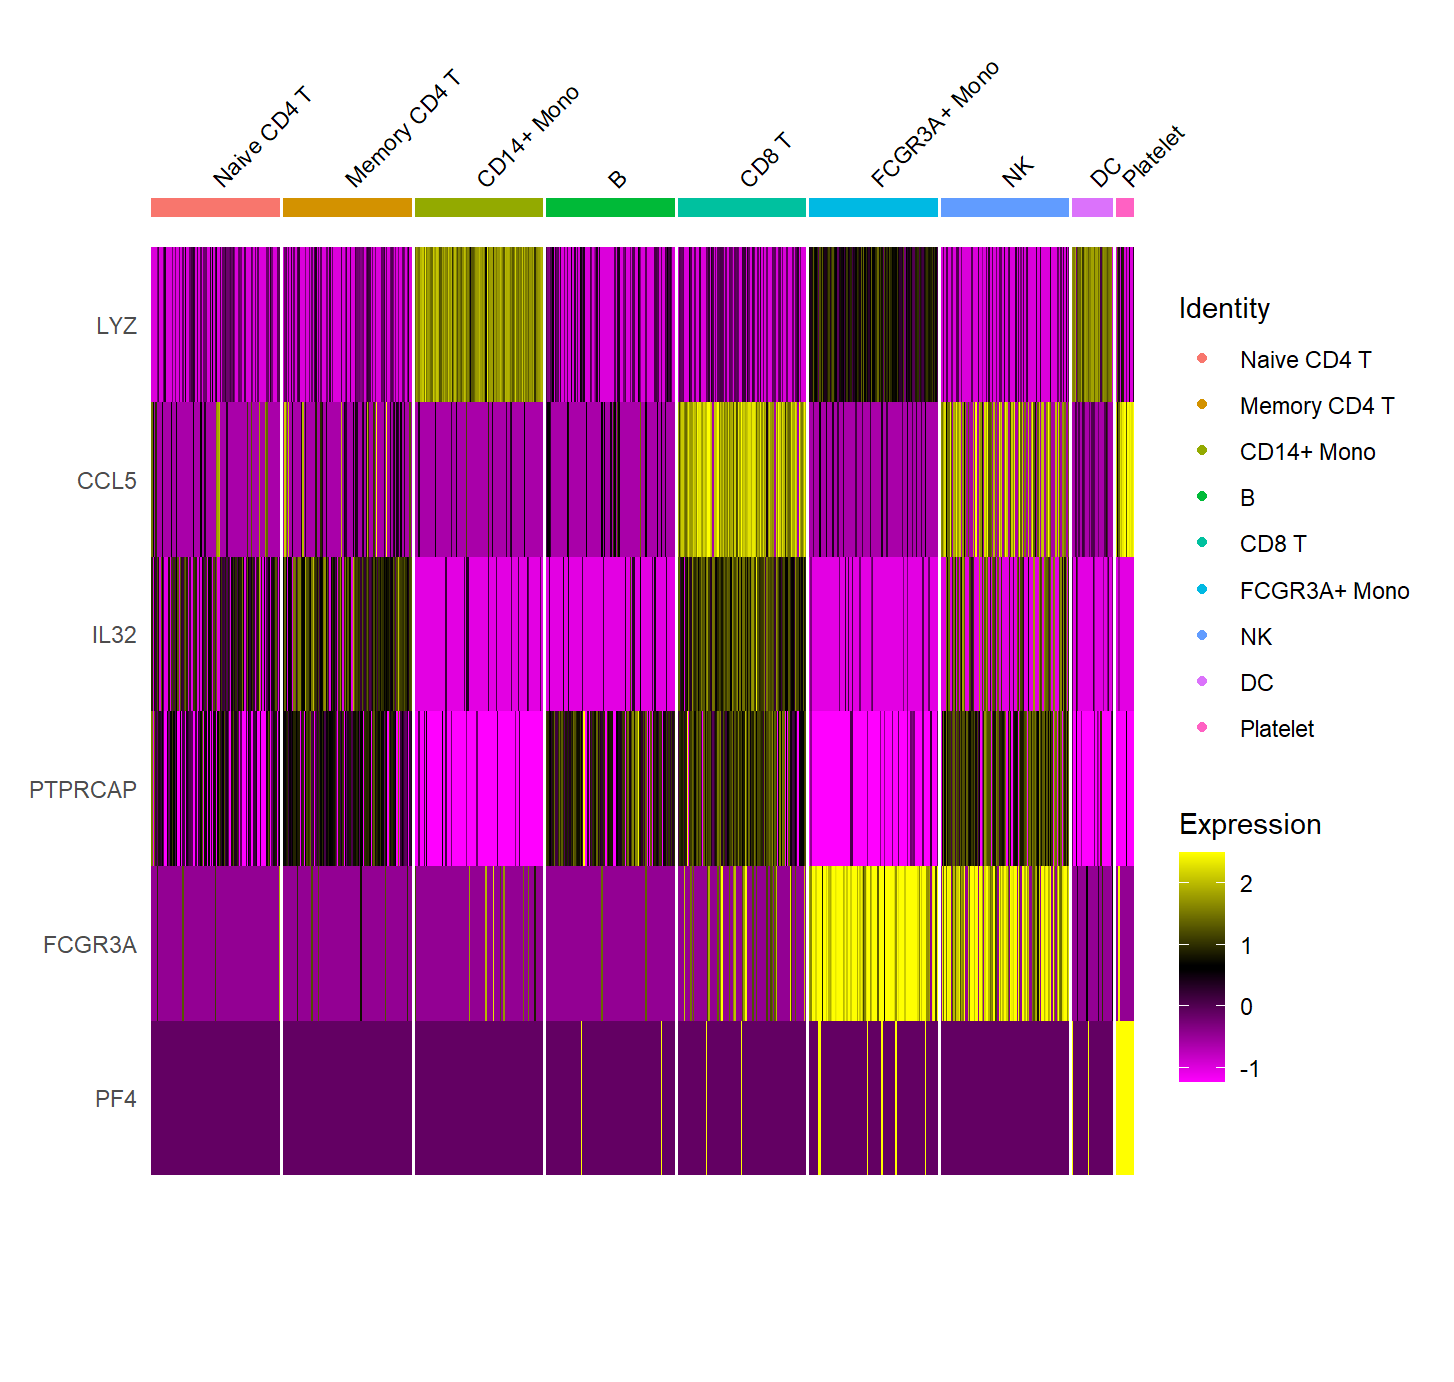
热图(Heatmap)

1
2
3
DoHeatmap(subset(pbmc3k.final, downsample = 100), features = features, size = 3)
#subset()函数可以从每个细胞集群中选择100个细胞进行展示,避免图象过于密集难以阅读。
#选择细胞的数量可以通过downsample这一参数进行调整。

在特征图上玩点新花样

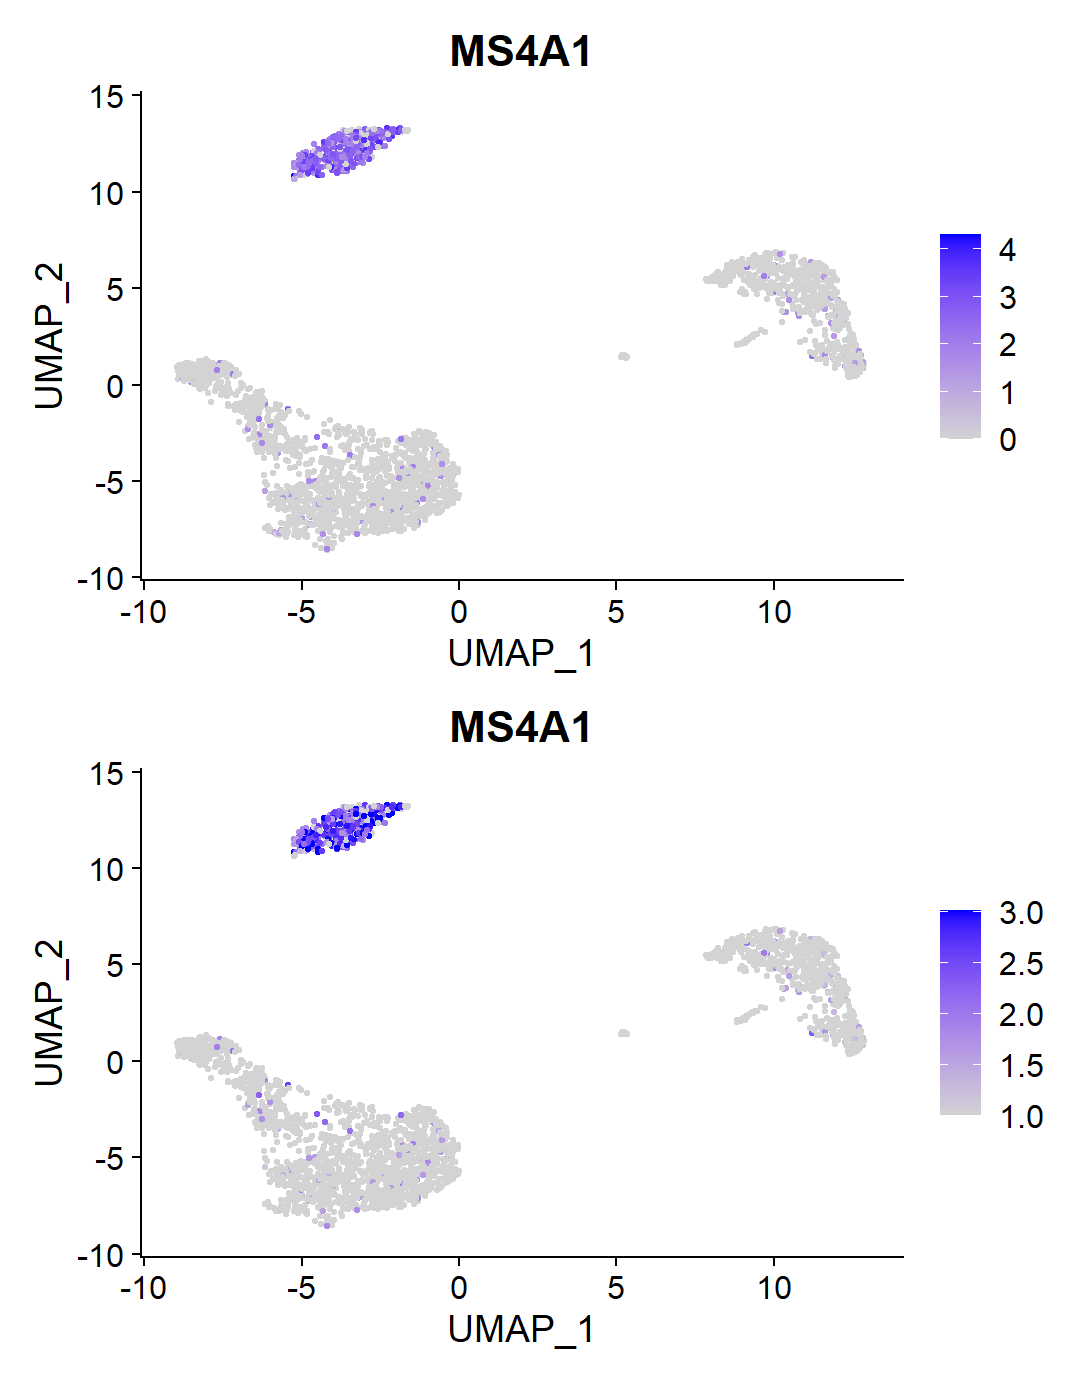
我们可以经验性地设定颜色最深或最浅所代表的基因表达水平。

1
2
FeaturePlot(pbmc3k.final, features = "MS4A1") + FeaturePlot(pbmc3k.final, features = "MS4A1", min.cutoff = 1, max.cutoff = 3)
#上图为原始图象,下图为调整后的图象。

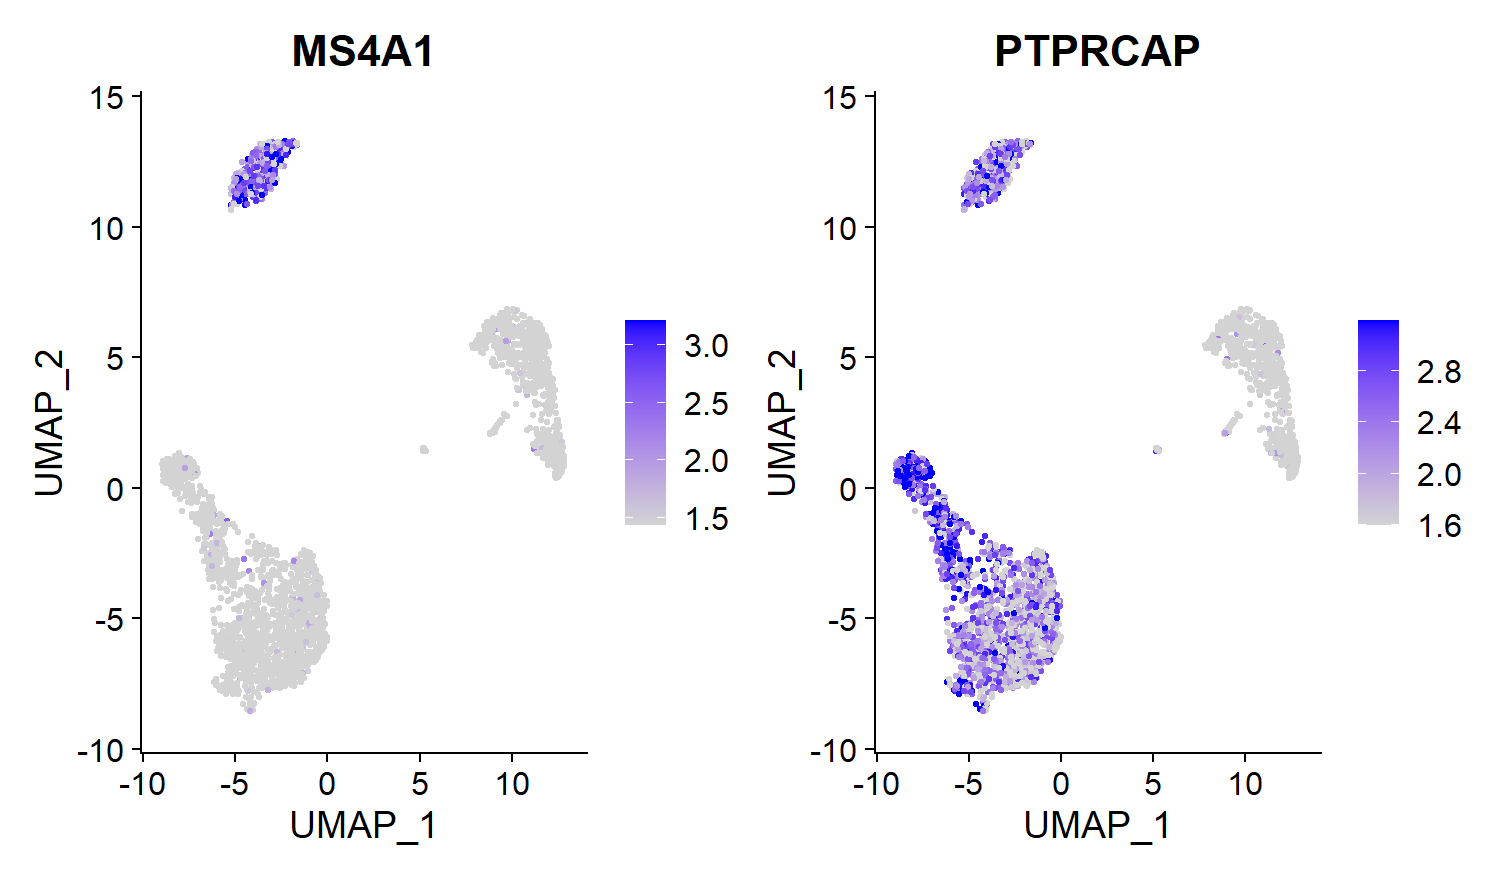
也可以让软件计算第10百分位数(q10)和第90百分位数(q90),以此作为颜色显示的基准。这种方法特别适用于需要处理多个基因的数据的时候。

1
FeaturePlot(pbmc3k.final, features = c("MS4A1", "PTPRCAP"), min.cutoff = "q10", max.cutoff = "q90")

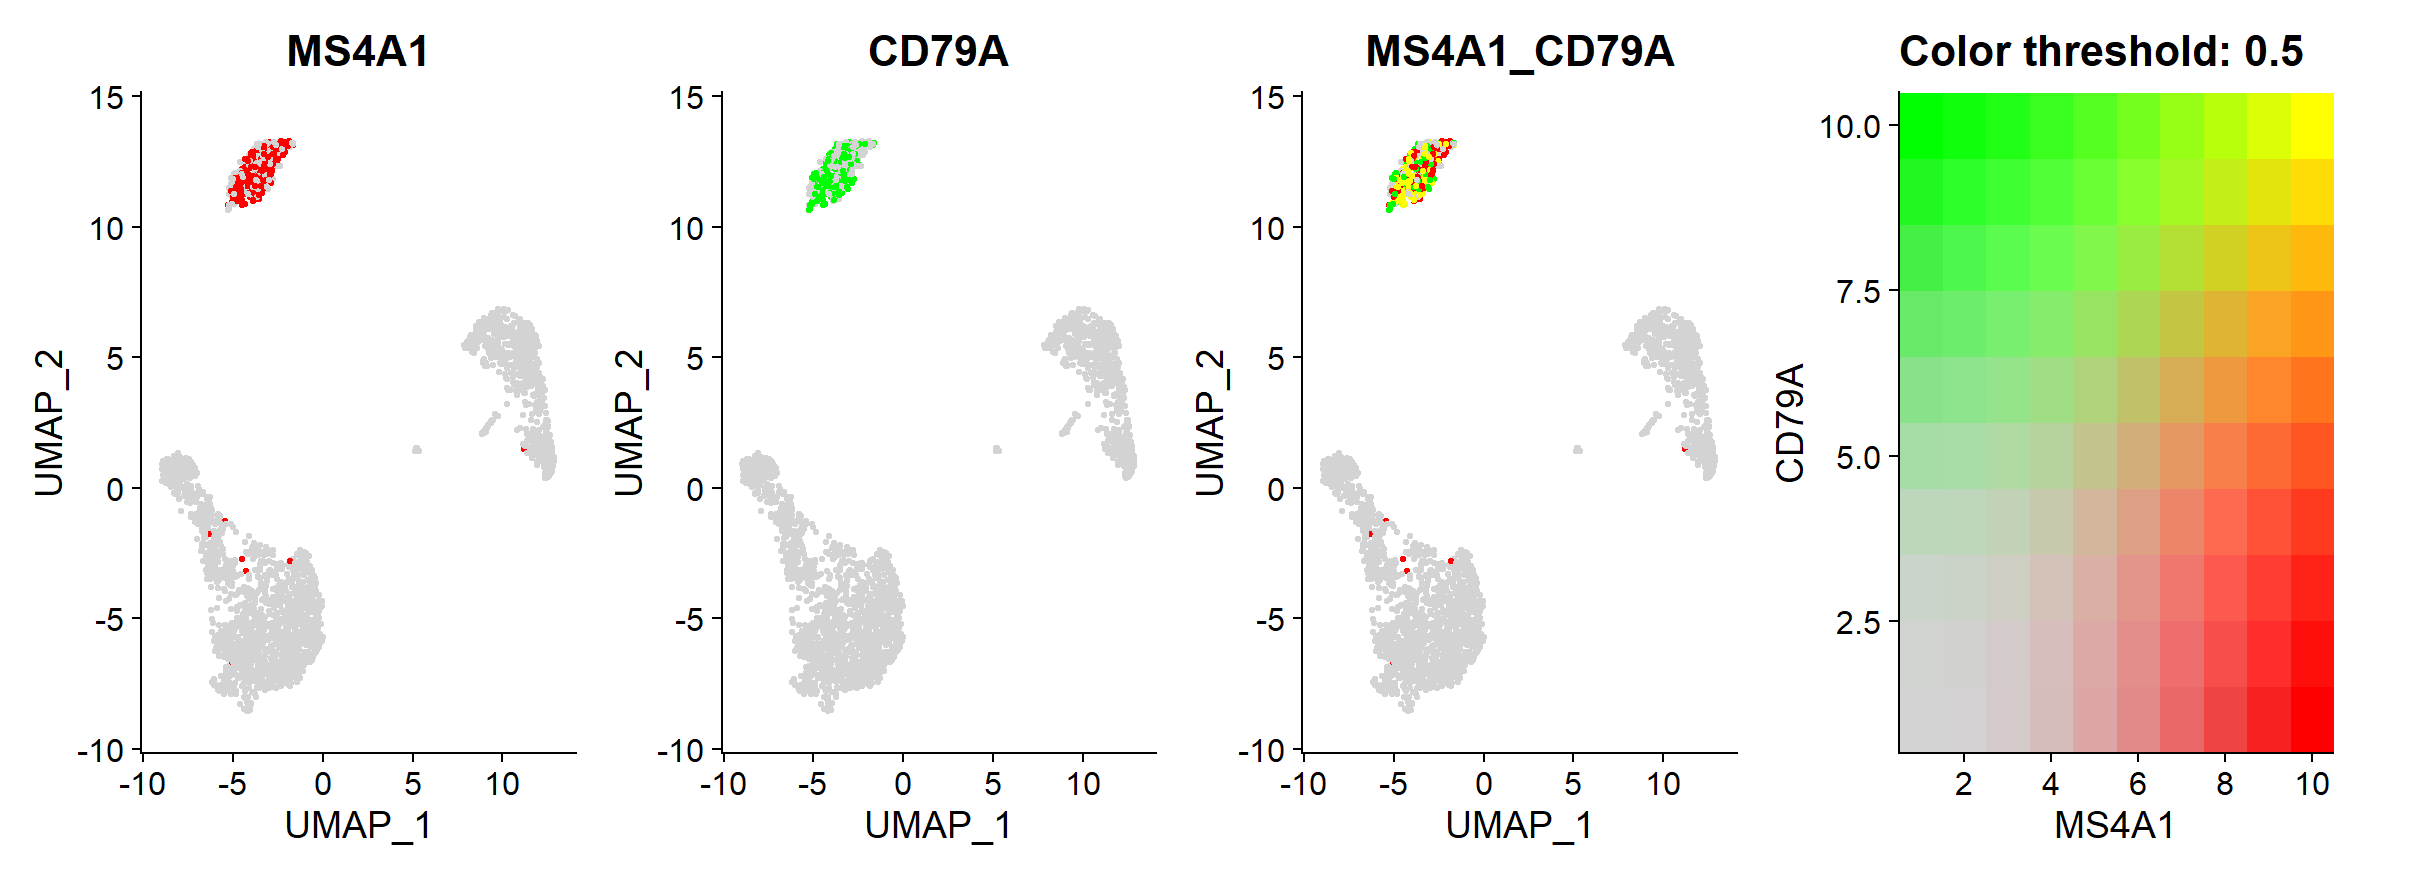
如果我们想探究两个基因的共表达情况,我们可以这么做:

1
FeaturePlot(pbmc3k.final, features = c("MS4A1", "CD79A"), blend = TRUE)

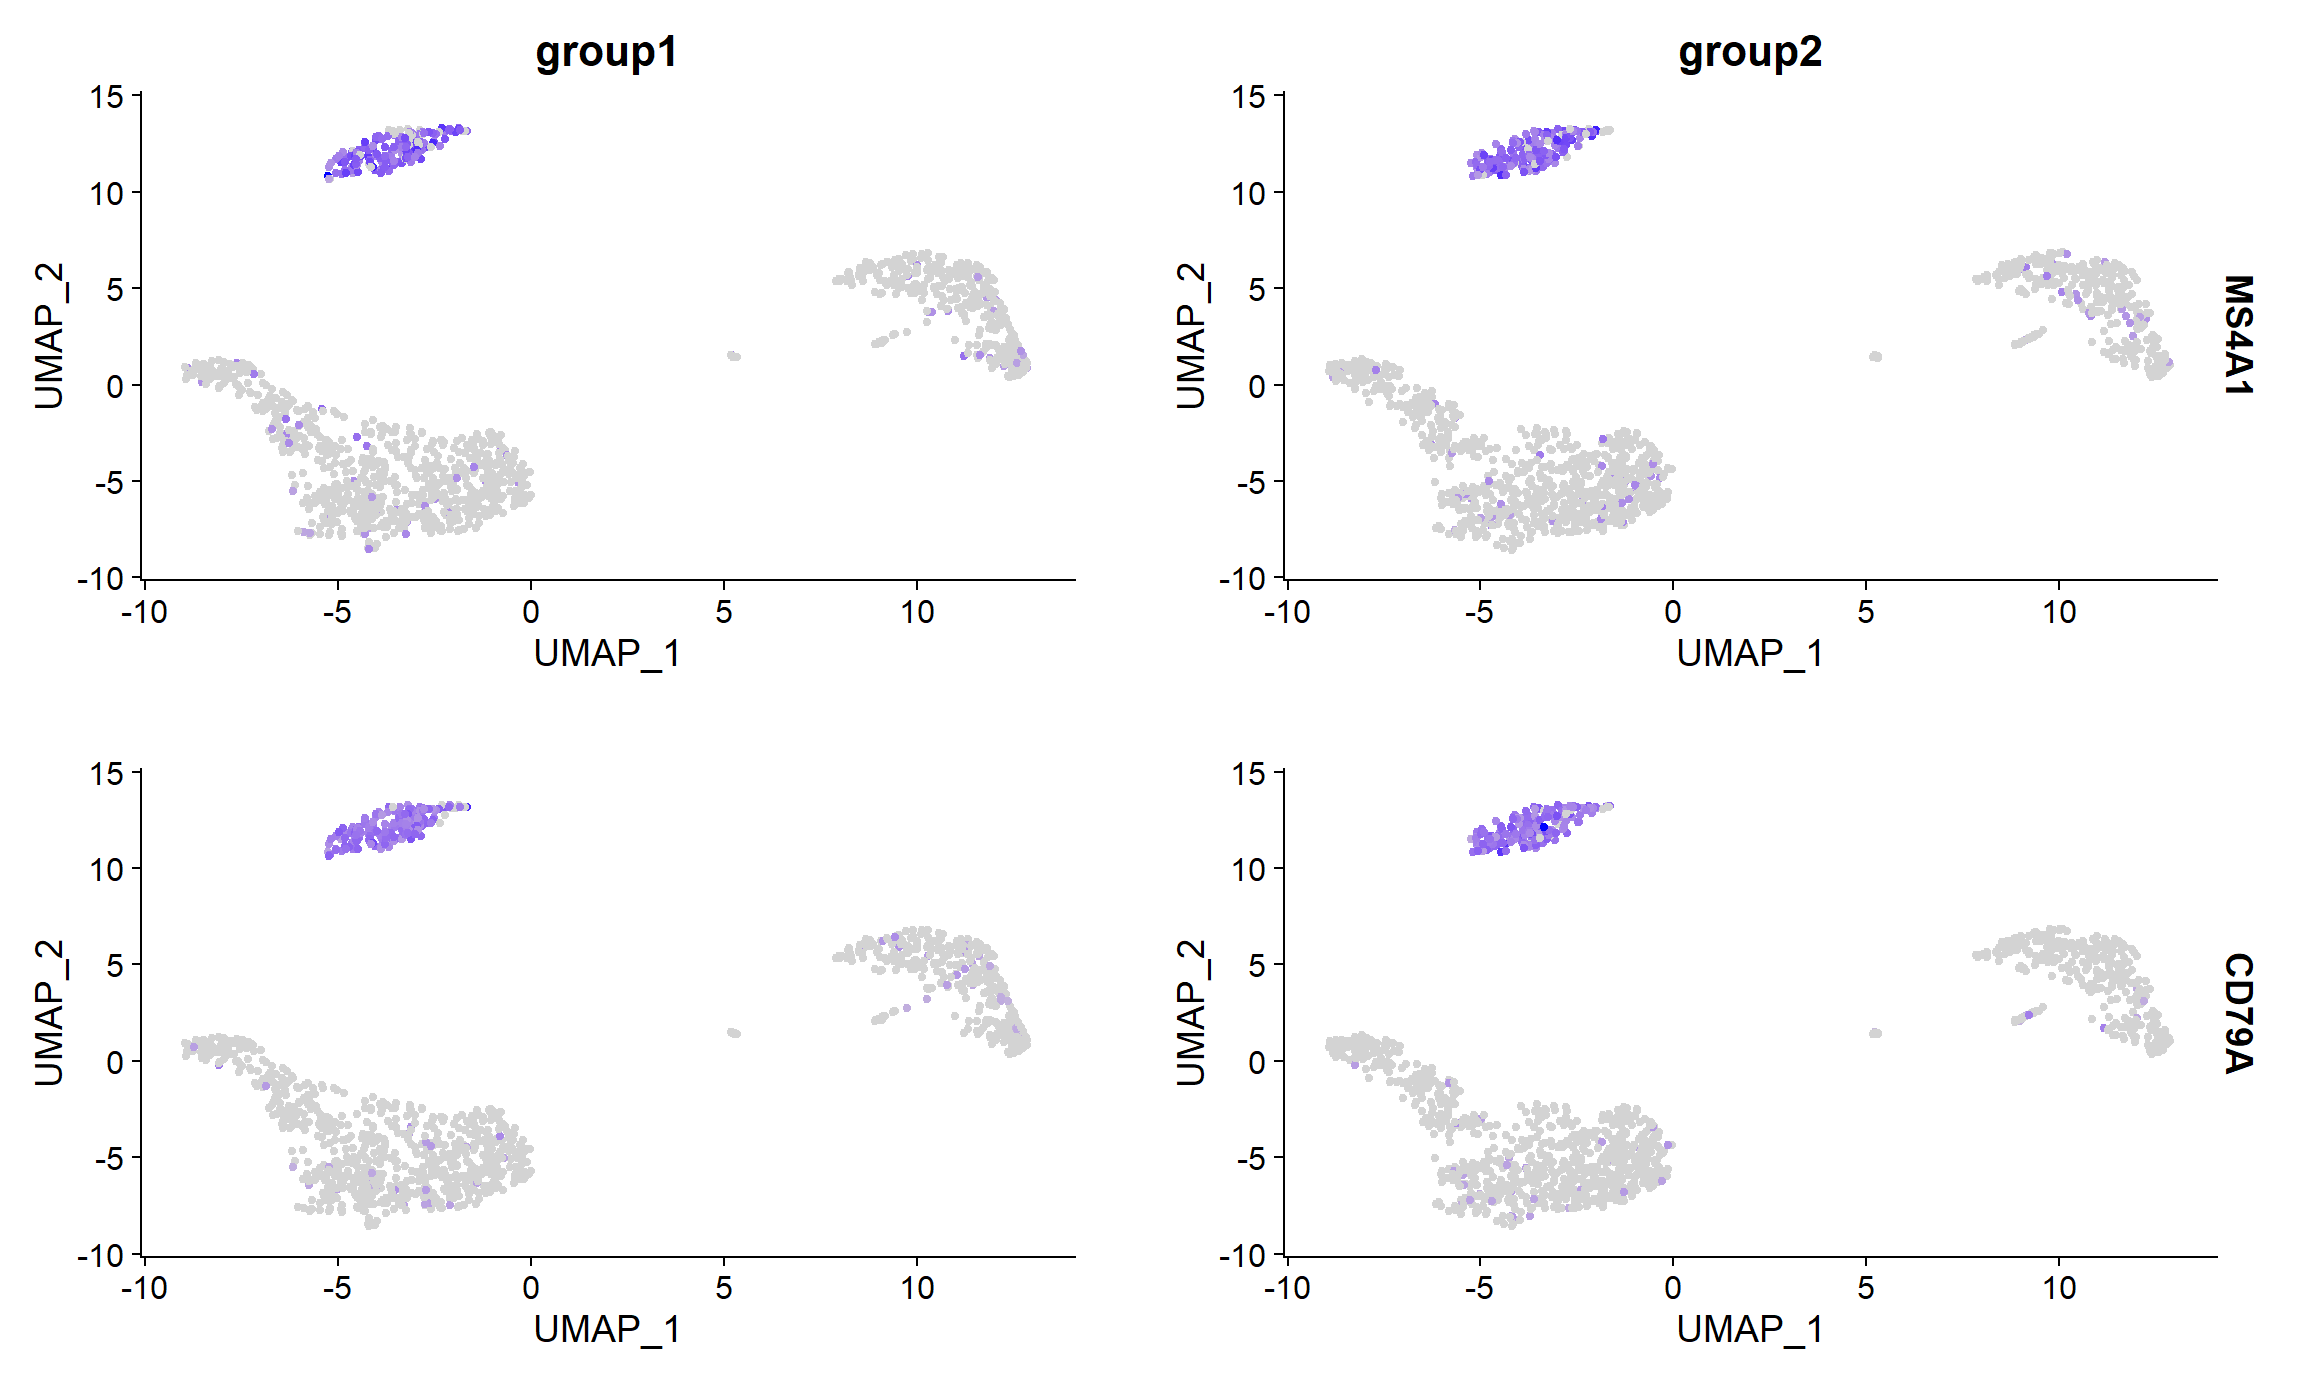
在实际的生信分析中,我们经常会遇到分组的情况(可能是健康人和患者的分组,也有可能是不同程度患者的分组,也有可能是不同疾病患者的分组)。这个时候我们需要对比不同组的同一基因的表达情况,可以这么做:

1
FeaturePlot(pbmc3k.final, features = c("MS4A1", "CD79A"), split.by = "groups")

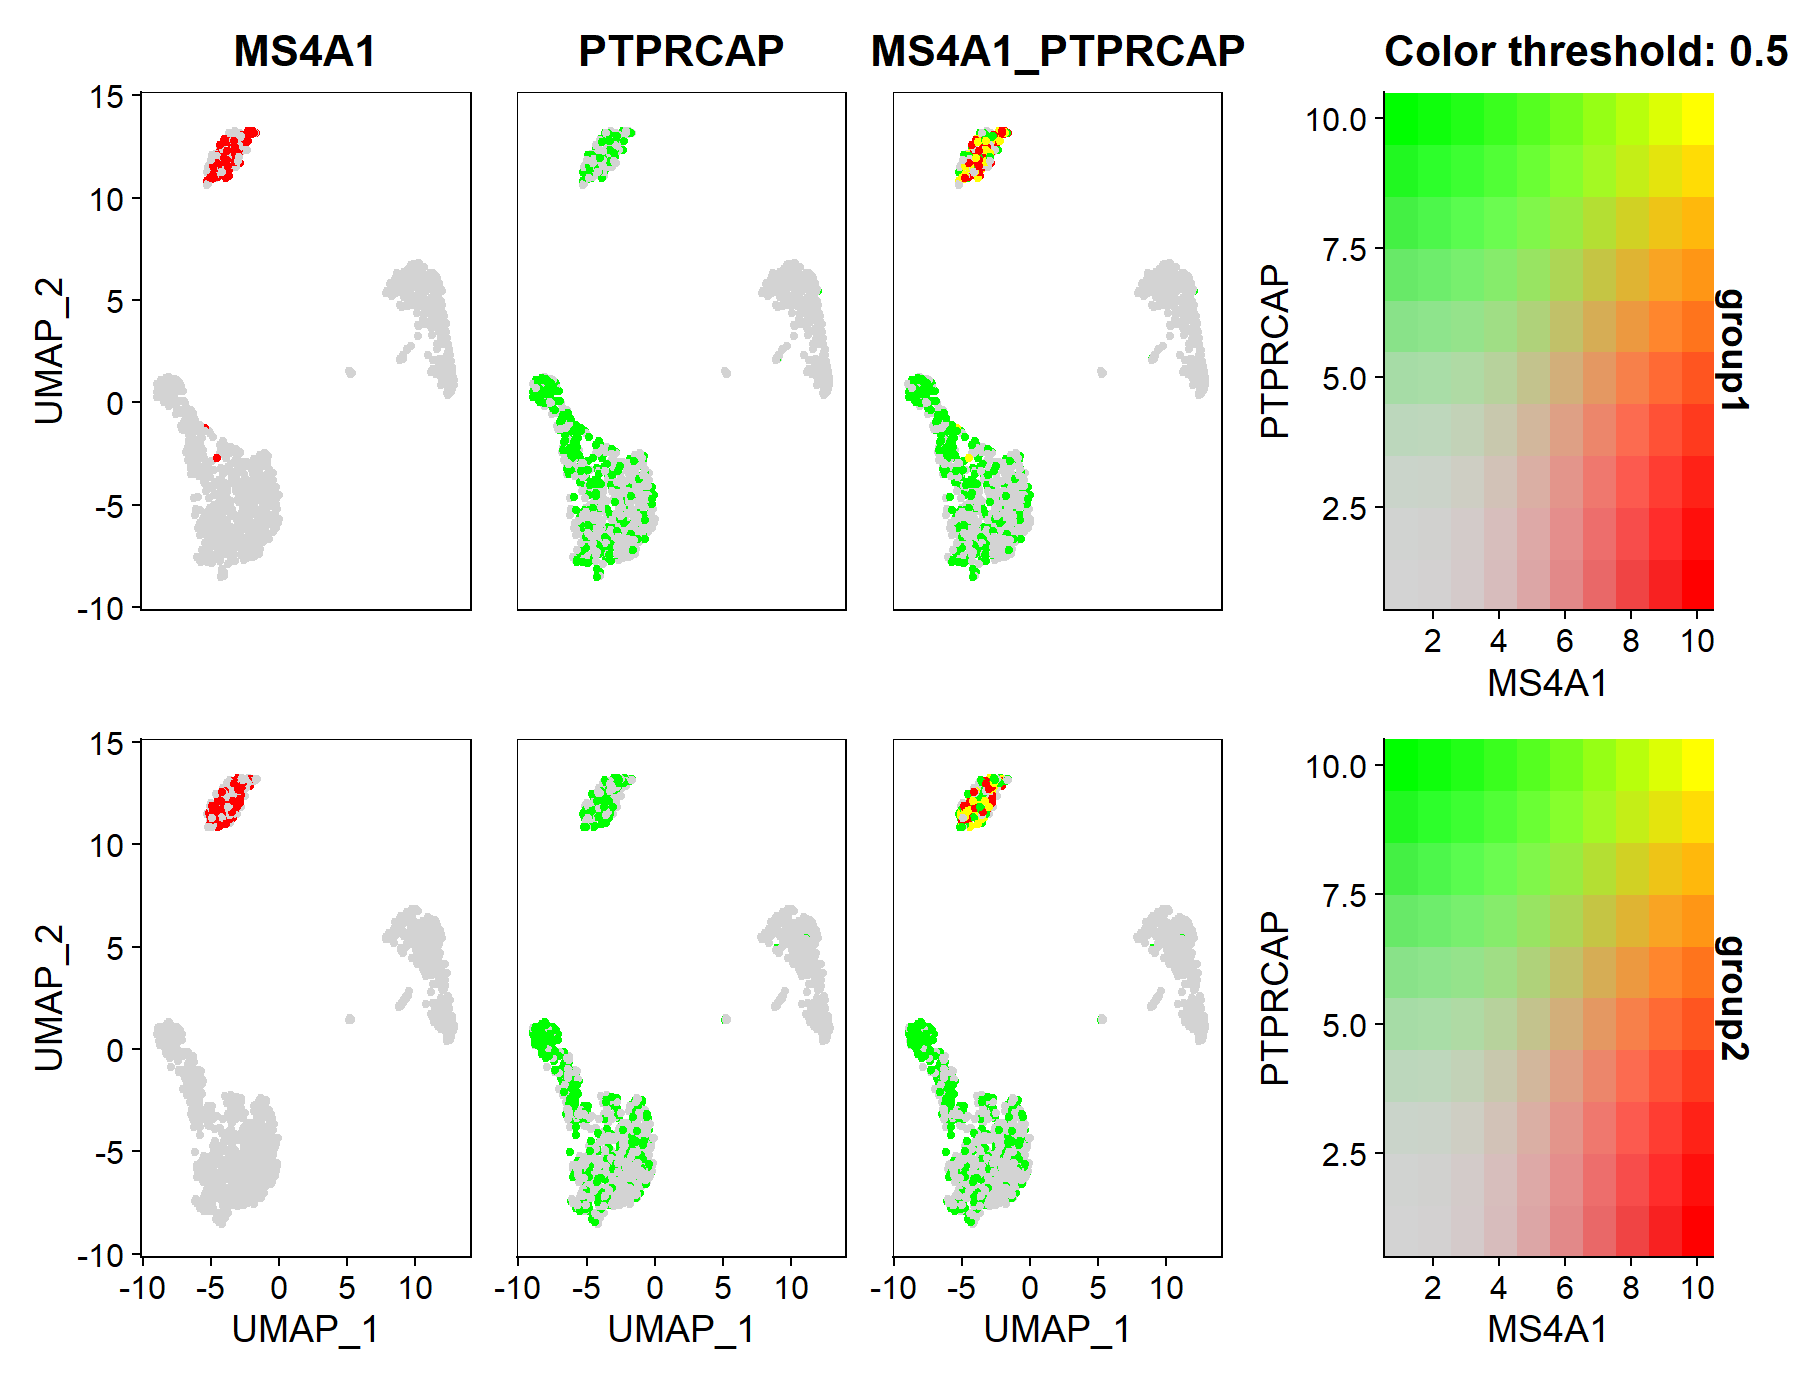
然后我尝试了大杂烩(

1
FeaturePlot(pbmc3k.final, features = c("MS4A1", "PTPRCAP"), min.cutoff = "q10", max.cutoff = "q90", blend = TRUE, split.by = "groups")

可视化的进阶玩法

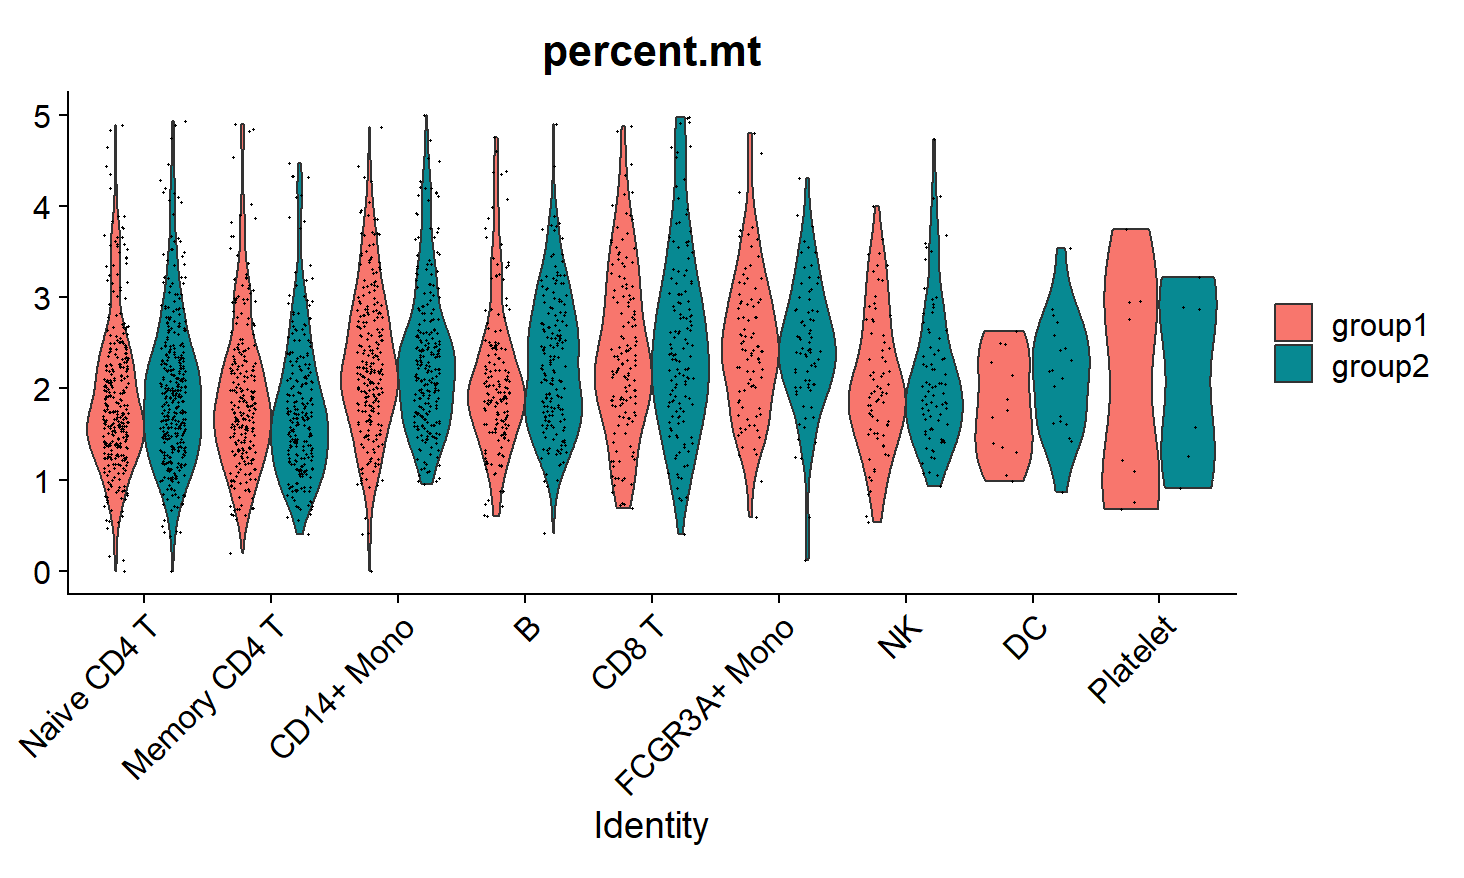
除了基因的表达水平之外,小提琴图还能显示其他变量在不同细胞簇中的分布情况。例如,通过下列代码,我们可以显示两个组中不同细胞簇的线粒体基因比例。

1
VlnPlot(pbmc3k.final, features = "percent.mt", split.by = "groups")

点图也能分组!

1
DotPlot(pbmc3k.final, features = features, split.by = "groups") + RotatedAxis()

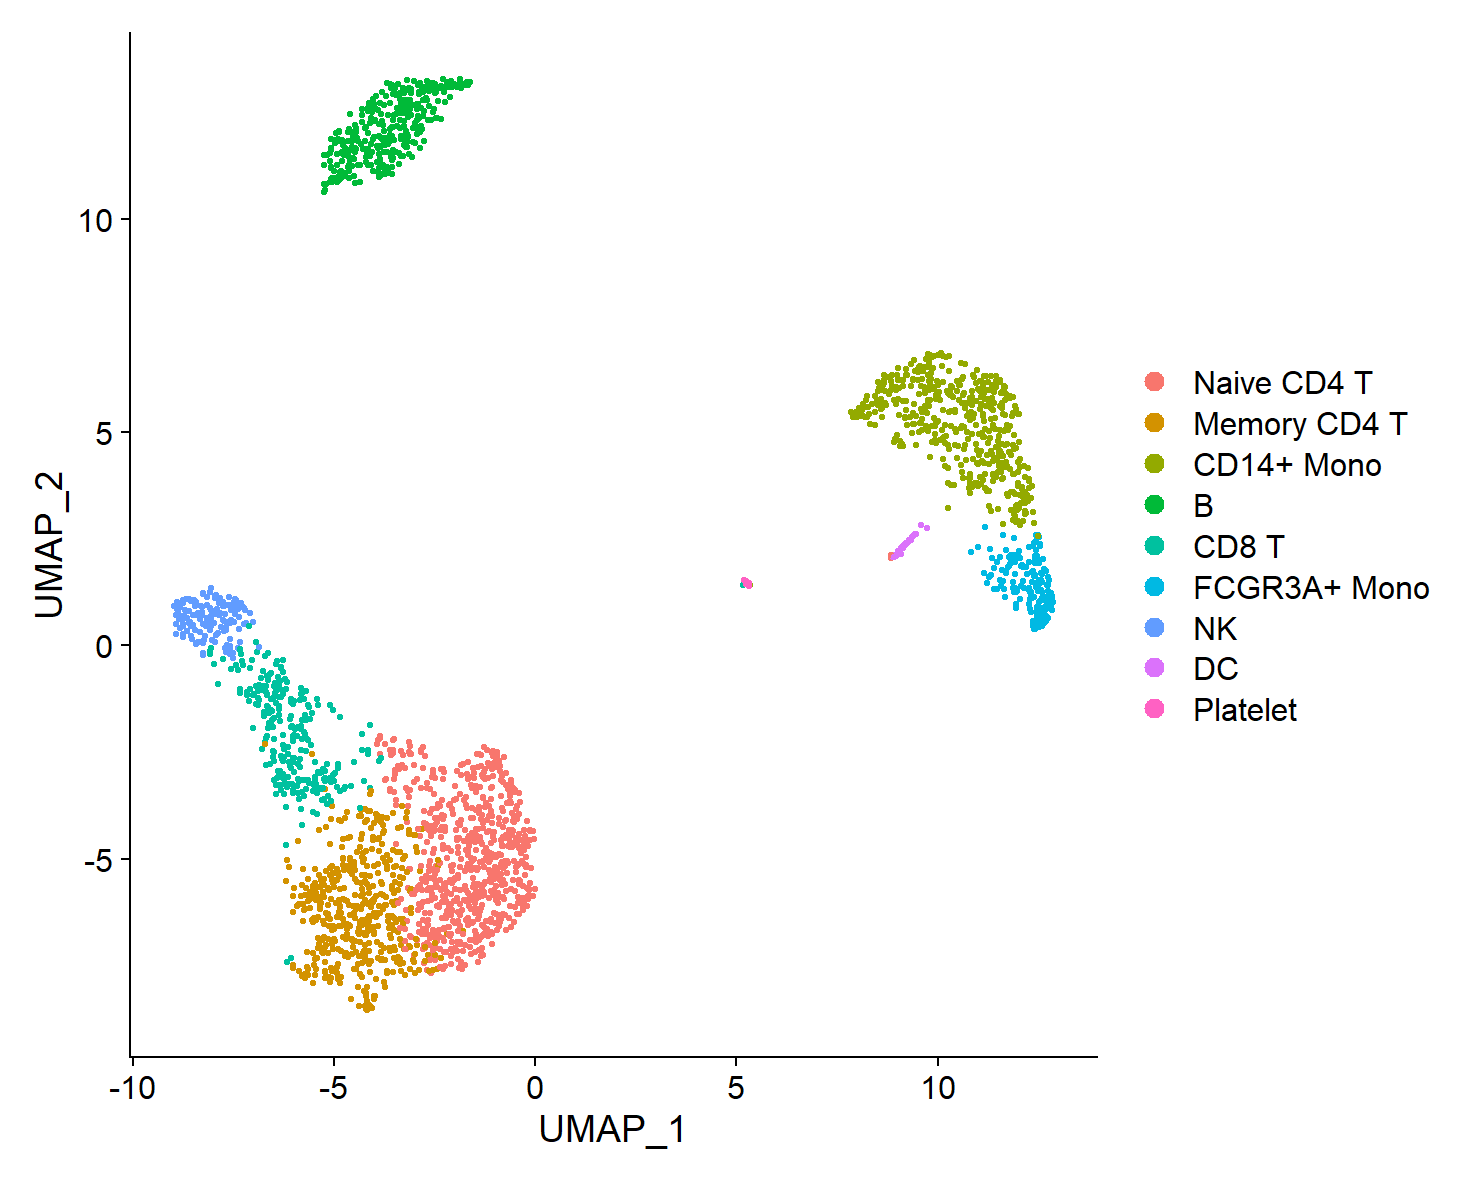
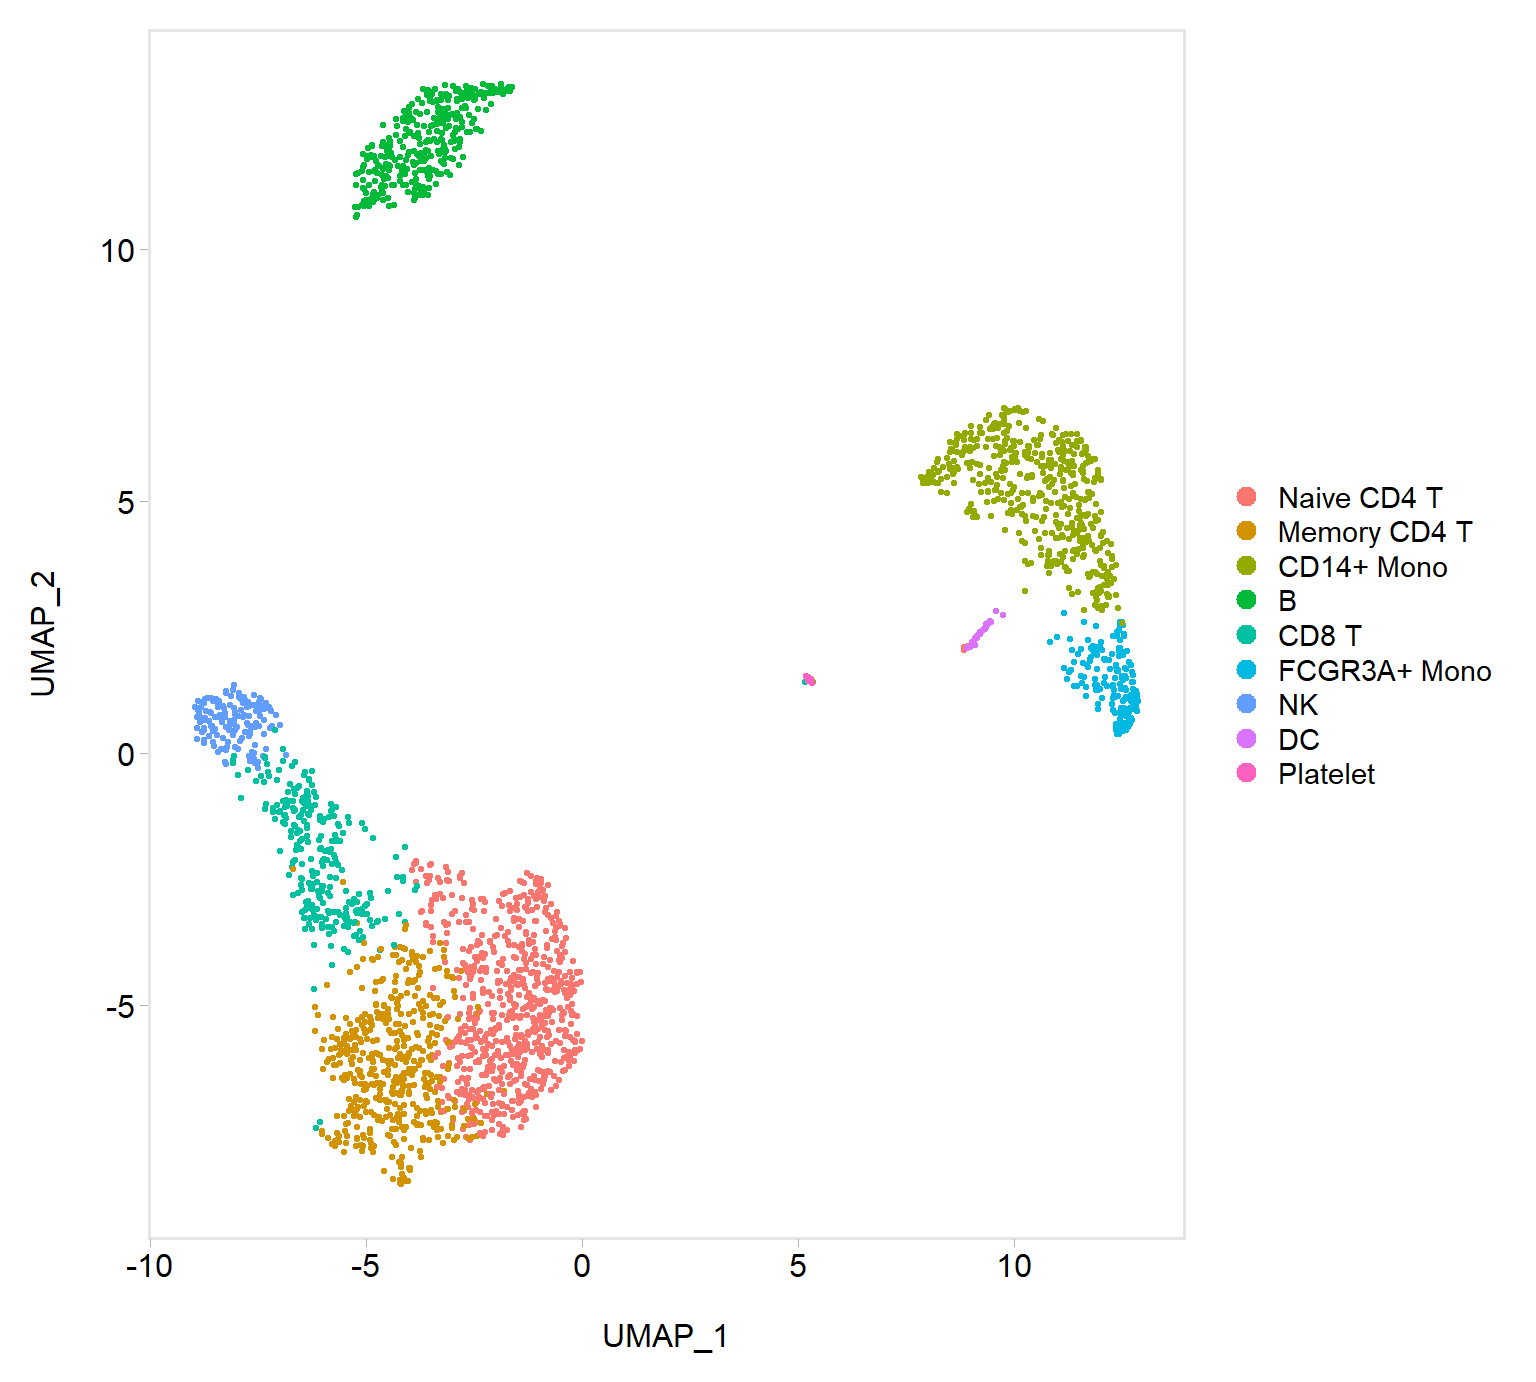
DimPlot()函数可以用来展示UMAP、$t$-SNE和PCA降维结果,展示的优先级为UMAP>$t$-SNE>PCA。也就是在没有进行任何设置的情况下,该函数默认展示经UMAP降维后的图象。

1
DimPlot(pbmc3k.final)

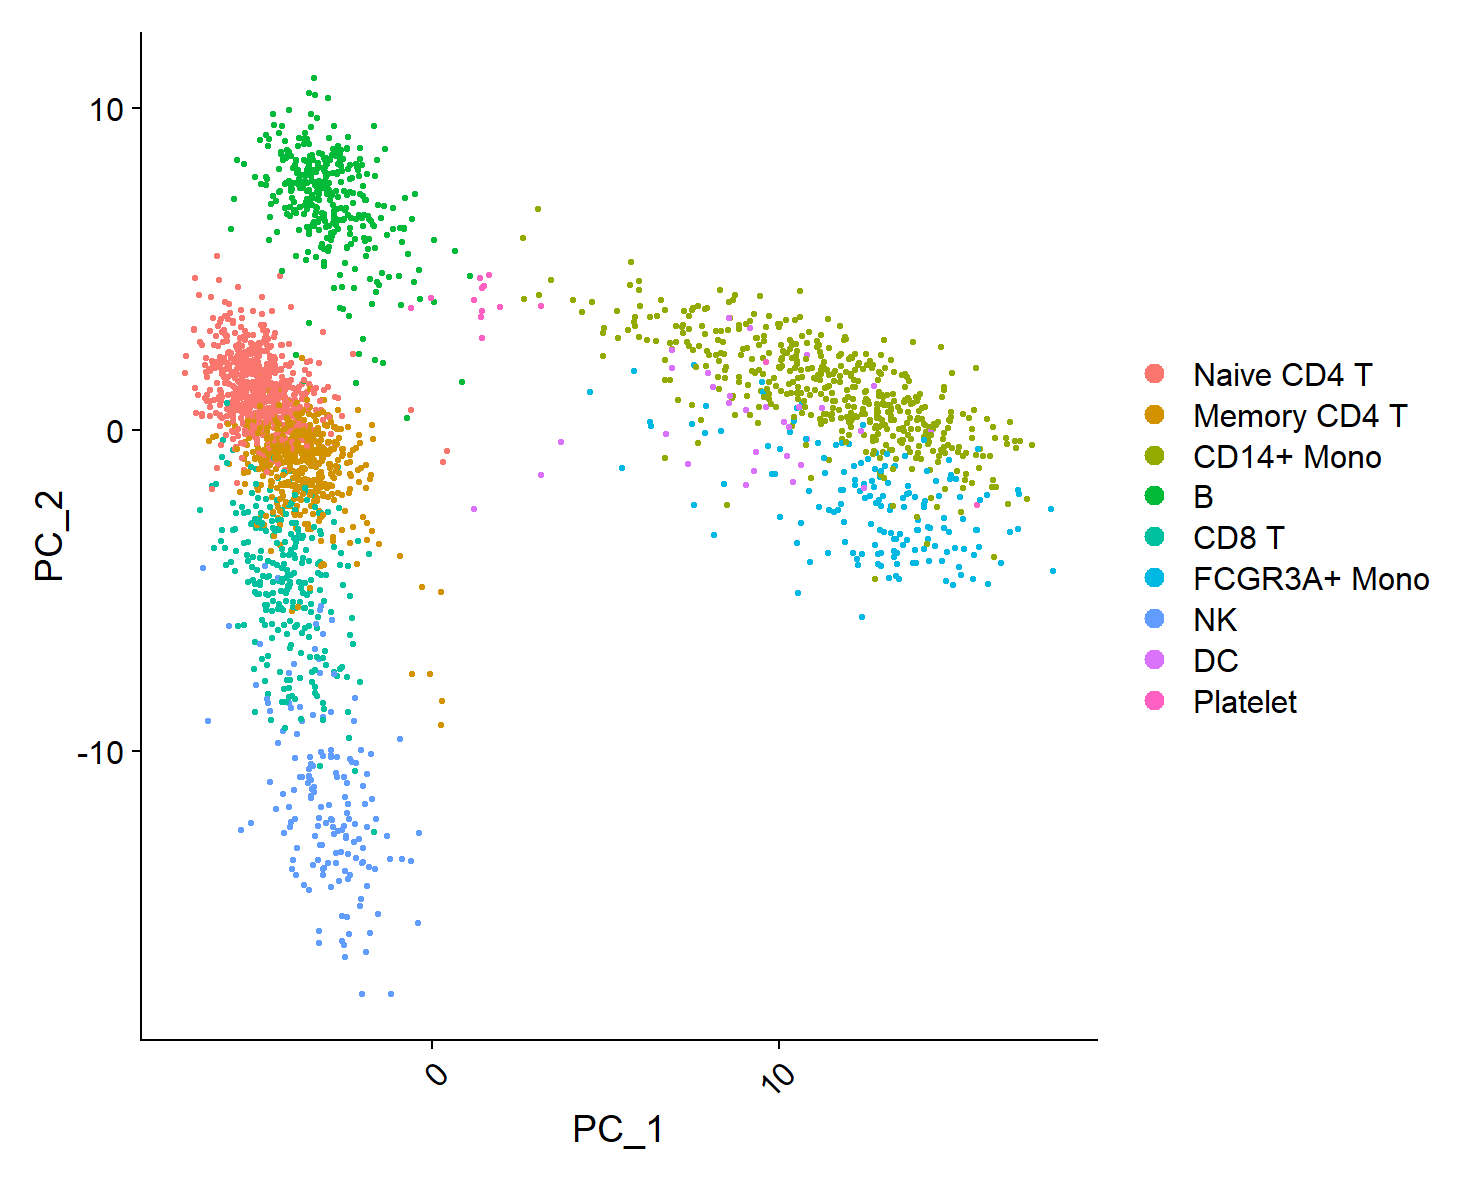
如果需要展示PCA降维后的数据,我们需要将原始数据集进行备份,然后在备份数据集上删除UMAP分析结果。(如果还进行了$t$-SNE分析,则还需要删除$t$-SNE分析结果,否则会有限展示$t$-SNE分析结果)。

1
2
3
4
pbmc3k.final.no.umap <- pbmc3k.final
pbmc3k.final.no.umap[["umap"]] <- NULL
DimPlot(pbmc3k.final.no.umap) + RotatedAxis()
#似乎可以直接用DimPlot(pbmc3k.final, reduction = "pca") + RotatedAxis()直接指定展示PCA降维结果

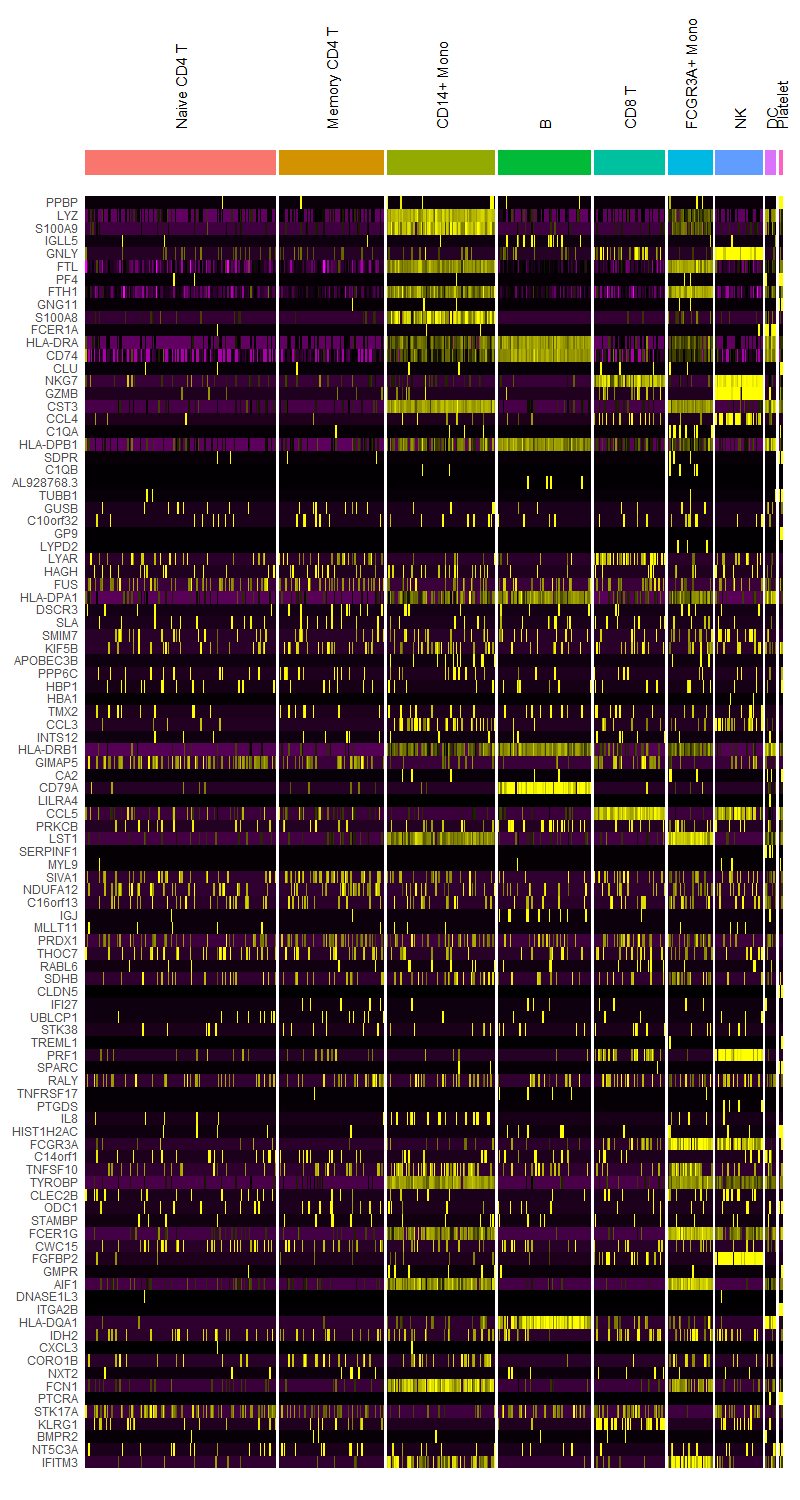
在热图中,默认按照细胞簇进行分群,如果需要按照其他标准分群,可以更改$group.by$的参数。

1
2
DoHeatmap(pbmc3k.final, features = VariableFeatures(pbmc3k.final)[1:100], cells = 1:500, size = 4, angle = 90) + NoLegend()
#NoLegend()即删除图例。

根据实际需要对图象进行个性化设置

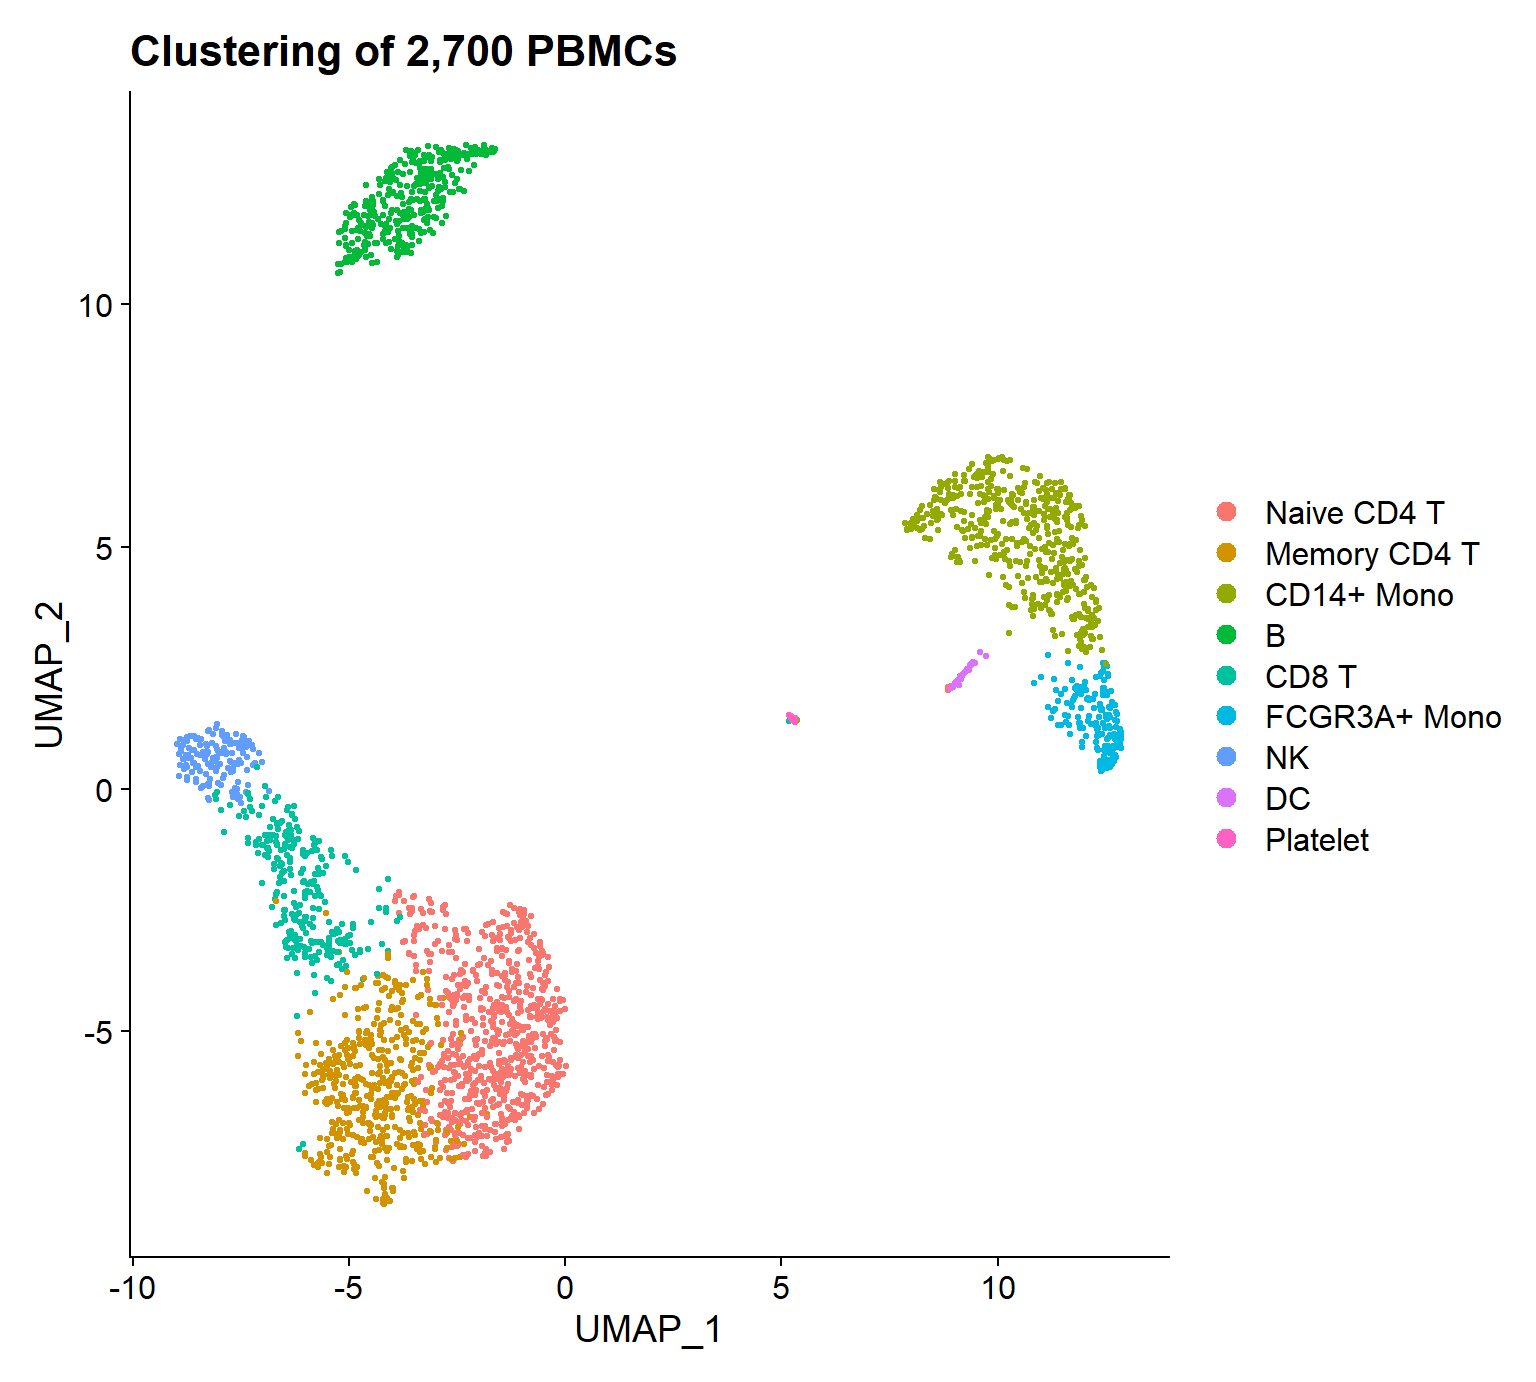
增加标题

1
2
baseplot <- DimPlot(pbmc3k.final, reduction = "umap")
baseplot + labs(title = "Clustering of 2,700 PBMCs")

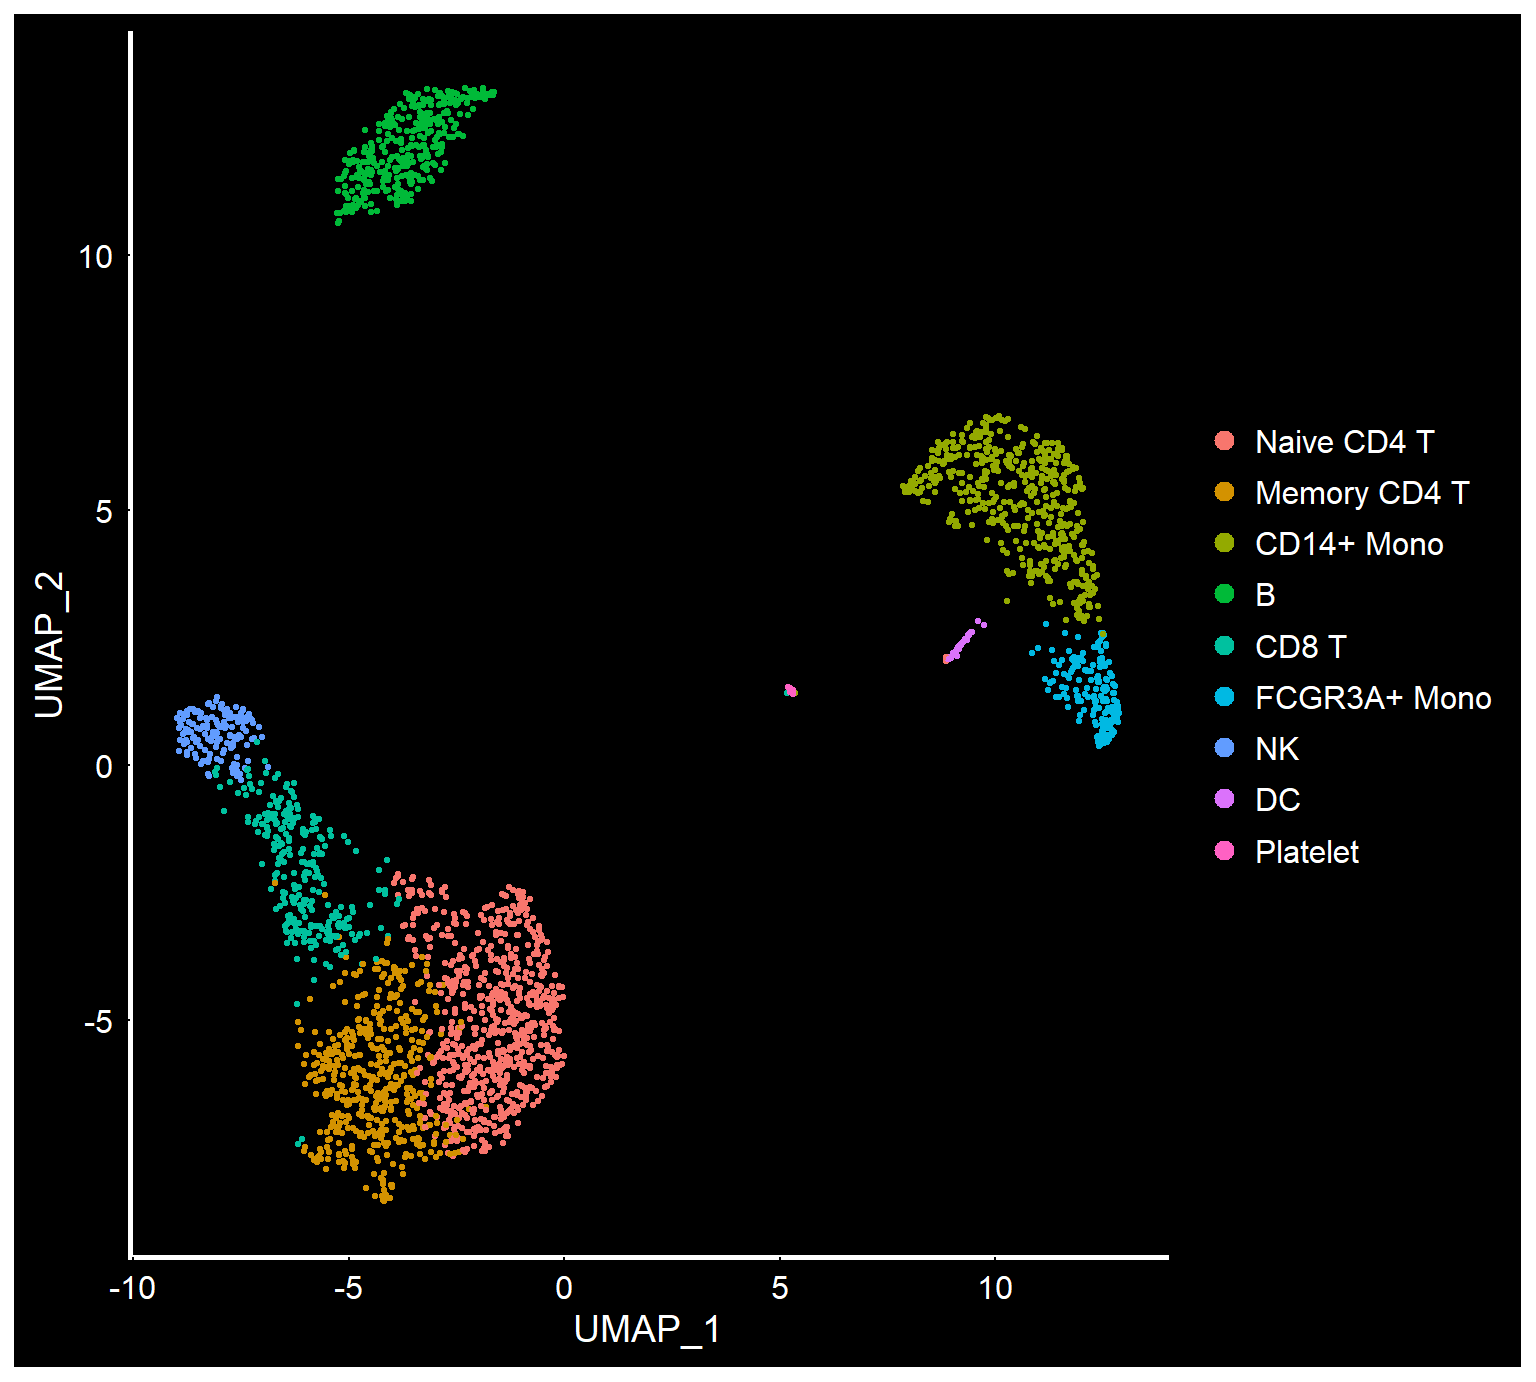
更改主题(此处改为PowerPoint主题)

1
2
remotes::install_github('sjessa/ggmin') #因为不是自带的主题……所以需要安装所需要的扩张包
baseplot + ggmin::theme_powerpoint()

1
baseplot + DarkTheme() #黑色主题是自带的,无需ggmin

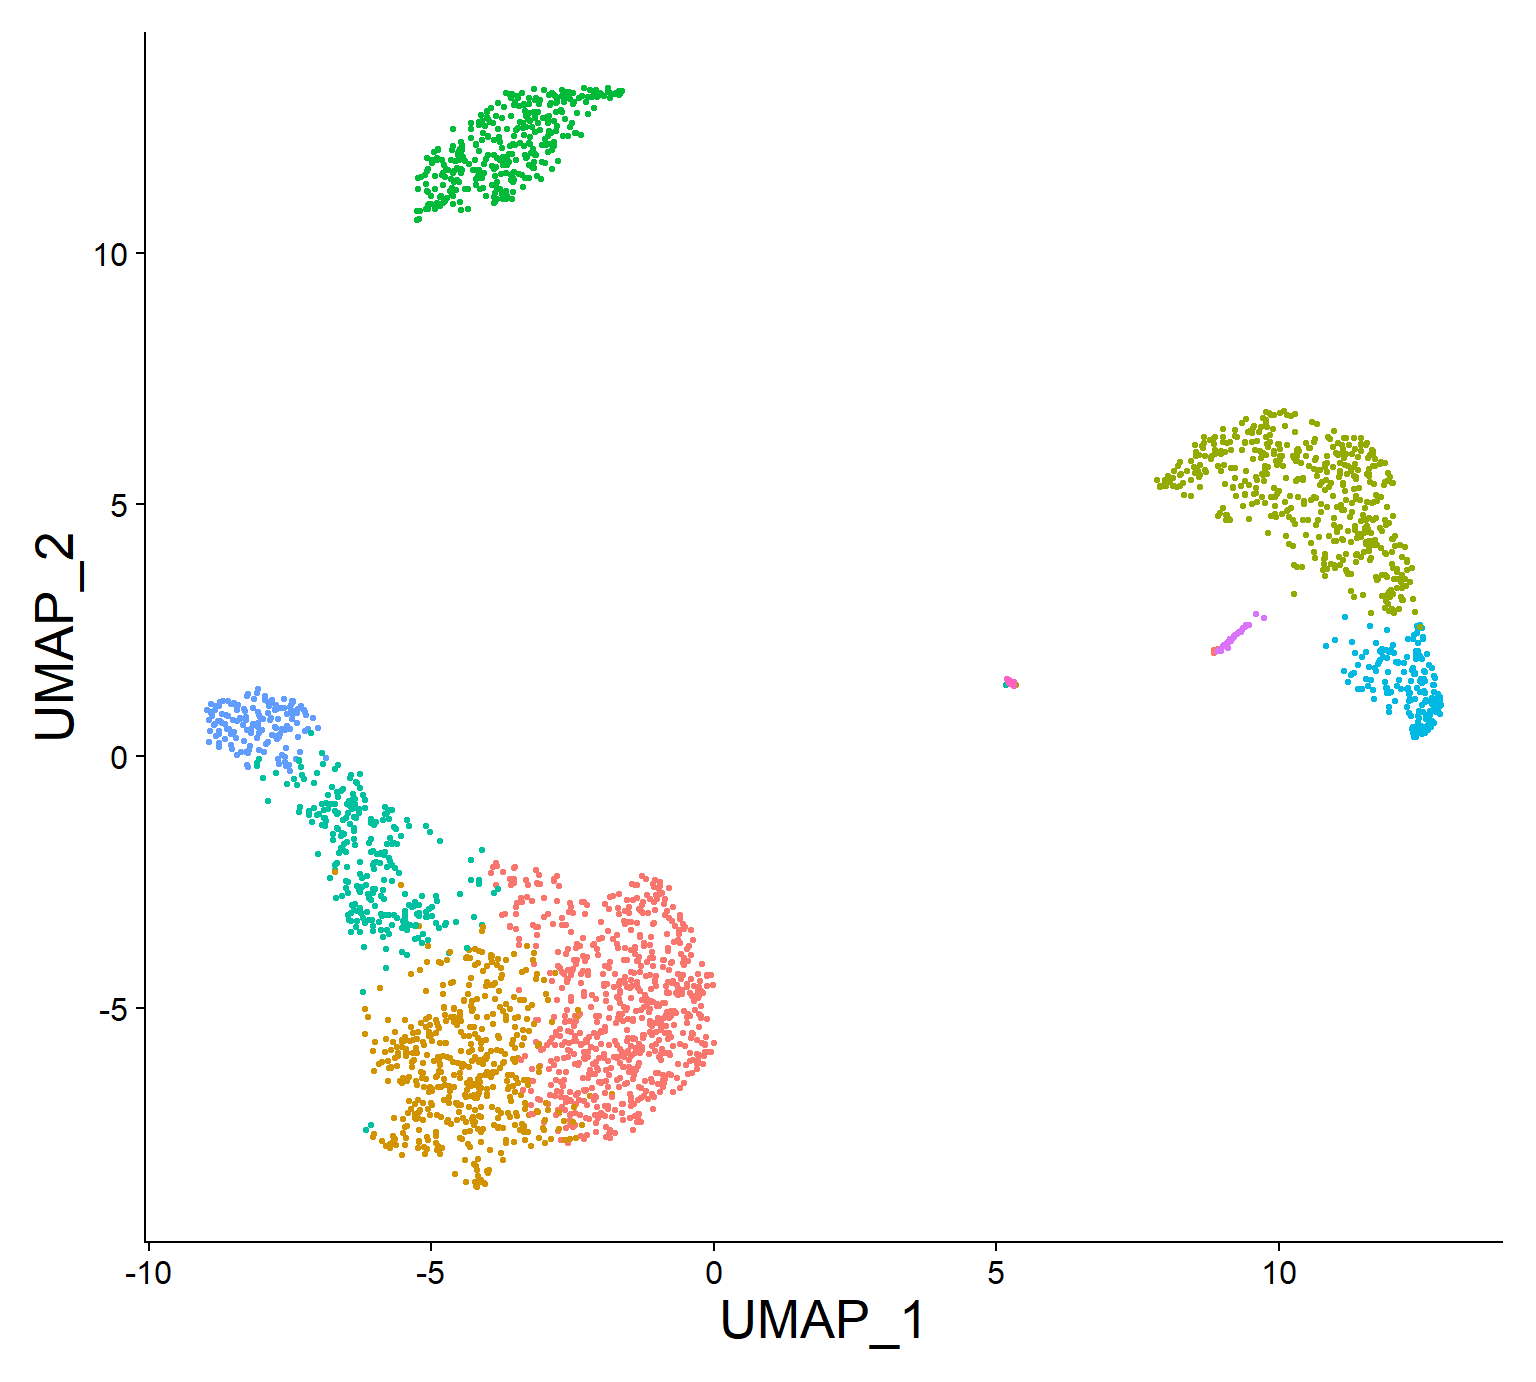
使用FontSize()调整字体大小

1
baseplot + FontSize(x.title = 20, y.title = 20) + NoLegend()

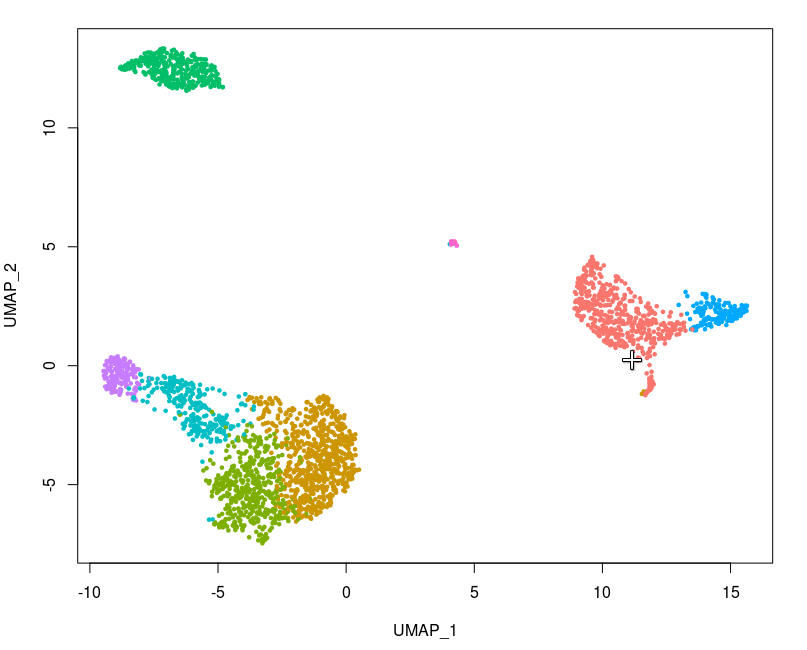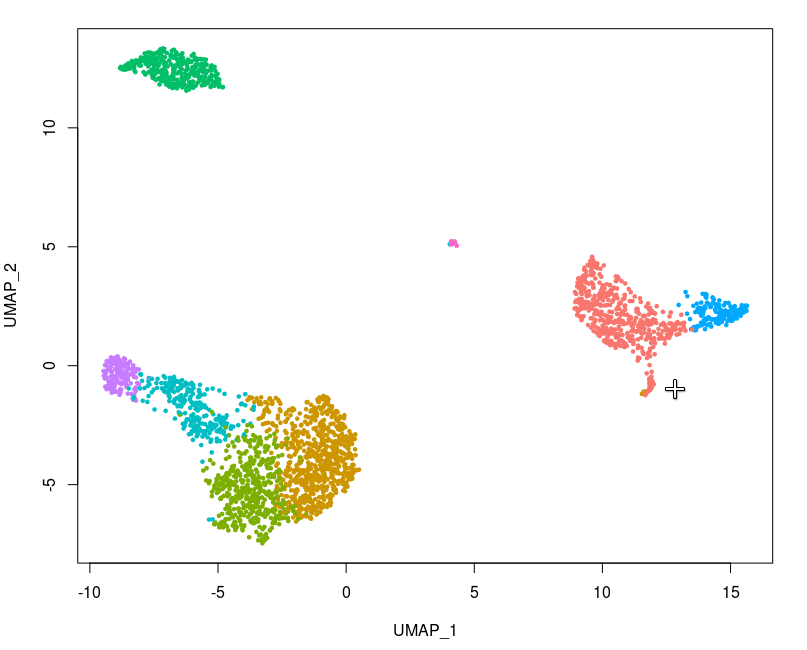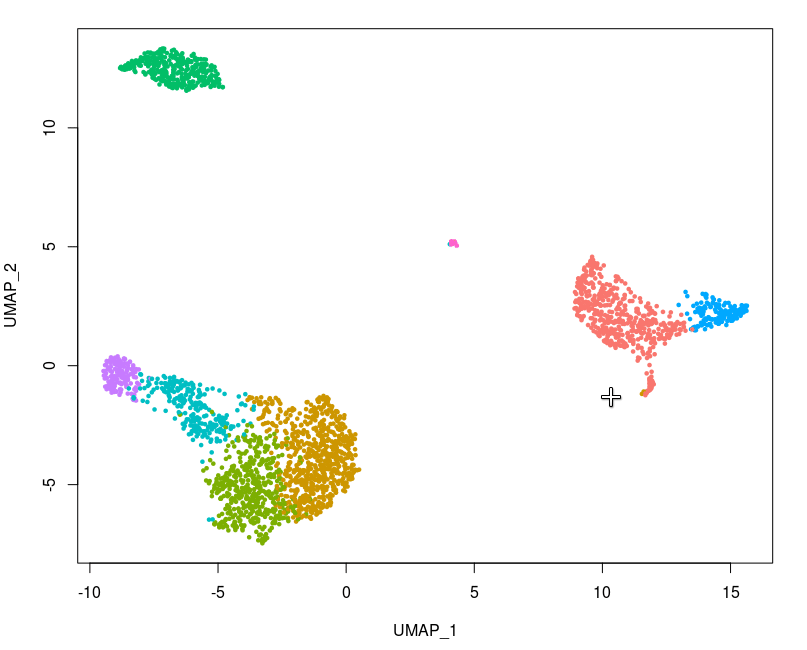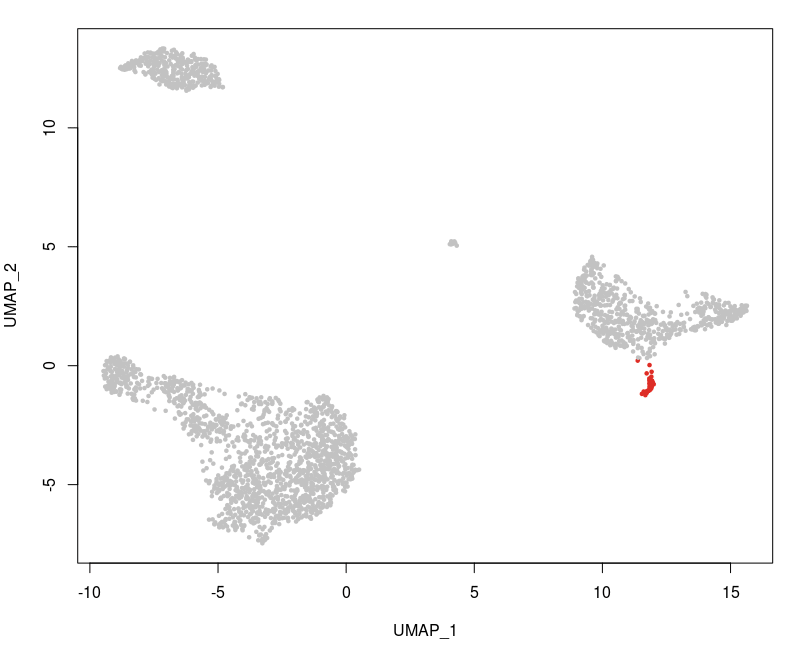
交互式绘图

对于任何ggplot2生成的图象,可以利用HoverLocator()函数生成一个可交互的图象。以下面的代码为例,所生成的特征图允许我们查看每一个细胞的ident、PC_1和nFeature_RNA。

1
2
3
4
plot <- FeaturePlot(pbmc3k.final, features = "MS4A1") #生成特殊图
HoverLocator(plot = plot, information = FetchData(pbmc3k.final, vars = c("ident", "PC_1", "nFeature_RNA")))
#Seurat包中的HoverLocator()函数可以为我们提供可视化功能
#FetchData()函数可以抓取pbmc3k.fianl中“ident(所属细胞簇)”“PC_1(主成分1)”“nFeature_RNA(细胞内基因种类数)”

在R中生成交互式图象之后,如何把交互式图象上传到自己的Hexo博客仍然是一个比较困难的问题。对于不使用Hexo博客记录自己学习过程的朋友,这个问题无关紧要,可以跳过。不过如果你对我如何解决这个问题感兴趣,欢迎点这里进一步了解!

Seurat包还提供了一种可交互的方式,允许我们手动选择部分细胞进行进一步的分析。

1
2
3
4
5
6
pbmc3k.final <- RenameIdents(pbmc3k.final, DC = "CD14+ Mono")
plot <- DimPlot(pbmc3k.final, reduction = "umap")
select.cells <- CellSelector(plot = plot)
#在运行上一行之后,可以在图像中选中所需要的细胞,并点击图象右上角的“Done”完成选中

head(select.cells) #展示选中的细胞

这里因为懒得搞gif,所以直接搬运了官方教程上的gif图:

  • 运行结果
1
2
3
> head(select.cells)
[1] "AAGATTACCGCCTT" "AATTACGAATTCCT" "ACGTGATGCCATGA" "ATGTAAACGGGATG" "CATATAGACTAAGC"
[6] "TTCAGTTGTCCTTA"

选择需要的细胞之后,可以将这些细胞定义为“新细胞簇”,进行进一步的分析。

1
2
3
4
5
6
Idents(pbmc3k.final, cells = select.cells) <- "NewCells"
# 将选中的细胞定义为新细胞集群。
newcells.markers <- FindMarkers(pbmc3k.final, ident.1 = "NewCells", ident.2 = "CD14+ Mono", min.diff.pct = 0.3, only.pos = TRUE)
# 以CD14+ Monocyte为参照,寻找新细胞集群中的差异表达基因。
# min.diff.pct为表达比例差异过滤阈值,值越大筛选出的差异表达基因越少、“含金量”更高
head(newcells.markers)
  • 运行结果
1
2
3
4
5
6
7
8
> head(newcells.markers)
p_val avg_log2FC pct.1 pct.2 p_val_adj
PRR11 5.012606e-26 7.530865 0.333 0.002 6.874288e-22
PIGB 8.223491e-20 6.540514 0.333 0.004 1.127770e-15
FCER1A 1.045325e-19 3.461827 1.000 0.055 1.433559e-15
TEX10 6.752791e-16 5.820948 0.333 0.006 9.260778e-12
PXMP2 1.206141e-11 4.056272 0.500 0.024 1.654102e-07
SH3RF1 1.297326e-11 4.669408 0.333 0.010 1.779153e-07

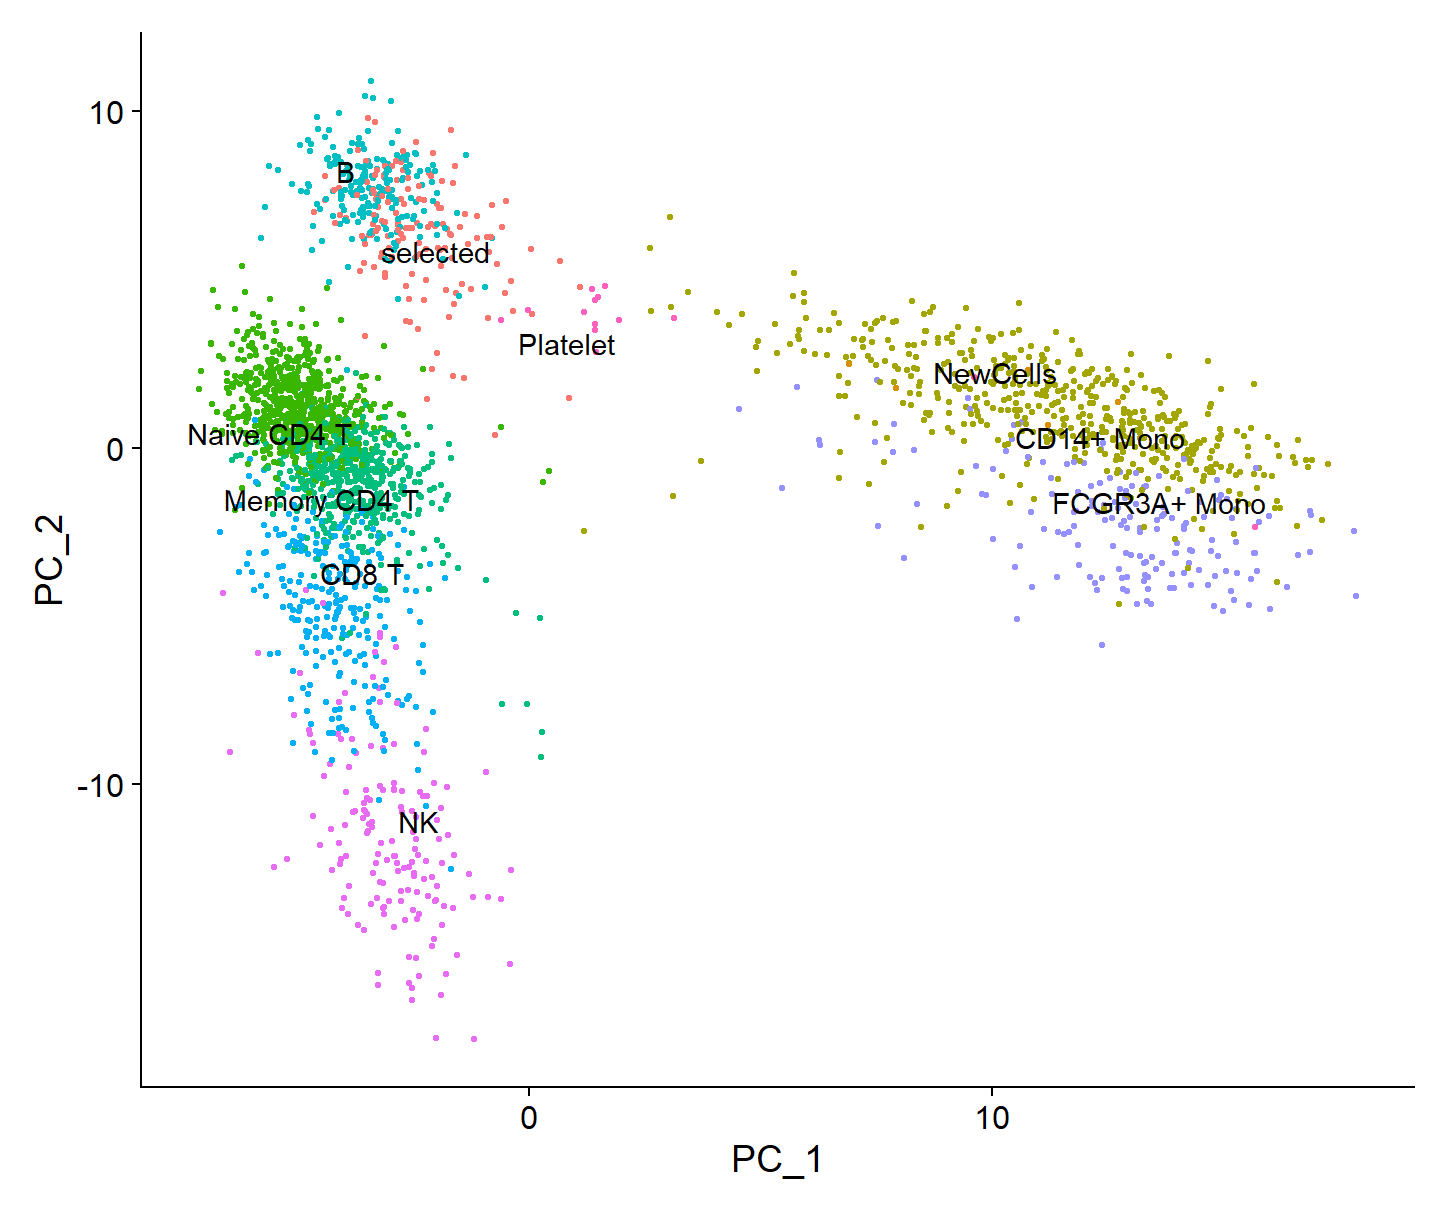
利用CellSelector()函数,我们还可以将选中的细胞自动标记为新的细胞集群(这里标记为Selected)。

1
2
3
levels(pbmc3k.final)#标记前
pbmc3k.final <- CellSelector(plot = plot, object = pbmc3k.final, ident = "selected")
levels(pbmc3k.final)#标记后
  • 运行结果:
1
2
3
4
5
6
7
8
9
> levels(pbmc3k.final)
[1] "NewCells" "CD14+ Mono" "Naive CD4 T" "Memory CD4 T" "B" "CD8 T"
[7] "FCGR3A+ Mono" "NK" "Platelet"
> pbmc3k.final <- CellSelector(plot = plot, object = pbmc3k.final, ident = "selected")

Listening on http://127.0.0.1:7788
> levels(pbmc3k.final)
[1] "selected" "NewCells" "CD14+ Mono" "Naive CD4 T" "Memory CD4 T" "B"
[7] "CD8 T" "FCGR3A+ Mono" "NK" "Platelet"

给点图也加点新花样

利用LabelClusters()函数标注细胞集群

1
2
plot <- DimPlot(pbmc3k.final, reduction = "pca") + NoLegend()
LabelClusters(plot = plot, id = "ident")

通过设置repel参数避免标签的重叠

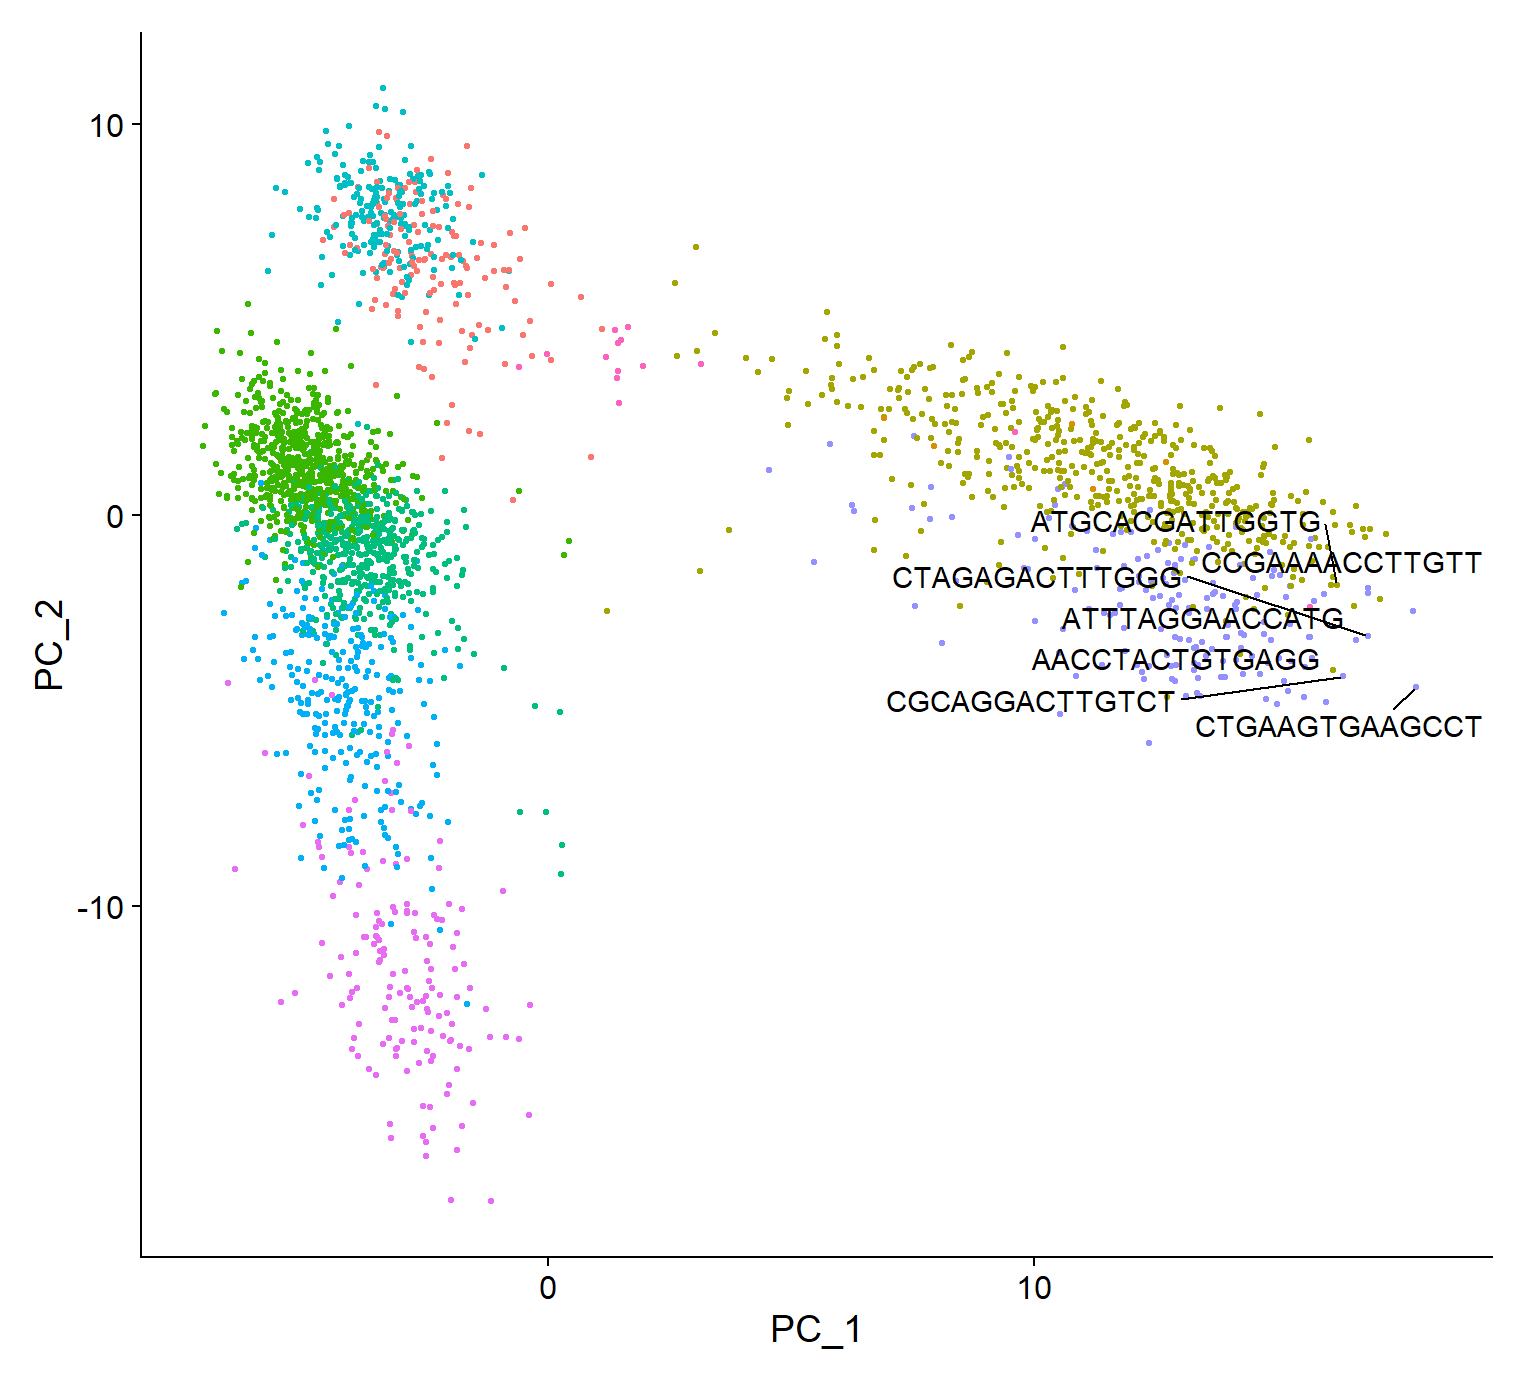
TopCells函数可以找出识别对特定主成分(PC)贡献最大的细胞。换句话来说,在前面我们确定了每个细胞簇的特征基因表达模式(主成分)。TopCells()函数可以找出这些细胞簇中特征基因表达模式最极端的细胞。例如说我们确认某个基因表达的上调是某个细胞簇的特征,TopCell()函数就可以找出该基因表达上调得最多的几个细胞。

1
LabelPoints(plot = plot, points = TopCells(object = pbmc3k.final[["pca"]]), repel = TRUE)

利用简单的“相加”一次绘制多个图

1
2
3
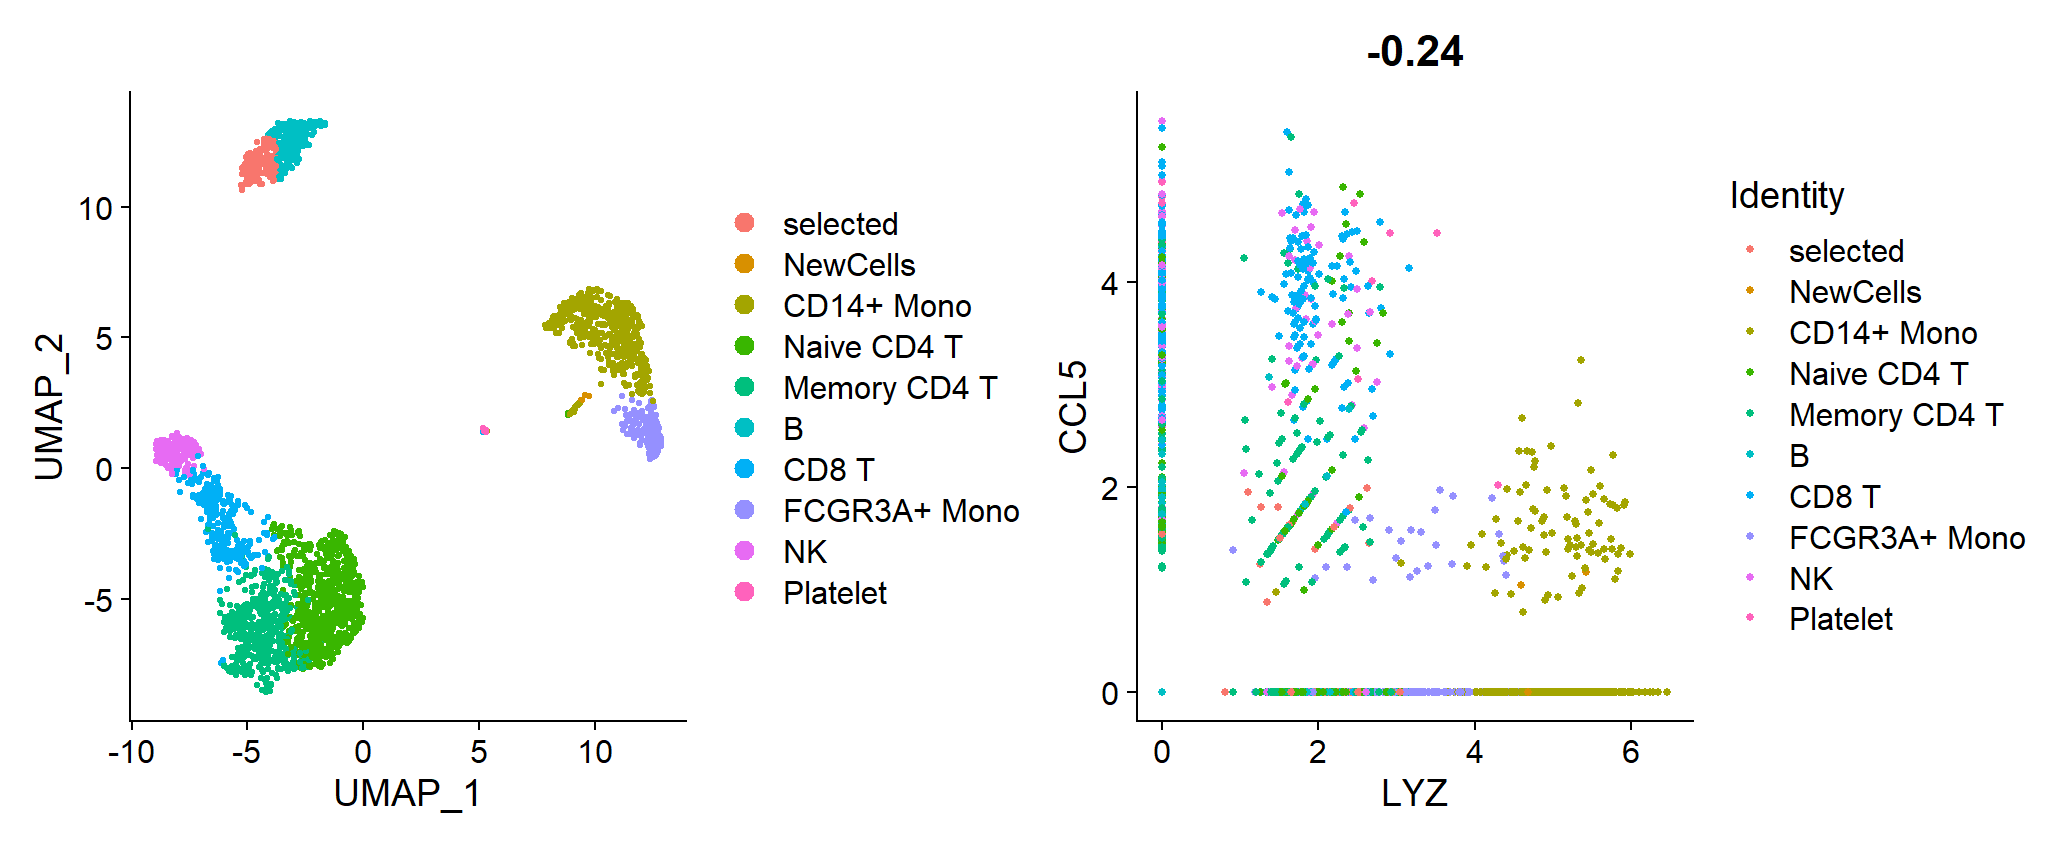
plot1 <- DimPlot(pbmc3k.final)
plot2 <- FeatureScatter(pbmc3k.final, feature1 = "LYZ", feature2 = "CCL5") #绘制两个基因在所有细胞中的表达量相关性散点图
plot1 + plot2 #合并图象

完整代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
install.packages(c("Seurat","patchwork","ggplot2","SeuratData"))

#下载SeuratData包时报错显示:package ‘SeuratData’ is not available for this version of R
#根据网络上给出的解决措施,改用下面的方法下载该R包
install.packages("remotes")
remotes::install_github("satijalab/seurat-data")
#运行后在下方Console栏中输入1并回车

library(Seurat)
library(patchwork)
library(ggplot2)
library(SeuratData)
SeuratData::InstallData("pbmc3k")

pbmc3k.final <- LoadData("pbmc3k", type = "pbmc3k.final") #加载处理后的数据集
pbmc3k.final$groups <- sample(c("group1", "group2"), size = ncol(pbmc3k.final), replace = TRUE)
#将所有细胞随机分为两组,模拟实验中的不同处理条件
#nol()用于获取细胞的数量(列数)
#sample()函数用于生成随机的分组标签,replace=true表示可以重复分发分组标签
#这里的分组仅为方便教学使用,没有生物学意义
features <- c("LYZ", "CCL5", "IL32", "PTPRCAP", "FCGR3A", "PF4")
pbmc3k.final

RidgePlot(pbmc3k.final, features = features, ncol = 2)
#ncol为列数的意思,也就是设置生成的图为两列。

VlnPlot(pbmc3k.final, features = features)

FeaturePlot(pbmc3k.final, features = features)

DotPlot(pbmc3k.final, features = features) + RotatedAxis()
#RotatedAxis()可以使得坐标轴标签旋转一定角度,防止坐标轴上的标签出现重叠的情况。

DoHeatmap(subset(pbmc3k.final, downsample = 100), features = features, size = 3)
#subset()函数可以从每个细胞集群中选择100个细胞进行展示,避免图象过于密集难以阅读。
#选择细胞的数量可以通过downsample这一参数进行调整。

FeaturePlot(pbmc3k.final, features = "MS4A1") + FeaturePlot(pbmc3k.final, features = "MS4A1", min.cutoff = 1, max.cutoff = 3)
#上图为原始图象,下图为调整后的图象

FeaturePlot(pbmc3k.final, features = c("MS4A1", "PTPRCAP"), min.cutoff = "q10", max.cutoff = "q90")

FeaturePlot(pbmc3k.final, features = c("MS4A1", "CD79A"), blend = TRUE)

FeaturePlot(pbmc3k.final, features = c("MS4A1", "CD79A"), split.by = "groups")

FeaturePlot(pbmc3k.final, features = c("MS4A1", "PTPRCAP"), min.cutoff = "q10", max.cutoff = "q90", blend = TRUE, split.by = "groups")

VlnPlot(pbmc3k.final, features = "percent.mt", split.by = "groups")

DotPlot(pbmc3k.final, features = features, split.by = "groups") + RotatedAxis()

DimPlot(pbmc3k.final)

pbmc3k.final.no.umap <- pbmc3k.final
pbmc3k.final.no.umap[["umap"]] <- NULL
DimPlot(pbmc3k.final.no.umap)

DimPlot(pbmc3k.final,reduction = "pca")

DoHeatmap(pbmc3k.final, features = VariableFeatures(pbmc3k.final)[1:100], cells = 1:500, size = 4, angle = 90) + NoLegend()
#NoLegend()即删除图例。

baseplot <- DimPlot(pbmc3k.final, reduction = "umap")
baseplot + labs(title = "Clustering of 2,700 PBMCs")

remotes::install_github('sjessa/ggmin')
baseplot + ggmin::theme_powerpoint()

baseplot + DarkTheme()

baseplot + FontSize(x.title = 20, y.title = 20) + NoLegend()

plot <- FeaturePlot(pbmc3k.final, features = "MS4A1") #生成特殊图
HoverLocator(plot = plot, information = FetchData(pbmc3k.final, vars = c("ident", "PC_1", "nFeature_RNA")))
#Seurat包中的HoverLocator()函数可以为我们提供可视化功能
#FetchData()函数可以抓取pbmc3k.fianl中“ident(所属细胞簇)”“PC_1(主成分1)”“nFeature_RNA(细胞内该基因转录RNA数量)”

pbmc3k.final <- RenameIdents(pbmc3k.final, DC = "CD14+ Mono")
plot <- DimPlot(pbmc3k.final, reduction = "umap")
select.cells <- CellSelector(plot = plot)
#在运行上一行之后,可以在图像中选中所需要的细胞,并点击图象右上角的“Done”完成选中

head(select.cells) #展示选中的细胞

Idents(pbmc3k.final, cells = select.cells) <- "NewCells"
# 将选中的细胞定义为新细胞集群。
newcells.markers <- FindMarkers(pbmc3k.final, ident.1 = "NewCells", ident.2 = "CD14+ Mono", min.diff.pct = 0.3, only.pos = TRUE)
# 以CD14+ Monocyte为参照,寻找新细胞集群中的差异表达基因。
# min.diff.pct为表达比例差异过滤阈值,值越大筛选出的差异表达基因越少、“含金量”更高
head(newcells.markers)

levels(pbmc3k.final)#标记前
pbmc3k.final <- CellSelector(plot = plot, object = pbmc3k.final, ident = "selected")
levels(pbmc3k.final)#标记后

plot <- DimPlot(pbmc3k.final, reduction = "pca") + NoLegend()
LabelClusters(plot = plot, id = "ident")

LabelPoints(plot = plot, points = TopCells(object = pbmc3k.final[["pca"]]), repel = TRUE)

plot1 <- DimPlot(pbmc3k.final)
plot2 <- FeatureScatter(pbmc3k.final, feature1 = "LYZ", feature2 = "CCL5") #绘制两个基因在所有细胞中的表达量相关性散点图
plot1 + plot2 #合并图象