在《Seurat的常见分析工作流程:以PBMC_3K数据集为例》这篇文章中,我们使用了LogNormalize(当时我们称其为“对数标准化”)的方法对单细胞数据集进行标准化。这种方法的原理是将每个细胞的基因表达值除以该细胞基因的总表达量,再乘以缩放因子数(一般为10000),最后对结果进行对数转换得到标准化的表达量,从而消除不同细胞之间总UMI数的差异。
不过,当时我们也提到过,LogNormalize具有其局限性。细胞间总UMI数的差距并不能全部归因于测序深度的差异,不同细胞基因的表达水平存在着天然差异,因此“一刀切”式的调整,也有可能会对分析引入新的偏差。为了更加精细地分离这种差异,我们可以使用Seurat包的SCTransform来标准化。
在开始讲解之前,我们先把前面几步流程先做了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| install.packages(c("Seurat","ggplot2","sctransform","patchwork"))
library(Seurat)
library(sctransform)
library(ggplot2)
library(patchwork)
#创建Seurat对象
pbmc.data <- Read10X(data.dir = "C:/Users/86150/Downloads/pbmc3k_filtered_gene_bc_matrices/filtered_gene_bc_matrices/hg19")
pbmc <- CreateSeuratObject(counts = pbmc.data, project = "pbmc3k", min.cells = 3,min.features = 200)
#质量控制
pbmc <- PercentageFeatureSet(pbmc, pattern = "^MT-", col.name = "percent.mt")
pbmc <- subset(pbmc, subset = nFeature_RNA > 200 & nFeature_RNA < 2500 & percent.mt < 5)
|
SCTransfrom的基本原理是,通过建模预测每个基因的“正常值”,再用实际值与预测值的偏差(残差)来消除技术噪音,从而保留真实的生物学差异。SCTransform可以替代传统工作流程中的NormalizeData()、ScaleData()和FindVariableFeatures()这三个函数,也就是说,如果我们采用SCTransform进行标准化,我们就无需额外进行LogNormalize标准化、识别高变基因和数据缩放这三个步骤,可以直接开始降维。
glmGAMPoi包可以极大地提升计算速度,如果安装了这一R包将会默认使用其进行加速。没有安装也没关系,安装+计算的时间似乎比直接计算慢得多(bushi
SCTransform也允许我们在建模过程中剔除掉一些混杂因素的影响,比如线粒体基因数。
1
2
3
| install.packages('BiocManager')
BiocManager::install('glmGamPoi')
pbmc <- SCTransform(pbmc, vars.to.regress = "percent.mt", verbose = FALSE)
|
继续标准分析流程:PCA降维、细胞聚类和UMAP降维
1
2
3
4
5
6
| pbmc <- RunPCA(pbmc, features = VariableFeatures(object = pbmc))
pbmc <- FindNeighbors(pbmc, dims = 1:30) #KNN算法
pbmc <- FindClusters(pbmc, resolution = 0.5) #Louvain算法
pbmc <- RunUMAP(pbmc, dims = 1:30)
DimPlot(pbmc, label = TRUE)
|
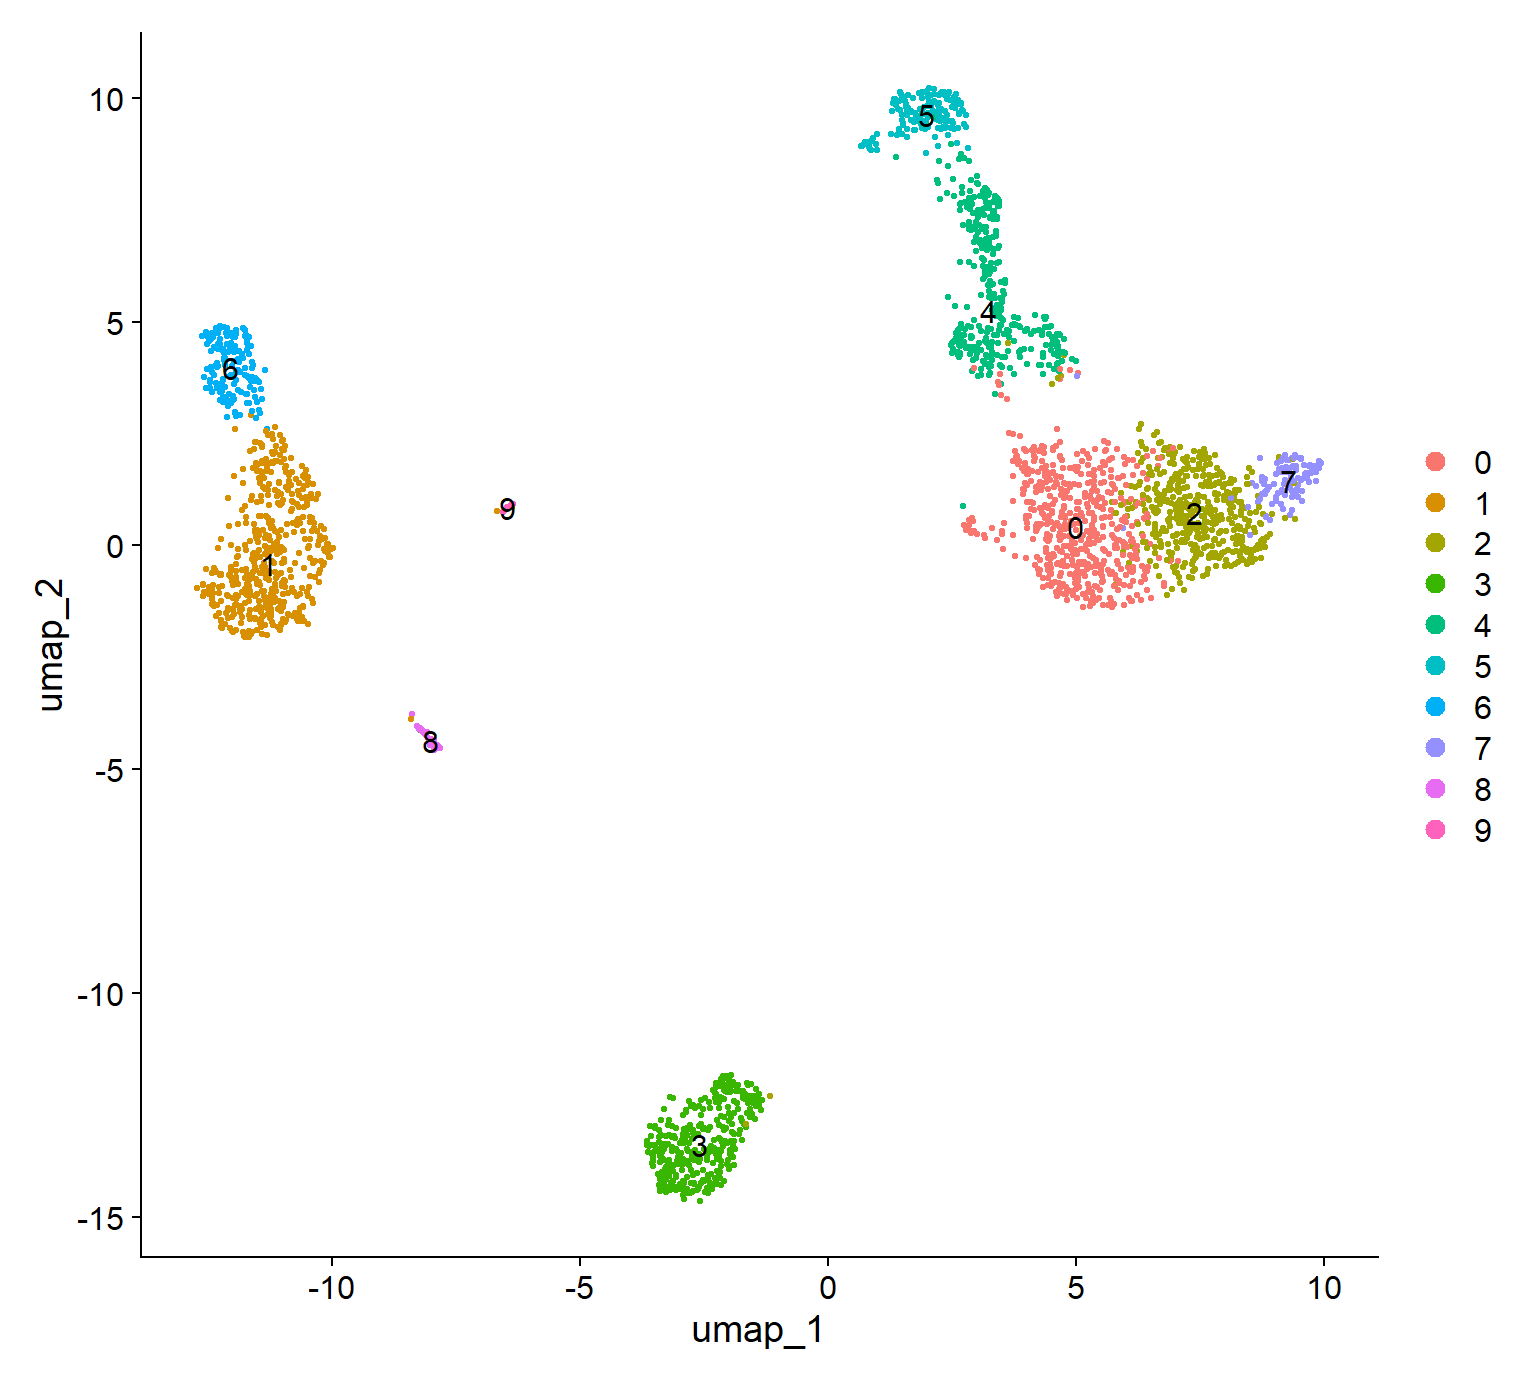
值得一提的是,刚刚我们省略了“确认维度”这一步。这是因为我们在SCTransform的过程中更加精细地调整了测序深度的差异,使得标准化之后的数据更加可靠。所以,我们可以更加大胆地选择更多的主成分进行进一步的分析。
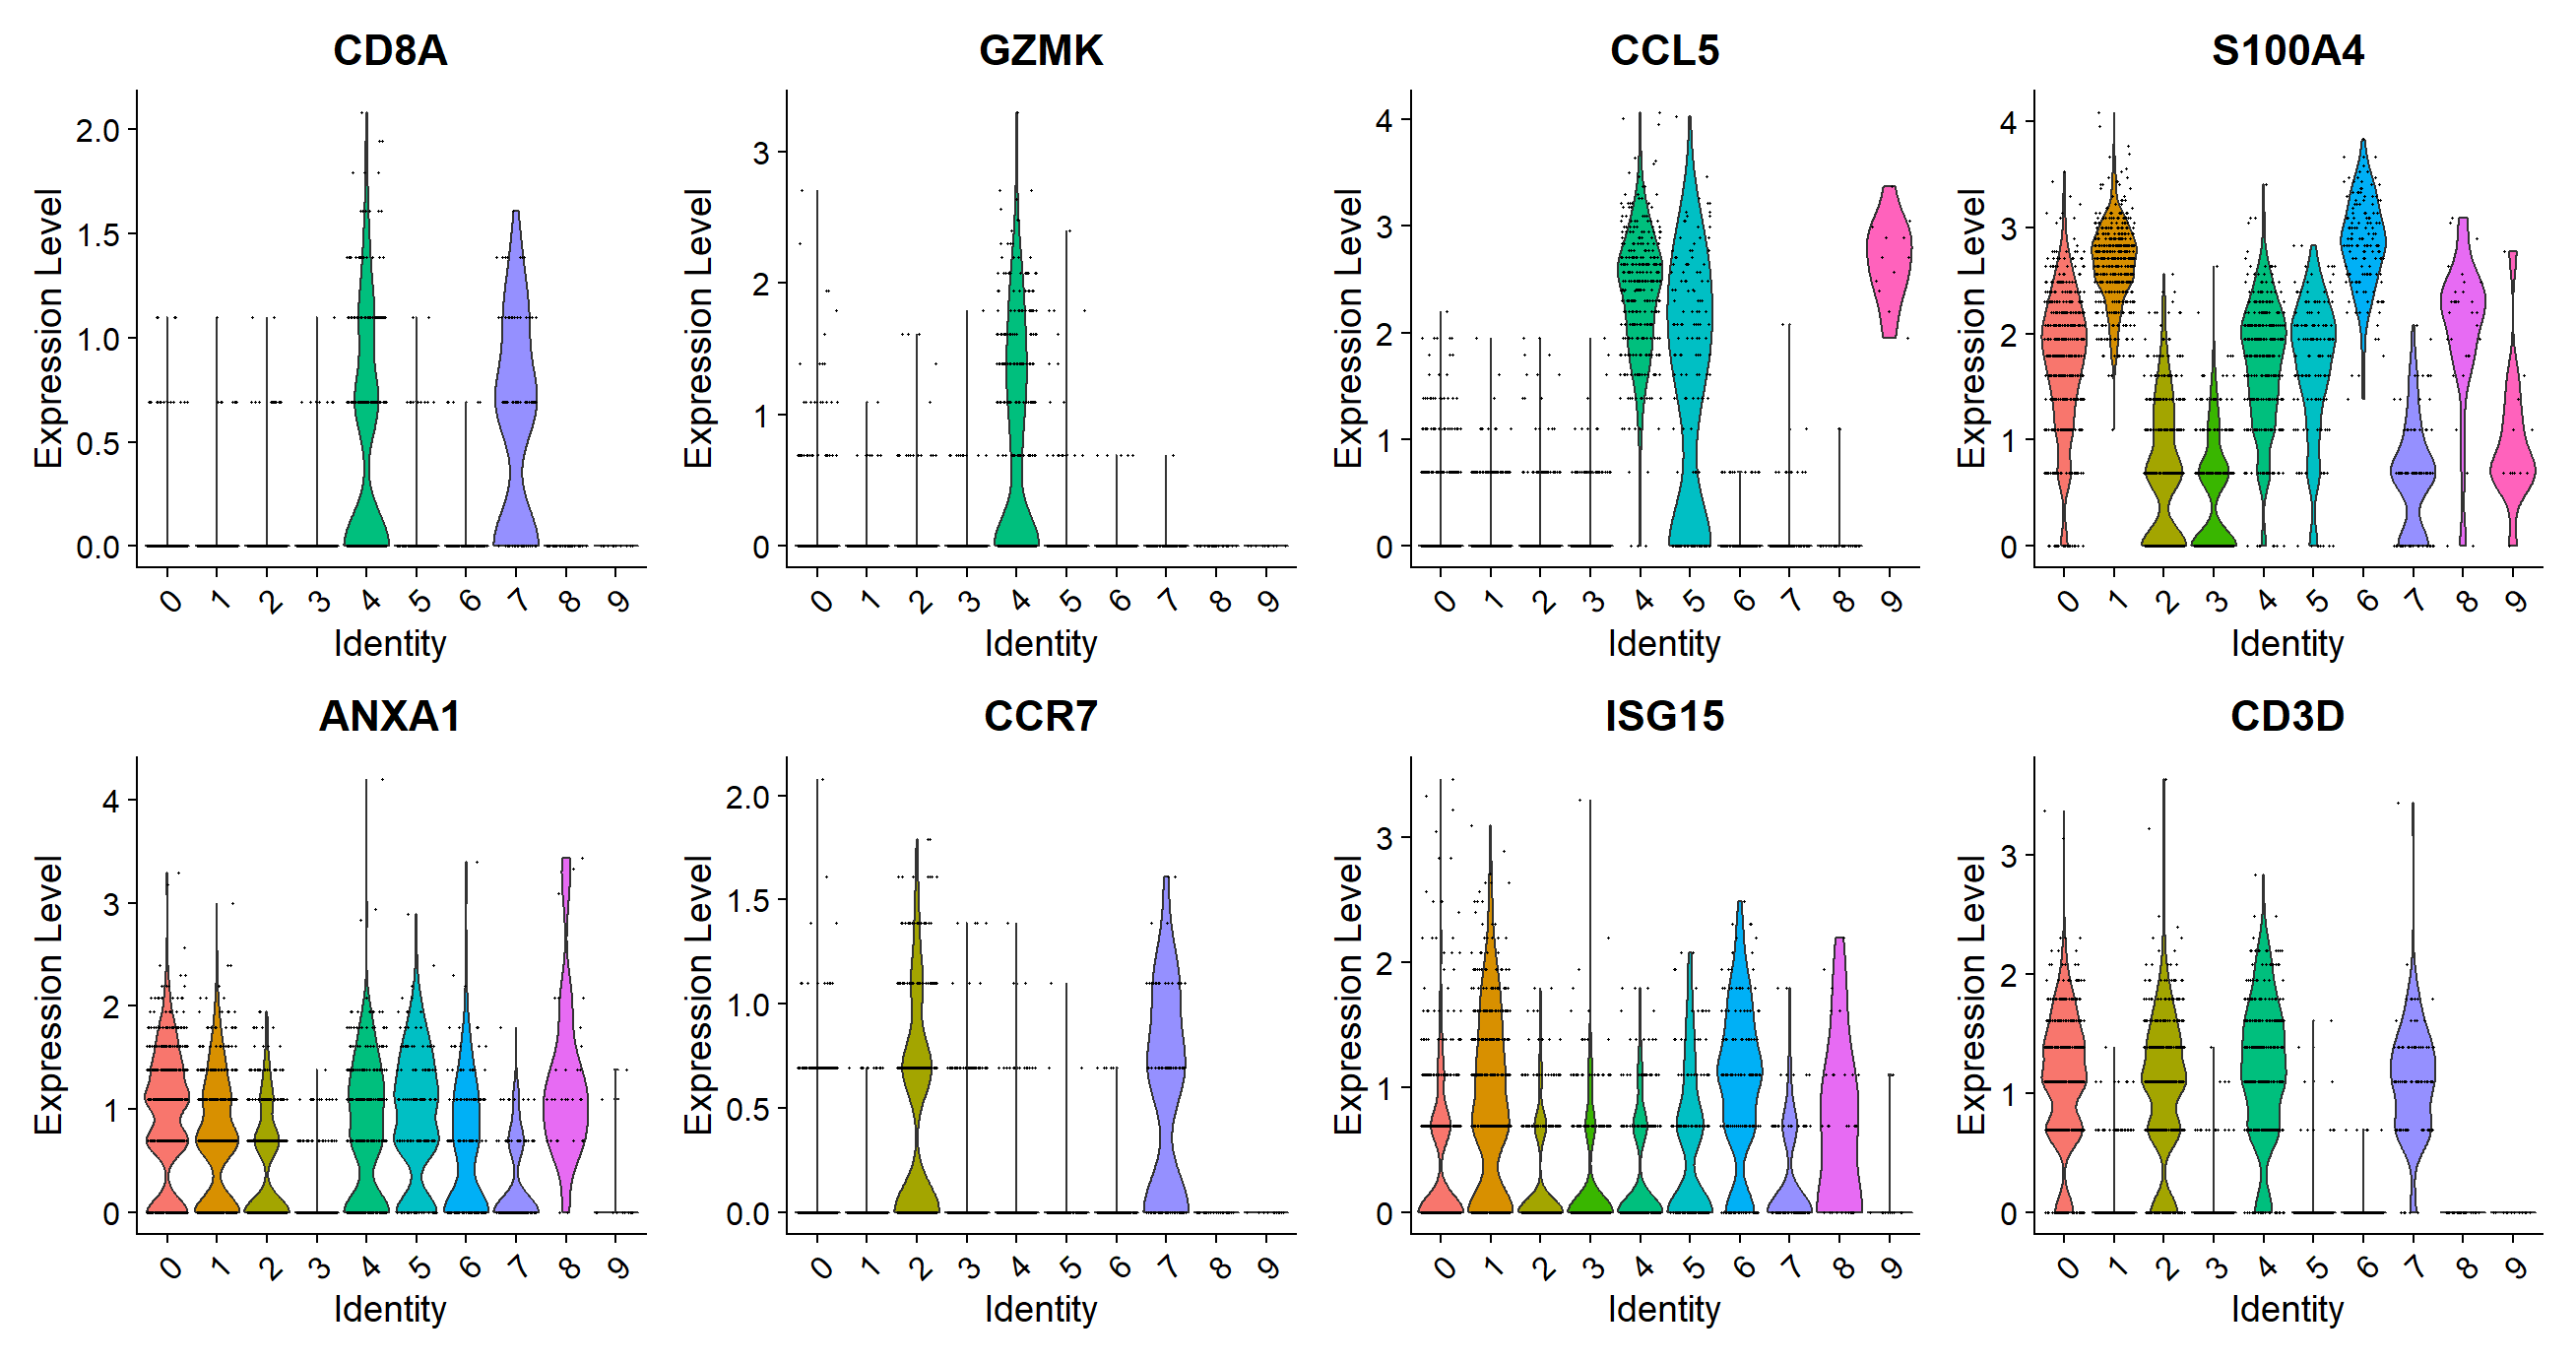
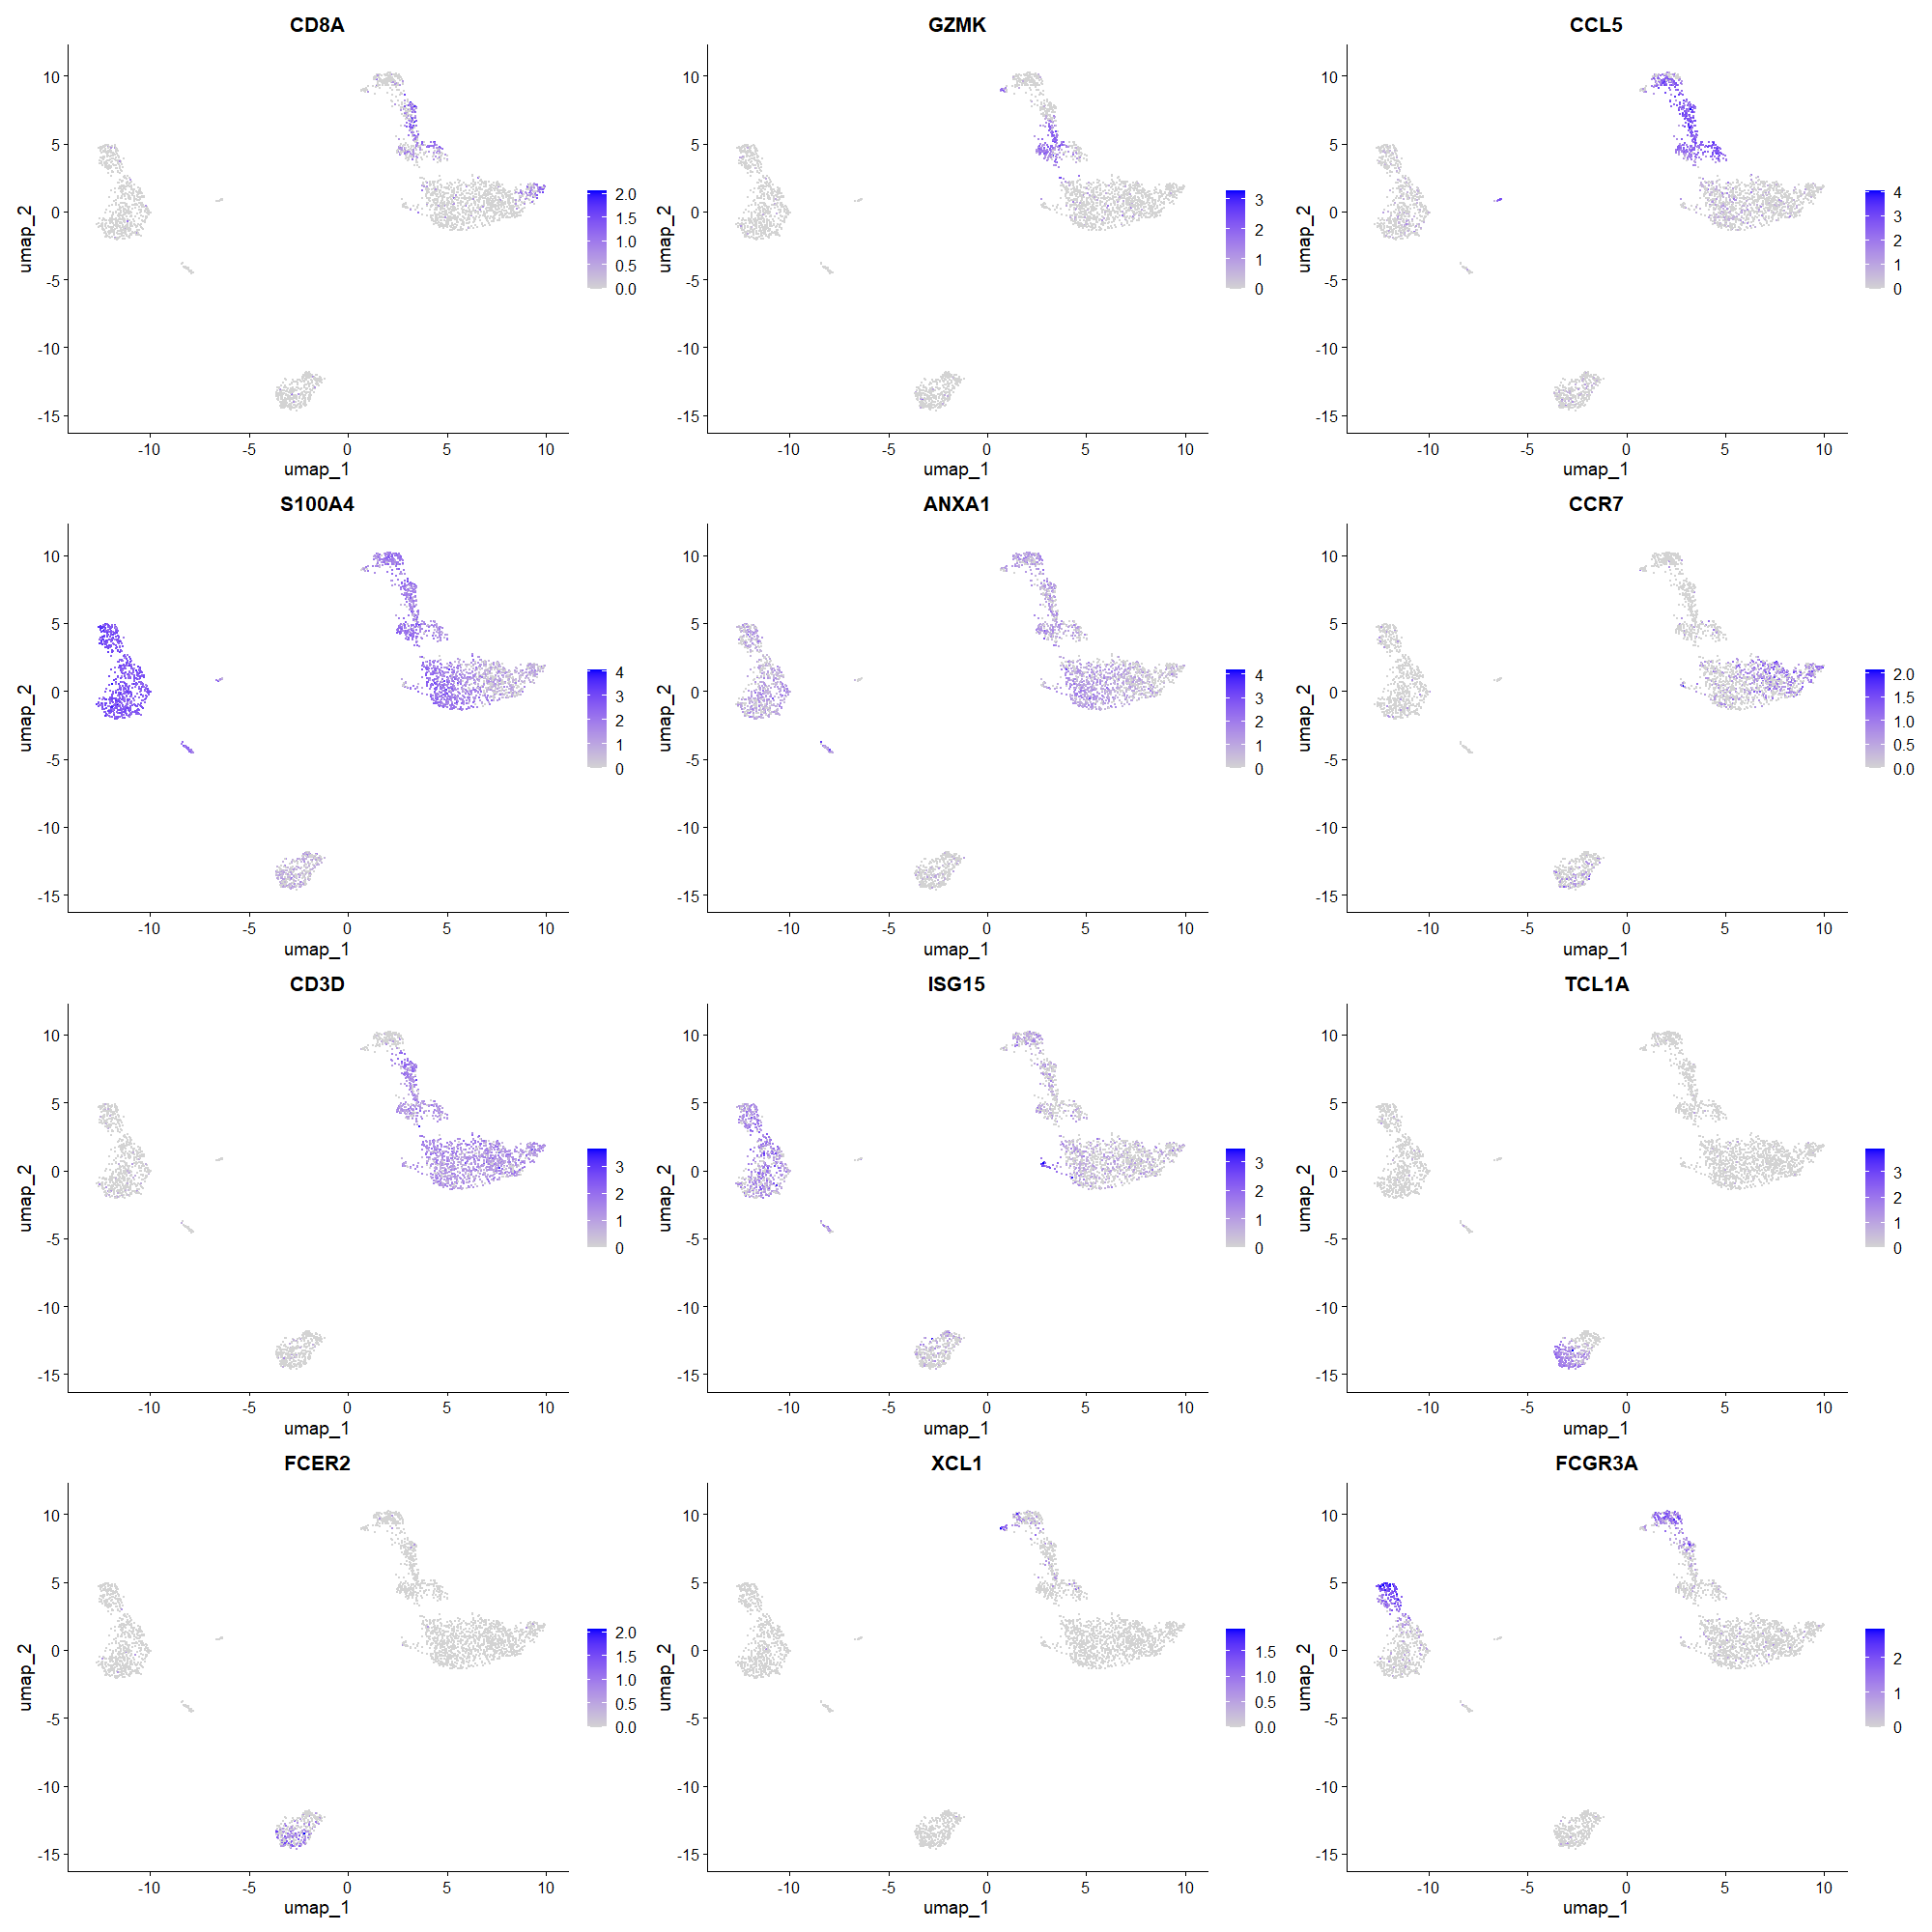
另外,得益于SCTransform算法的优势,我们能够更加精细地区分不同的细胞集群。
- 基于
CD8A、GZMK、CCL5、CCR7基因的表达水平,分离出至少3个CD8 T细胞亚群(原始、记忆、效应)。
- 基于
S100A4、CCR7、IL32、ISG15基因的表达水平,分离出3个CD4 T细胞亚群(原始、记忆、IFN激活)
- 基于
TCL1A、FCER2基因的表达水平,分离出B细胞的其他亚群。
- 基于
XCL1、FCGR3A基因的表达水平,将NK细胞进一步分为CD56dim和CD56bright两个亚群。
1
2
| VlnPlot(pbmc, features = c("CD8A", "GZMK", "CCL5", "S100A4", "ANXA1", "CCR7", "ISG15", "CD3D"), pt.size = 0.2, ncol = 4)
#pt.point means the size of points
|
1
| FeaturePlot(pbmc, features = c("CD8A", "GZMK", "CCL5", "S100A4", "ANXA1", "CCR7", "CD3D", "ISG15", "TCL1A", "FCER2", "XCL1", "FCGR3A"), pt.size = 0.2, ncol = 3)
|
完整代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| install.packages(c("Seurat","ggplot2","sctransform","patchwork"))
library(Seurat)
library(sctransform)
library(ggplot2)
library(patchwork)
#创建Seurat对象
pbmc.data <- Read10X(data.dir = "C:/Users/86150/Downloads/pbmc3k_filtered_gene_bc_matrices/filtered_gene_bc_matrices/hg19")
pbmc <- CreateSeuratObject(counts = pbmc.data, project = "pbmc3k", min.cells = 3,min.features = 200)
#质量控制
pbmc <- PercentageFeatureSet(pbmc, pattern = "^MT-", col.name = "percent.mt")
pbmc <- subset(pbmc, subset = nFeature_RNA > 200 & nFeature_RNA < 2500 & percent.mt < 5)
install.packages('BiocManager')
BiocManager::install('glmGamPoi')
pbmc <- SCTransform(pbmc, vars.to.regress = "percent.mt", verbose = FALSE)
#verbose = false 表示不显示详细的运行日志或进度信息
pbmc <- RunPCA(pbmc, features = VariableFeatures(object = pbmc))
pbmc <- FindNeighbors(pbmc, dims = 1:30) #KNN算法
pbmc <- FindClusters(pbmc, resolution = 0.5) #Louvain算法

pbmc <- RunUMAP(pbmc, dims = 1:30)
DimPlot(pbmc, label = TRUE)
VlnPlot(pbmc, features = c("CD8A", "GZMK", "CCL5", "S100A4", "ANXA1", "CCR7", "ISG15", "CD3D"), pt.size = 0.2, ncol = 4)
#pt.point means the size of points
FeaturePlot(pbmc, features = c("CD8A", "GZMK", "CCL5", "S100A4", "ANXA1", "CCR7", "CD3D", "ISG15", "TCL1A", "FCER2", "XCL1", "FCGR3A"), pt.size = 0.2, ncol = 3)
|