在一次实验中,我们可以对同一个细胞测量不同分子层面的数据(如基因表达、蛋白质表达、表观遗传修饰、空间分布等等),所测得的数据我们称之为多模态数据(multimodal data)。例如,CITE-seq可以同时检测单细胞的转录组RNA和表面蛋白表达水平;10X Multiome可以同时测量单细胞的转录组RNA和ATAC(染色质可及性)。本篇文章将以一个包括8617个脐带血单个核细胞(CBMC)的CITE-seq结果(包含转录组RNA测序和表面蛋白丰度估计值)的数据集,介绍如何使用Seurat包对多模态数据进行分析。

导入数据,创建Seurat对象,并加入RNA和表面蛋白数据

官方教程中介绍的方法如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
library(Seurat)
library(ggplot2)
library(patchwork)

# 注意:这份数据同时存在人和小鼠的细胞,分别冠有"HUMAN_"和"MOUSE_"的前缀。

# 导入RNA数据
cbmc.rna <- as.sparse(read.csv(file = "/brahms/shared/vignette-data/GSE100866_CBMC_8K_13AB_10X-RNA_umi.csv.gz",
sep = ",", header = TRUE, row.names = 1))

# 在本例中,我们将删除除了100个表达水平最高的小鼠基因之外的所有小鼠基因,并且移除人源基因前面的HUMAN_标记。
cbmc.rna <- CollapseSpeciesExpressionMatrix(cbmc.rna)


# 载入表面蛋白丰度数据
cbmc.adt <- as.sparse(read.csv(file = "/brahms/shared/vignette-data/GSE100866_CBMC_8K_13AB_10X-ADT_umi.csv.gz",
sep = ",", header = TRUE, row.names = 1))

# 在多模态数据中,不同类型的数据往往相互对应;更直白的讲,一个细胞中的RNA和表面蛋白丰度应该相互匹配,不能出现一个细胞只有RNA数据,而表面蛋白丰度缺失;或反之的情况。
# all.equal()函数即可以对数据进行检查,具体来说,通过对比两列细胞的barcodes是否一致进行检查
# 若返回true,说明数据没问题,如果返回false,则说明数据可能出错了
all.equal(colnames(cbmc.rna), colnames(cbmc.adt))


cbmc <- CreateSeuratObject(counts = cbmc.rna) #基于转录组RNA数据,创建Seurat对象
# create a new assay to store ADT information
adt_assay <- CreateAssay5Object(counts = cbmc.adt) #新建一个assay,用于存储表面蛋白丰度数据
cbmc[["ADT"]] <- adt_assay #将新建的assay加入到Seurat对象中

然而,由于官方所给的下载链接为ftp协议(需要进行一系列复杂的设置才能正常下载……然鹅我到现在也没有下载成,伟大如Deepseek也在ftp面前落败),本文章改用下述方法直接下载并加载Seurat数据集。

1
2
3
4
5
6
7
8
9
library(Seurat)
library(patchwork)
library(ggplot2)
library(SeuratData)
InstallData("cbmc")
data("cbmc")
Assays(cbmc) #查看cbmc中存在多少个assay
cbmc = UpdateSeuratObject(object = cbmc) #更新Seurat对象结构,否则后续会报错(好像是什么没有images之类的)
all.equal(colnames(cbmc[["RNA"]]), colnames(cbmc[["ADT"]])) #检查数据,具体如前述。
  • 运行结果:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
Assays(cbmc)
[1] "RNA" "ADT"
> cbmc = UpdateSeuratObject(object = cbmc)
Validating object structure
Updating object slots
Ensuring keys are in the proper structure
Warning: Assay RNA changing from Assay to Assay
Warning: Assay ADT changing from Assay to Assay
Ensuring keys are in the proper structure
Ensuring feature names don't have underscores or pipes
Updating slots in RNA
Updating slots in ADT
Validating object structure for Assay ‘RNA’
Validating object structure for Assay ‘ADT’
Object representation is consistent with the most current Seurat version
> all.equal(colnames(cbmc[["RNA"]]), colnames(cbmc[["ADT"]]))
[1] TRUE

对于导入好的数据,我们可以:

1
2
3
4
5
6
7
8
9
# 用`rownames()`函数查看我们所测定的特征(基因)列表:
rownames(cbmc[["ADT"]])

# 切换Assay的默认值,默认使用RNA或ADT数据进行分析:
DefaultAssay(cbmc) # 查看默认Assay
DefaultAssay(cbmc) <- "ADT" #修改默认Assay为ADT
DefaultAssay(cbmc) # 再次查看默认Assay

# 当然,我们可以通过直接在函数中手动调整Assay参数来实现对不同Assay的分析。
  • 运行结果:
1
2
3
4
5
6
7
> Assays(cbmc)
[1] "RNA" "ADT"
> DefaultAssay(cbmc)
[1] "RNA"
> DefaultAssay(cbmc) <- "ADT"
> DefaultAssay(cbmc)
[1] "ADT"

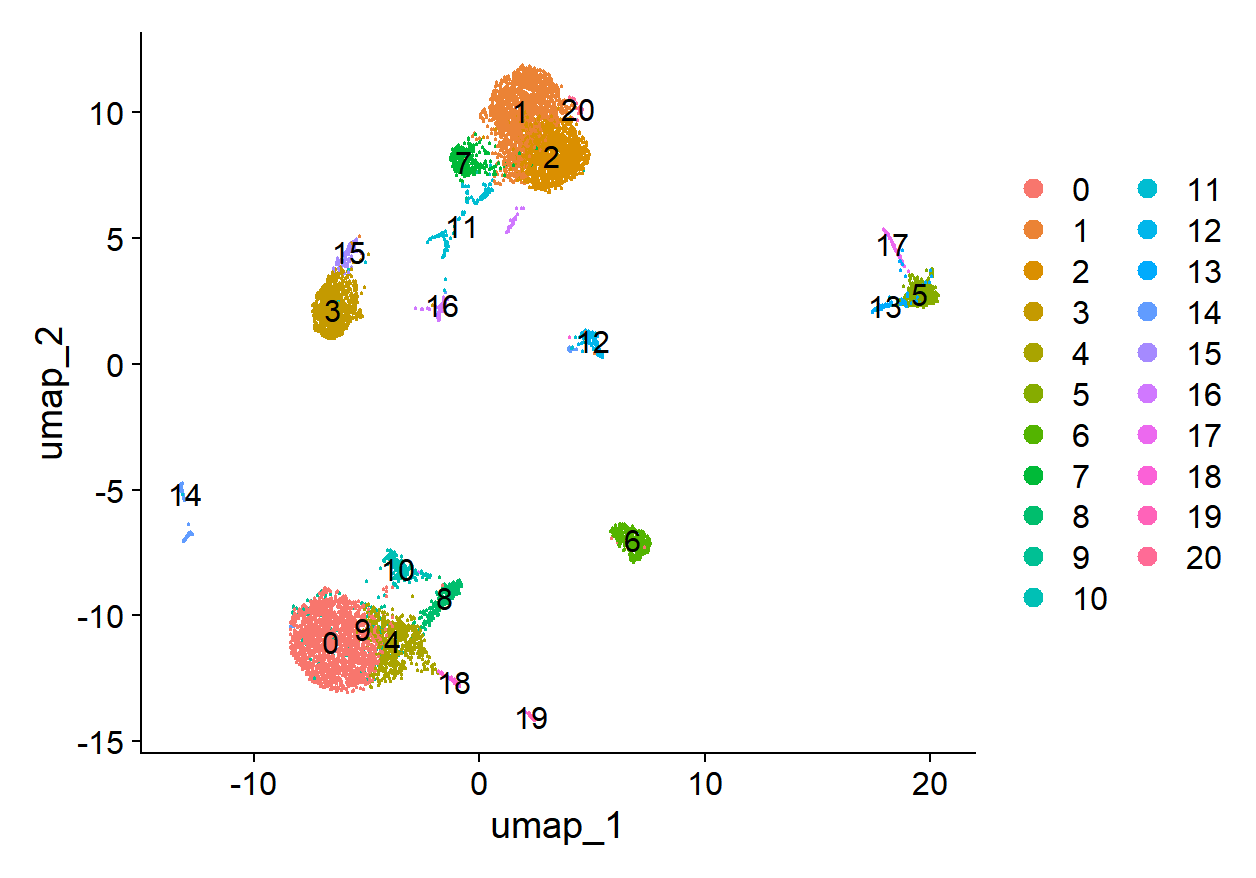
根据转录组测序结果进行细胞聚类

这一步和《Seurat的常见分析工作流程:以PBMC_3K数据集为例》这篇文章中所提到的其实是一样的,但要记得先把上一步被我们切走的默认Assay值切回来(欸嘿!)。

1
2
3
4
5
6
7
8
9
DefaultAssay(cbmc) <- "RNA"
cbmc <- NormalizeData(cbmc)
cbmc <- FindVariableFeatures(cbmc)
cbmc <- ScaleData(cbmc)
cbmc <- RunPCA(cbmc, verbose = FALSE)
cbmc <- FindNeighbors(cbmc, dims = 1:30)
cbmc <- FindClusters(cbmc, resolution = 0.8, verbose = FALSE)
cbmc <- RunUMAP(cbmc, dims = 1:30)
DimPlot(cbmc, label = TRUE)

多模态数据的并排可视化

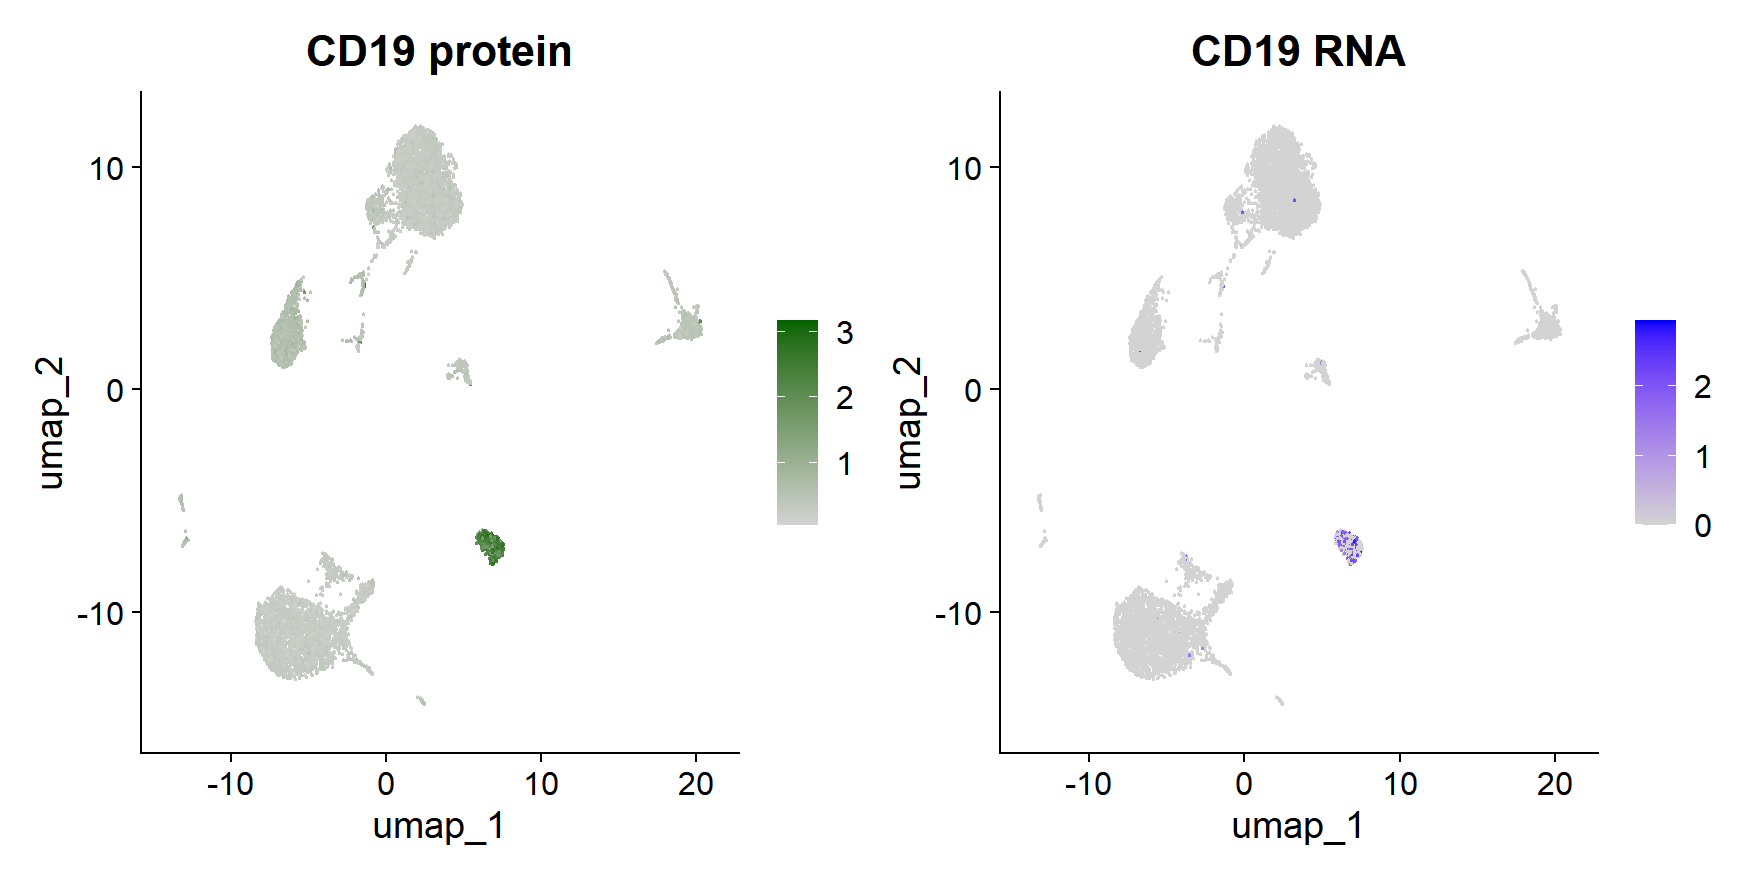
如果想研究某一个基因在不同细胞中的转录水平和蛋白质表达水平的对应关系(或者相互验证某一基因的表达情况),我们可以通过将多模态数据并排可视化。

1
2
3
4
5
6
cbmc <- NormalizeData(cbmc, normalization.method = "CLR", margin = 2, assay = "ADT")
DefaultAssay(cbmc) <- "ADT"
p1 <- FeaturePlot(cbmc, "CD19", cols = c("lightgrey", "darkgreen")) + ggtitle("CD19 protein")
DefaultAssay(cbmc) <- "RNA"
p2 <- FeaturePlot(cbmc, "CD19") + ggtitle("CD19 RNA")
p1 | p2 #横排显示p1和p2

  • 标记了一处问题:为什么ADT数据使用CLR进行标准化?(查了很多资料没有搞懂,先放放)

在不同的Assay中,特征名可能重名。比如,在RNA和ADT这两个Assay中都有一列CD19的数据,那么可能会冲突而影响分析。为了避免这种情况,每一个Assay均有其唯一标识符,称为“Key”。默认情况下,RNA的Key为“rna_”,ADT的Key为“adt_”。我们也可以通过key()查询不同Assay的唯一标识符,在后续过程中通过明确key参数来指定对哪一个Assay的数据进行处理,而不用频繁地切换默认Assay。

1
2
Key(cbmc[["RNA"]])
Key(cbmc[["ADT"]])
  • 运行结果:
1
2
3
4
> Key(cbmc[["RNA"]])
[1] "rna_"
> Key(cbmc[["ADT"]])
[1] "adt_"
1
2
3
p1 <- FeaturePlot(cbmc, "adt_CD19", cols = c("lightgrey", "darkgreen")) + ggtitle("CD19 protein")
p2 <- FeaturePlot(cbmc, "rna_CD19") + ggtitle("CD19 RNA")
p1 | p2

输出的图象同上,这里不再重复。

鉴定不同细胞集群的表面蛋白标记

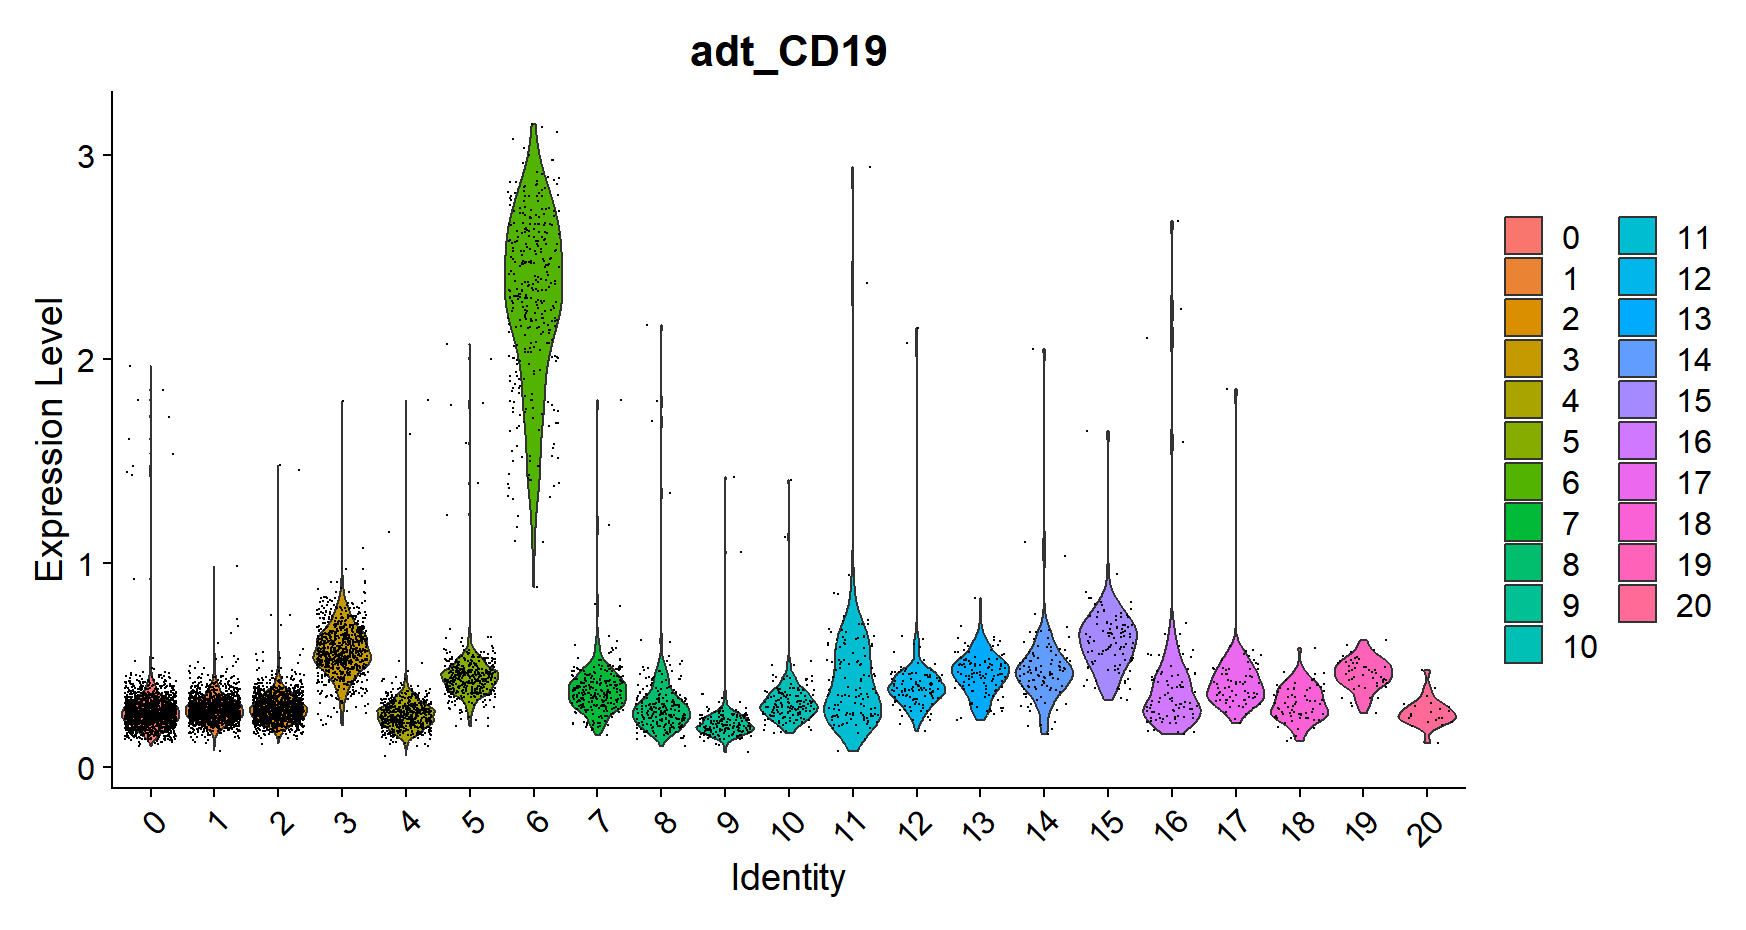
我们知道,CD19是B细胞的标志,通过绘制小提琴图我们可以识别B细胞集群(细胞集群6)。

1
VlnPlot(cbmc, "adt_CD19")

通过FindMarkers()函数,我们可以找出该细胞簇中差异表达的RNA和蛋白质。

1
2
3
4
adt_markers <- FindMarkers(cbmc, ident.1 = 6, assay = "ADT")
rna_markers <- FindMarkers(cbmc, ident.1 = 6, assay = "RNA")
head(adt_markers)
head(rna_markers)
  • 运行结果:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
> head(adt_markers)
p_val avg_log2FC pct.1 pct.2 p_val_adj
CD19 1.764302e-215 2.7444758 1 1 1.764302e-214
CD45RA 1.581574e-121 0.5840419 1 1 1.581574e-120
CD14 1.216541e-102 -1.0143010 1 1 1.216541e-101
CD4 1.116804e-100 -1.6788367 1 1 1.116804e-99
CD3 6.247313e-78 -1.5884973 1 1 6.247313e-77
CD56 3.131803e-30 0.2355264 1 1 3.131803e-29
> head(rna_markers)
p_val avg_log2FC pct.1 pct.2 p_val_adj
IGHM 0 6.660187 0.977 0.044 0
CD79A 0 6.748356 0.965 0.045 0
TCL1A 0 7.428099 0.904 0.028 0
CD79B 0 5.525568 0.944 0.089 0
IGHD 0 7.811884 0.857 0.015 0
MS4A1 0 7.523215 0.851 0.016 0

多模态数据的其他可视化方法

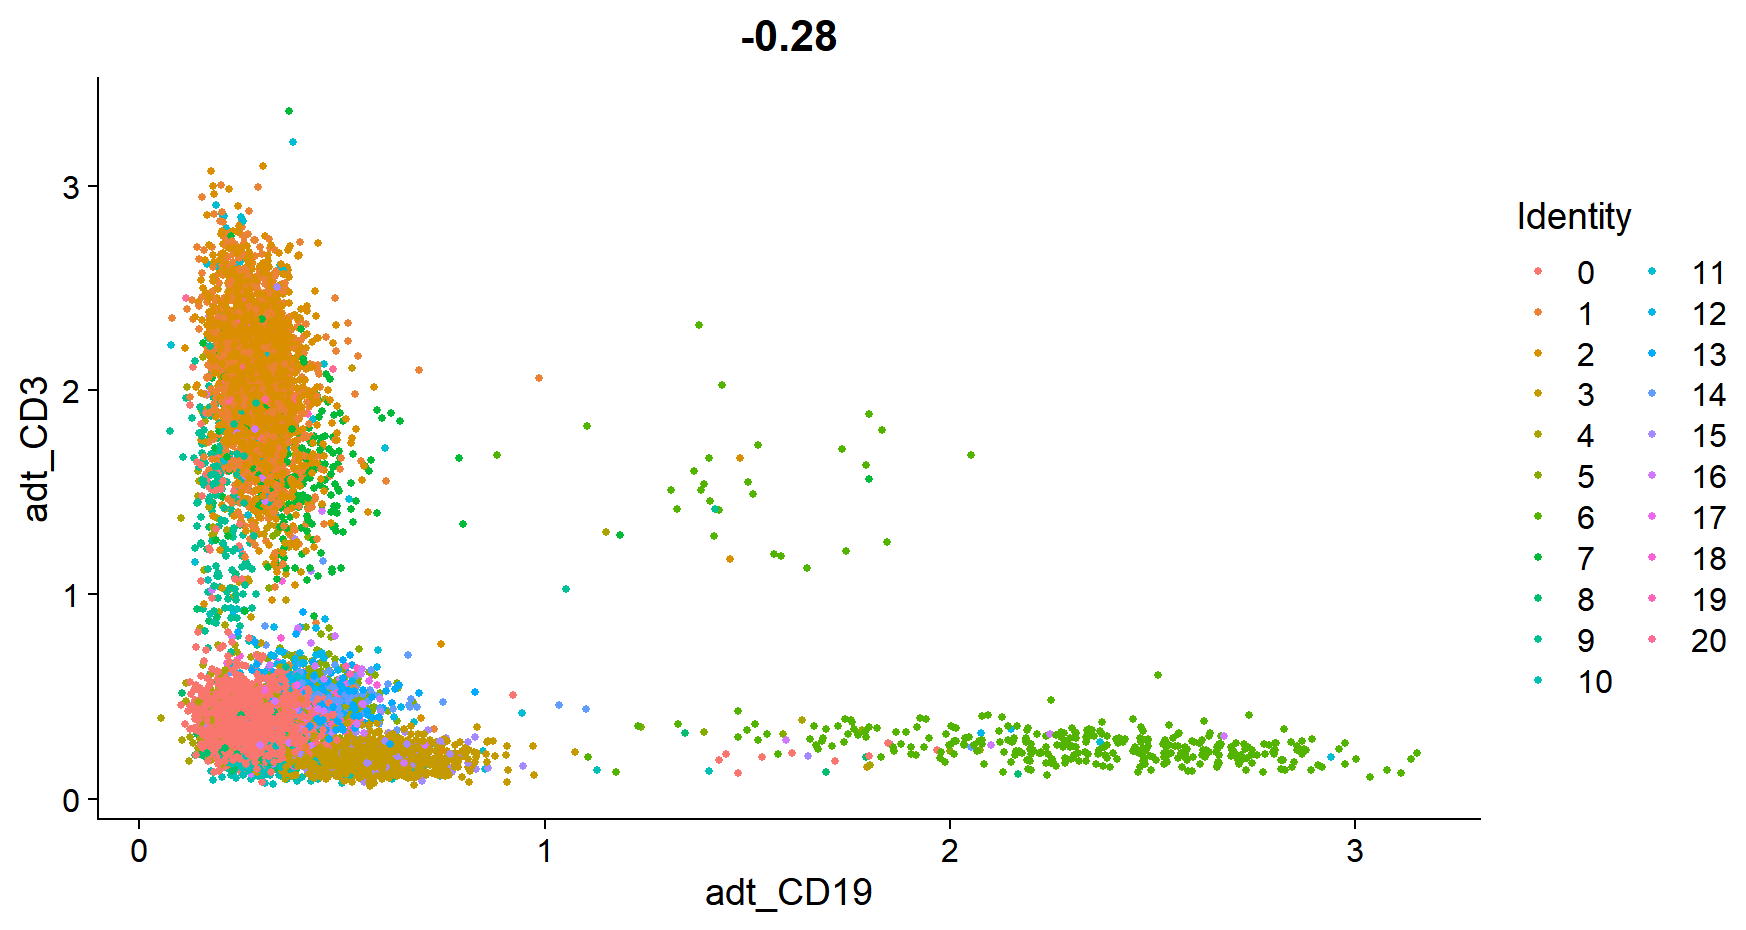
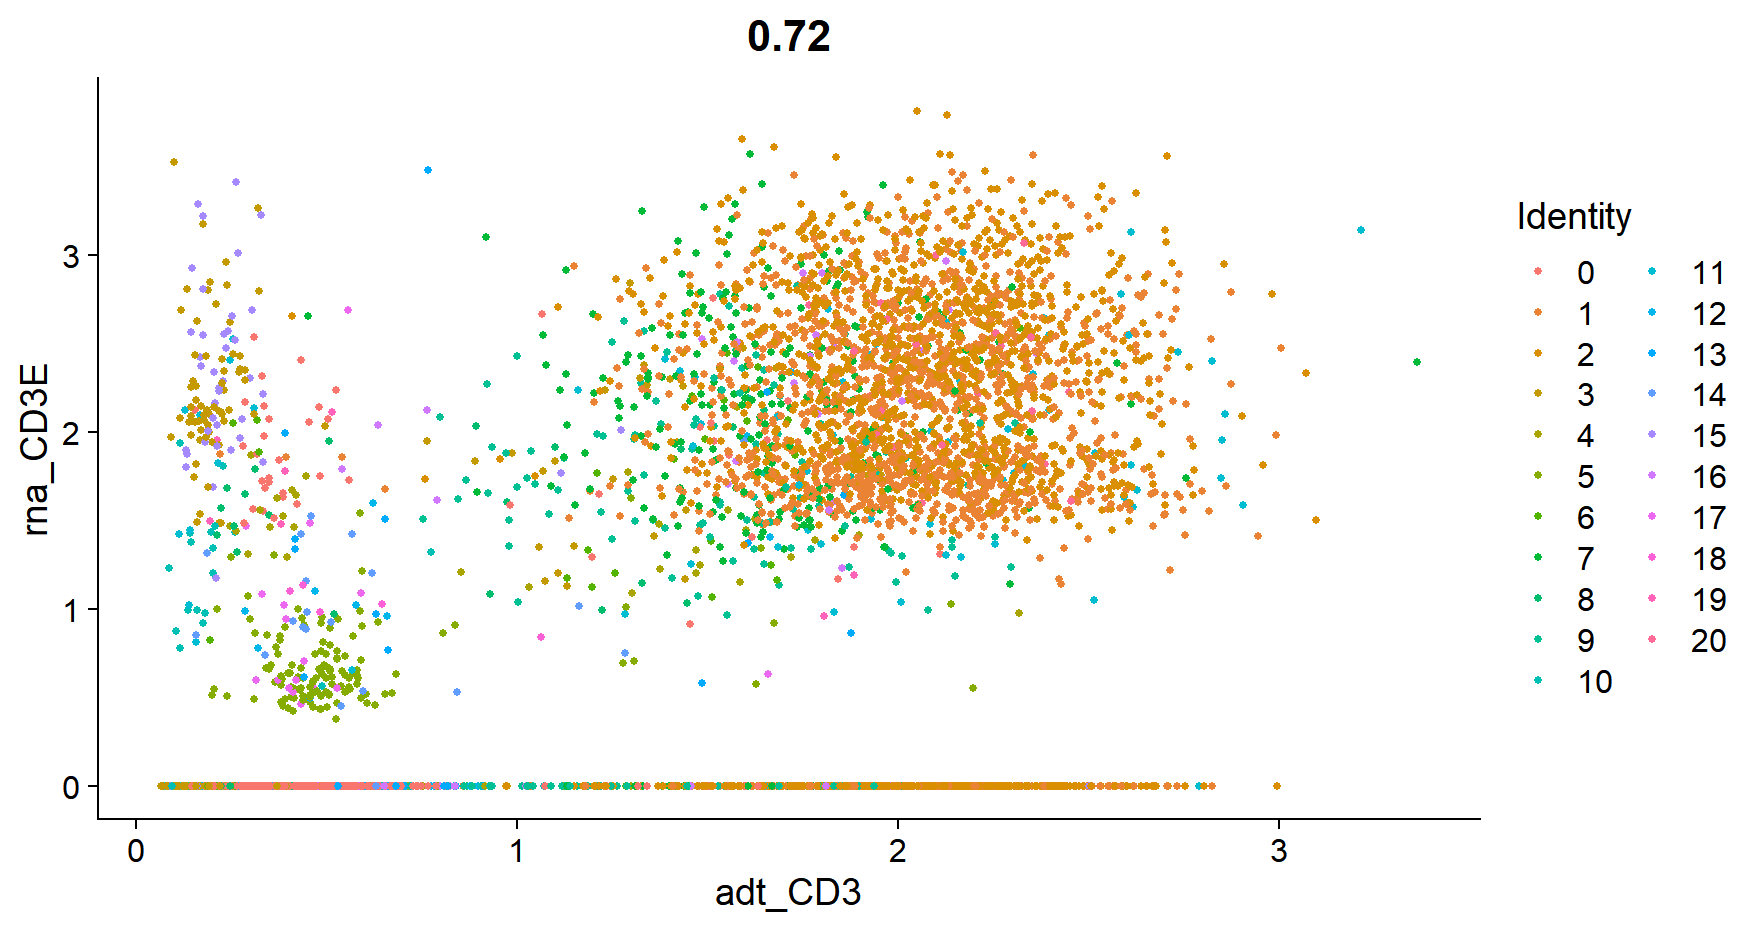
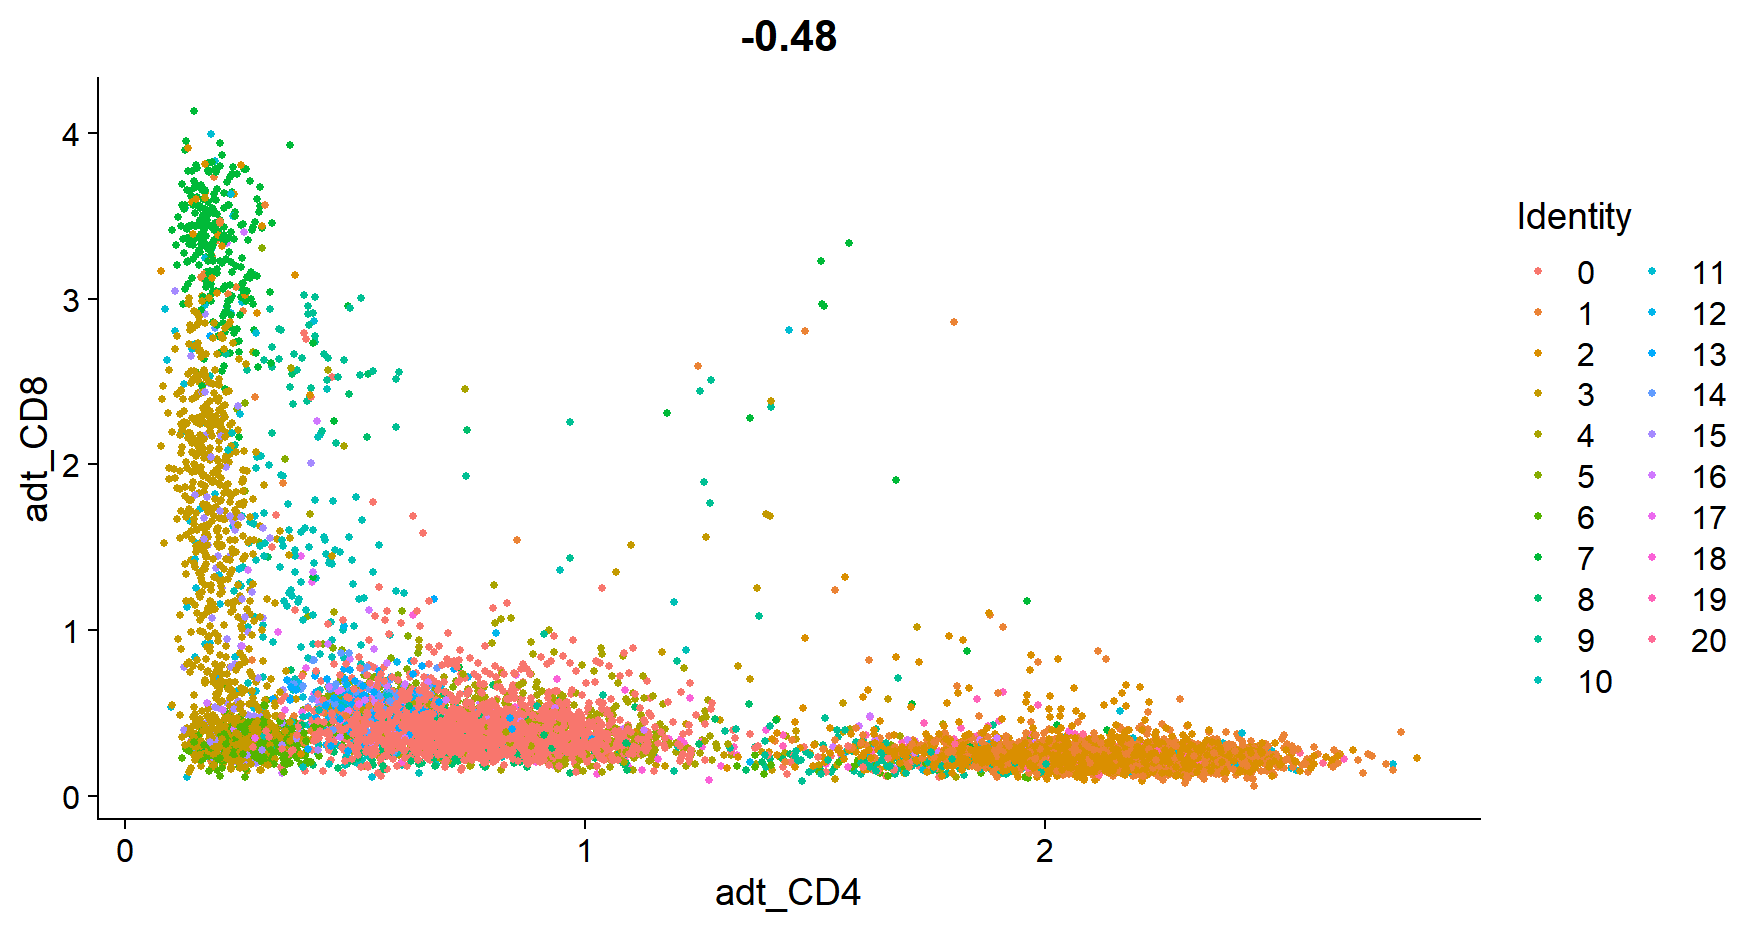
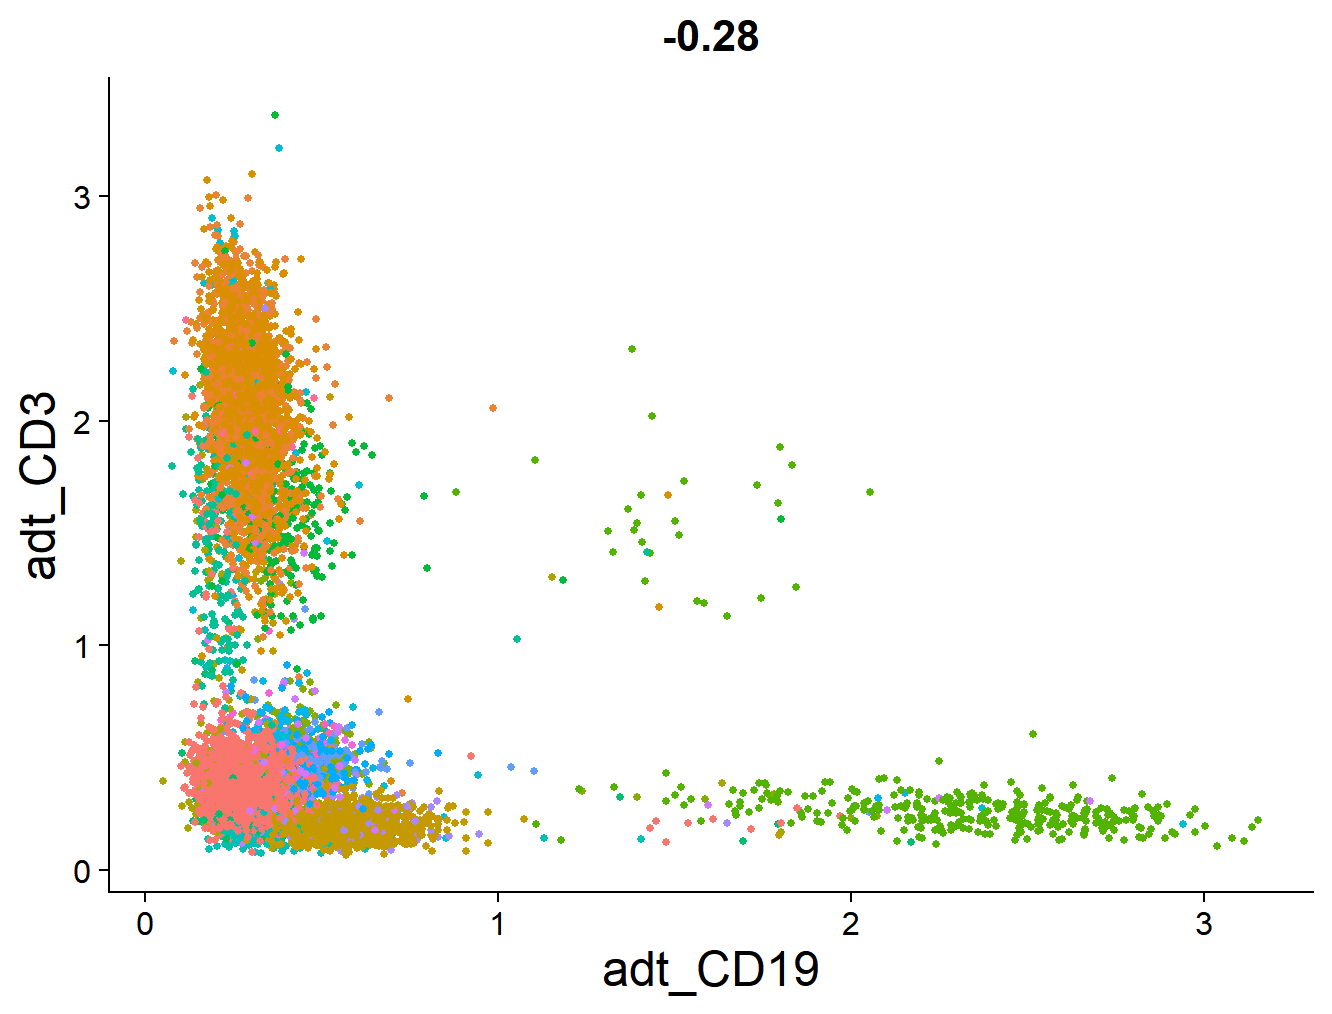
我们可以通过绘制散点图来可视化不同表面蛋白之间、RNA和蛋白质之间的表达关系。

1
FeatureScatter(cbmc, feature1 = "adt_CD19", feature2 = "adt_CD3")

1
FeatureScatter(cbmc, feature1 = "adt_CD3", feature2 = "rna_CD3E")

1
FeatureScatter(cbmc, feature1 = "adt_CD4", feature2 = "adt_CD8")

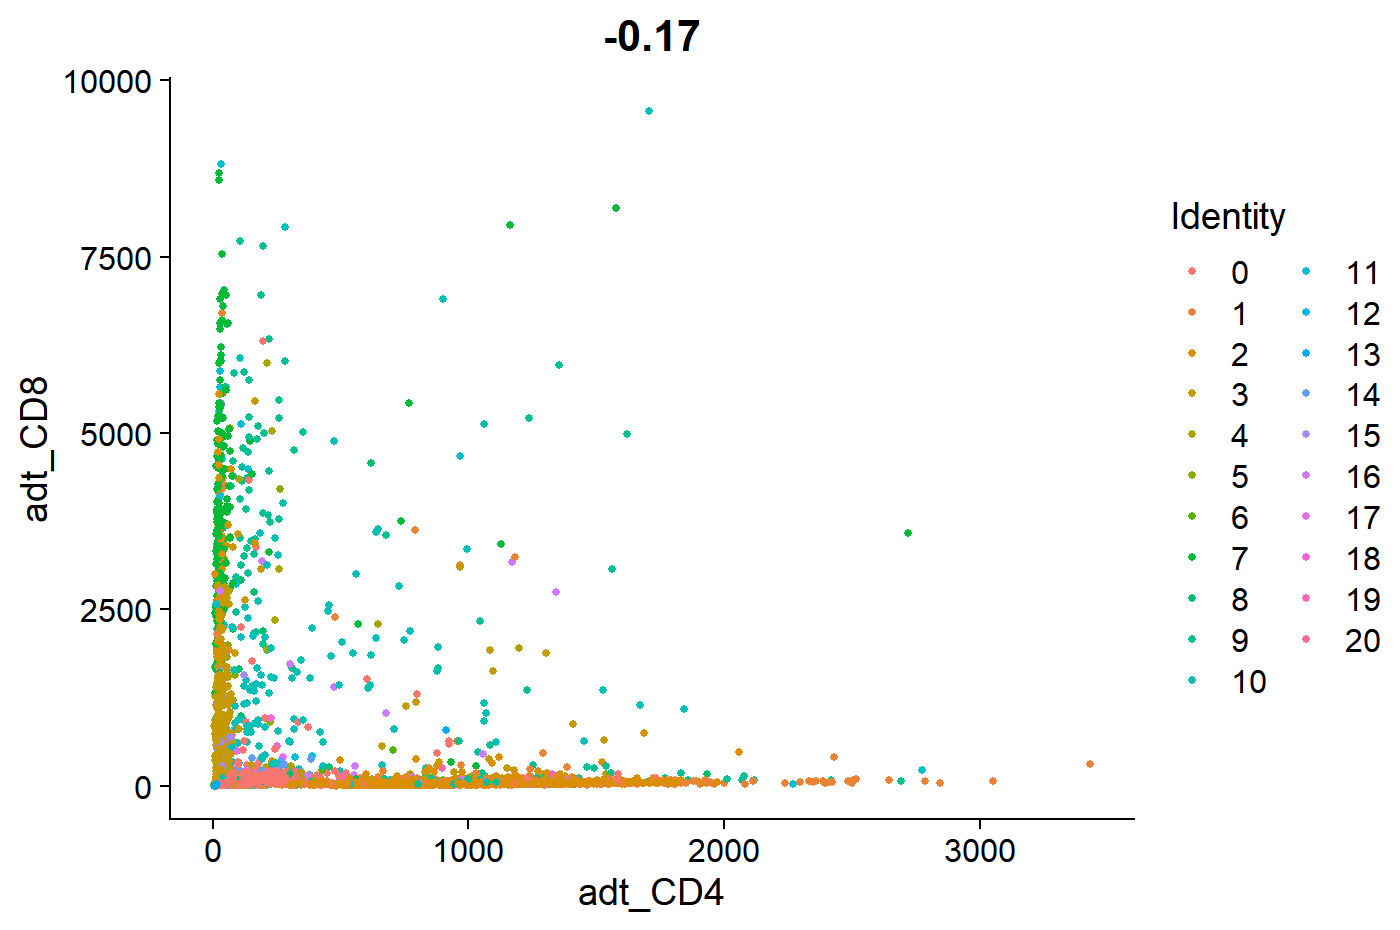
由于蛋白质的数量和RNA相比超级无敌巨多,所以如果没有标准化……横纵轴的数量级会变得很恐怖:

1
FeatureScatter(cbmc, feature1 = "adt_CD4", feature2 = "adt_CD8", slot = "counts")

加载通过10X Multiome获得的多模态数据

这里我们利用10X Multiome提供的PBMC数据集进行演示。需要下载的文件为Feature / cell matrix (filtered)。我们下载的多模态数据中包含以下两种数据:

  • Gene Expression:转录组RNA测序数据。
  • Antibody Capture:ADT数据。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 加载数据
pbmc10k.data <- Read10X(data.dir = "C:/Users/86150/Downloads/pbmc_10k_protein_v3_filtered_feature_bc_matrix/filtered_feature_bc_matrix/")
# 处理抗体名称:利用gsub()函数去除ADT数据中抗体名称的后缀,如将`CD19_control_TotalSeqB`调整为`CD19`,将`CD3_TotalSeqB`调整为`CD3`。
rownames(x = pbmc10k.data[["Antibody Capture"]]) <- gsub(pattern = "_[control_]*TotalSeqB", replacement = "", x = rownames(x = pbmc10k.data[["Antibody Capture"]]))

# 以转录组RNA数据为基础,创建Seurat对象。
pbmc10k <- CreateSeuratObject(counts = pbmc10k.data[["Gene Expression"]], min.cells = 3, min.features = 200)
# 默认使用LogNormalize对RNA数据进行标准化。
pbmc10k <- NormalizeData(pbmc10k)
# 向Seurat对象中添加ADT数据。
pbmc10k[["ADT"]] <- CreateAssayObject(pbmc10k.data[["Antibody Capture"]][, colnames(x = pbmc10k)])
# 用CLR对ADT数据进行标准化。
pbmc10k <- NormalizeData(pbmc10k, assay = "ADT", normalization.method = "CLR")

# 可视化
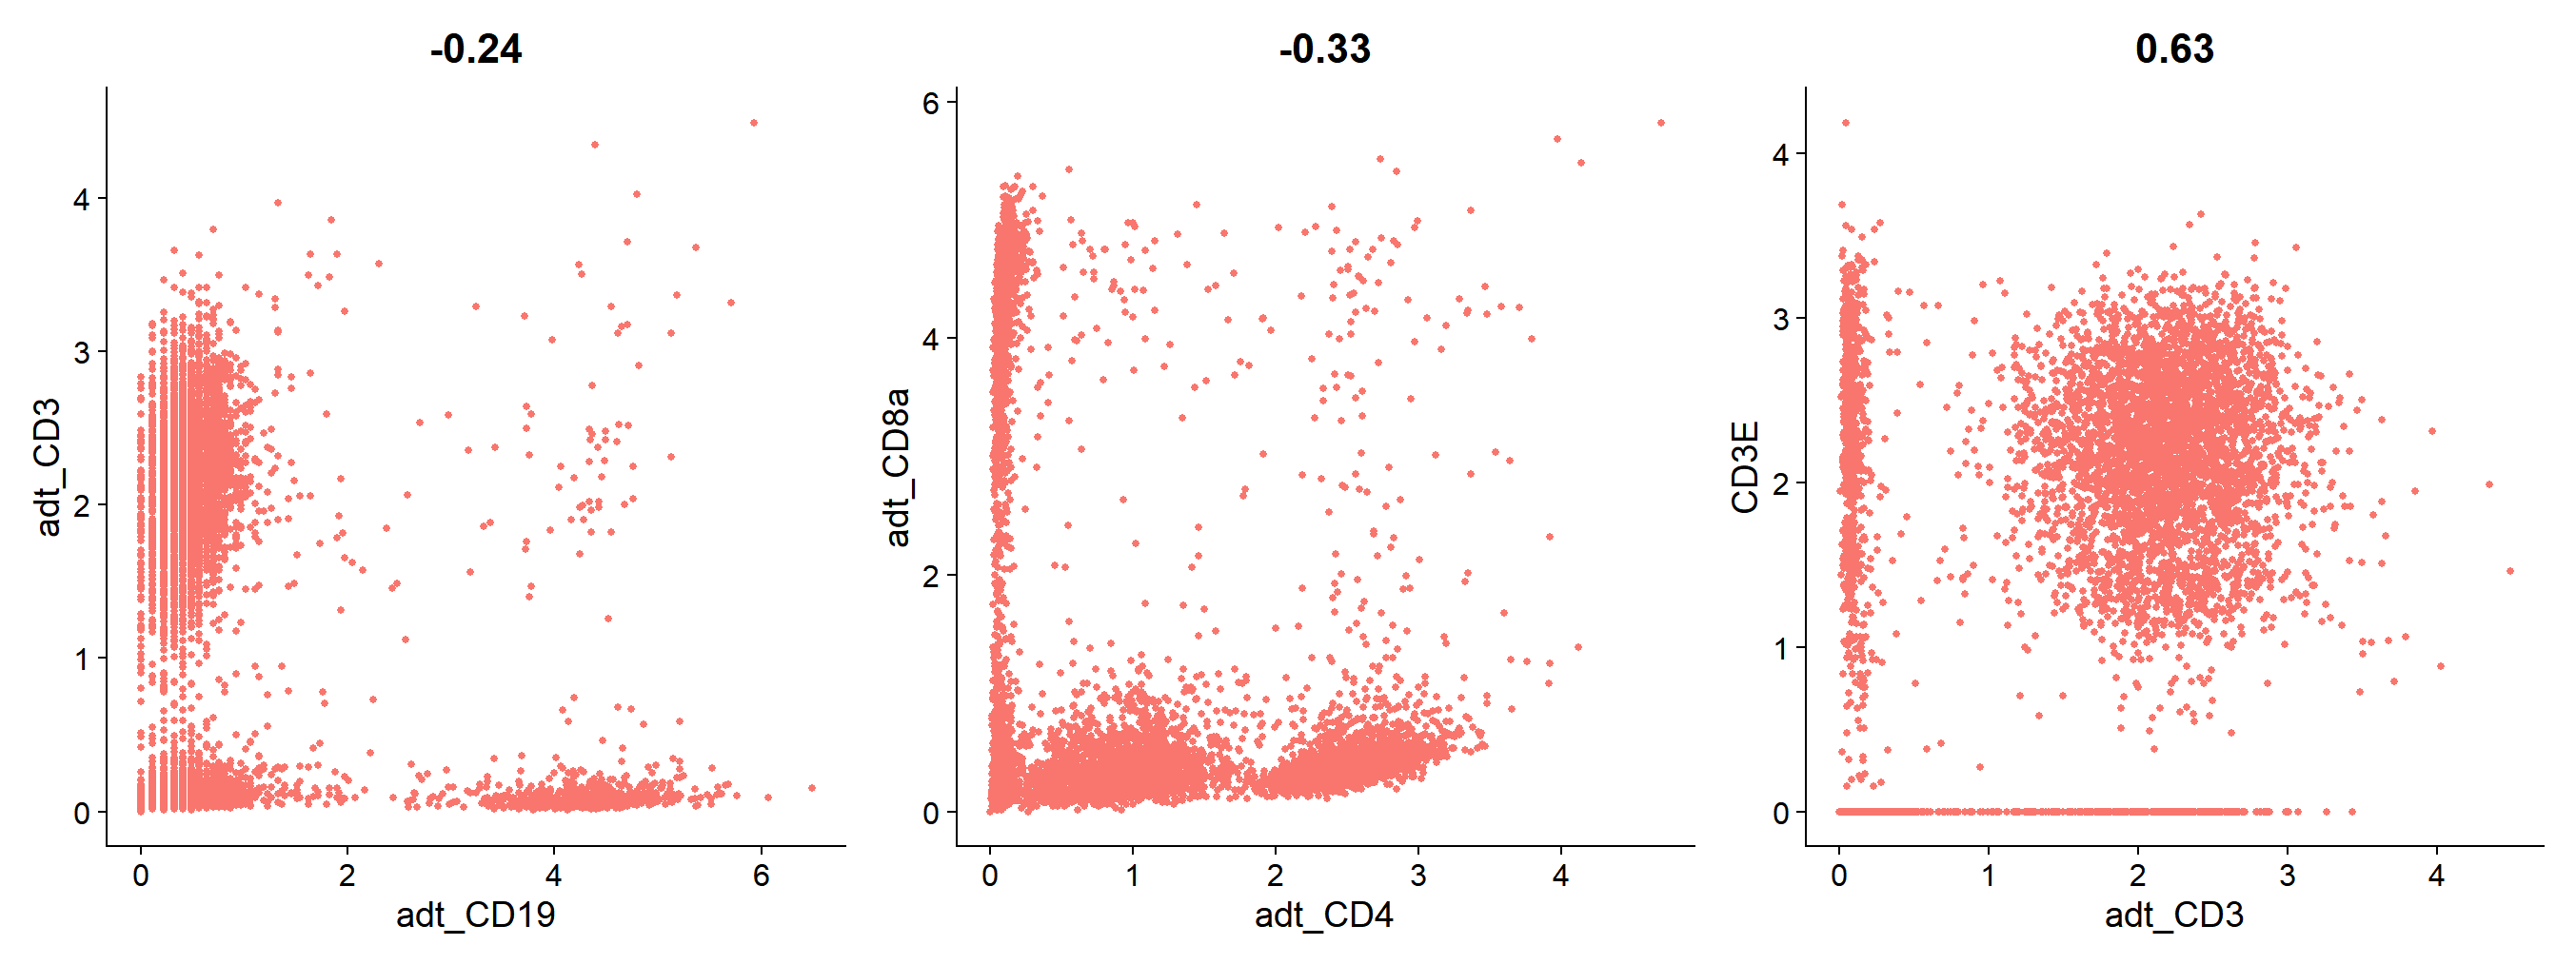
plot1 <- FeatureScatter(pbmc10k, feature1 = "adt_CD19", feature2 = "adt_CD3", pt.size = 1)
plot2 <- FeatureScatter(pbmc10k, feature1 = "adt_CD4", feature2 = "adt_CD8a", pt.size = 1)
plot3 <- FeatureScatter(pbmc10k, feature1 = "adt_CD3", feature2 = "CD3E", pt.size = 1)
(plot1 + plot2 + plot3) & NoLegend()

1
2
3
4
5
plot <- FeatureScatter(cbmc, feature1 = "adt_CD19", feature2 = "adt_CD3") + NoLegend() + theme(axis.title = 
element_text(size = 18), # 设置坐标轴标题字体大小
legend.text = element_text(size = 18) # 设置图例文本字体大小(但已被NoLegend()移除)
)
plot

官方教程中还利用ggsave()进行了保存。

1
ggsave(filename = "../output/images/citeseq_plot.jpg", height = 7, width = 12, plot = plot, quality = 50)

完整代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
library(Seurat)
library(patchwork)
library(ggplot2)
library(SeuratData)
InstallData("cbmc")
data("cbmc")

Assays(cbmc)
cbmc = UpdateSeuratObject(object = cbmc)
all.equal(colnames(cbmc[["RNA"]]), colnames(cbmc[["ADT"]]))

rownames(cbmc[["ADT"]])

DefaultAssay(cbmc)
DefaultAssay(cbmc) <- "ADT"
DefaultAssay(cbmc)

DefaultAssay(cbmc) <- "RNA"
cbmc <- NormalizeData(cbmc)
cbmc <- FindVariableFeatures(cbmc)
cbmc <- ScaleData(cbmc)
cbmc <- RunPCA(cbmc, verbose = FALSE)
cbmc <- FindNeighbors(cbmc, dims = 1:30)
cbmc <- FindClusters(cbmc, resolution = 0.8, verbose = FALSE)
cbmc <- RunUMAP(cbmc, dims = 1:30)
DimPlot(cbmc, label = TRUE)

cbmc <- NormalizeData(cbmc, normalization.method = "CLR", margin = 2, assay = "ADT")
DefaultAssay(cbmc) <- "ADT"
p1 <- FeaturePlot(cbmc, "CD19", cols = c("lightgrey", "darkgreen")) + ggtitle("CD19 protein")
DefaultAssay(cbmc) <- "RNA"
p2 <- FeaturePlot(cbmc, "CD19") + ggtitle("CD19 RNA")
p1 | p2

Key(cbmc[["RNA"]])
Key(cbmc[["ADT"]])
p1 <- FeaturePlot(cbmc, "adt_CD19", cols = c("lightgrey", "darkgreen")) + ggtitle("CD19 protein")
p2 <- FeaturePlot(cbmc, "rna_CD19") + ggtitle("CD19 RNA")
p1 | p2

VlnPlot(cbmc, "adt_CD19")

adt_markers <- FindMarkers(cbmc, ident.1 = 6, assay = "ADT")
rna_markers <- FindMarkers(cbmc, ident.1 = 6, assay = "RNA")
head(adt_markers)
head(rna_markers)

FeatureScatter(cbmc, feature1 = "adt_CD19", feature2 = "adt_CD3")
FeatureScatter(cbmc, feature1 = "adt_CD3", feature2 = "rna_CD3E")
FeatureScatter(cbmc, feature1 = "adt_CD4", feature2 = "adt_CD8")
FeatureScatter(cbmc, feature1 = "adt_CD4", feature2 = "adt_CD8", slot = "counts")

pbmc10k.data <- Read10X(data.dir = "C:/Users/86150/Downloads/pbmc_10k_protein_v3_filtered_feature_bc_matrix/filtered_feature_bc_matrix/")
rownames(x = pbmc10k.data[["Antibody Capture"]]) <- gsub(pattern = "_[control_]*TotalSeqB", replacement = "", x = rownames(x = pbmc10k.data[["Antibody Capture"]]))

pbmc10k <- CreateSeuratObject(counts = pbmc10k.data[["Gene Expression"]], min.cells = 3, min.features = 200)
pbmc10k <- NormalizeData(pbmc10k)
pbmc10k[["ADT"]] <- CreateAssayObject(pbmc10k.data[["Antibody Capture"]][, colnames(x = pbmc10k)])
pbmc10k <- NormalizeData(pbmc10k, assay = "ADT", normalization.method = "CLR")

plot1 <- FeatureScatter(pbmc10k, feature1 = "adt_CD19", feature2 = "adt_CD3", pt.size = 1)
plot2 <- FeatureScatter(pbmc10k, feature1 = "adt_CD4", feature2 = "adt_CD8a", pt.size = 1)
plot3 <- FeatureScatter(pbmc10k, feature1 = "adt_CD3", feature2 = "CD3E", pt.size = 1)
(plot1 + plot2 + plot3) & NoLegend()

plot <- FeatureScatter(cbmc, feature1 = "adt_CD19", feature2 = "adt_CD3") + NoLegend() + theme(axis.title = element_text(size = 18), legend.text = element_text(size = 18))