生信小记:单细胞转录组数据整合分析介绍
整合多组单细胞测序数据集(如跨实验批次、供体或条件),是scRNA-seq的重要步骤之一。整合分析可以匹配不同细胞集之间相同的细胞类型和细胞状态,提高统计效能,有利于跨数据集的准确比较分析。本篇文章将对利用Seurat集成分析进行复杂细胞类型间的比较分析进行简要概述。我们进行比较分析的主要目的主要在于以下三点:
- 确认在不同细胞数据集中均存在的细胞簇;
- 确认在实验组(经过某种特定刺激)和对照组中保守的细胞类型标记;
- 对比并确认细胞对该刺激所作出的特定反应。
创建Seurat对象
首先我们安装并加载所需要的R包,并通过SeuratData包下载本篇文章所需要的原始数据。这份数据包括以下两组细胞:①经干扰素刺激的人PBMC细胞;②对照组人PBMC细胞。在接下来的分析中,整合上述两组细胞数据集,以识别共同的细胞亚群并比较其在不同处理条件下的差异。
实操过程中,由于网络情况及文件大小等原因,可能会出现因超时而导致下载中止并报错的情况。在安装数据之前运行
options(timeout=10000),将超时限制放宽即可正常下载。
1 | library(Seurat) |
接下来我们加载上述原始数据集。由于不同组的细胞数据集均存放于同一个Seurat对象中,我们在分析之前需要先将其分为两层。分层之后我们可以看到CTRL(对照,control)和STIM(刺激,stimulate)两组数据。
1 | ifnb <- LoadData("ifnb") |
- 运行结果
1 | > ifnb |
进行不整合的简单分析
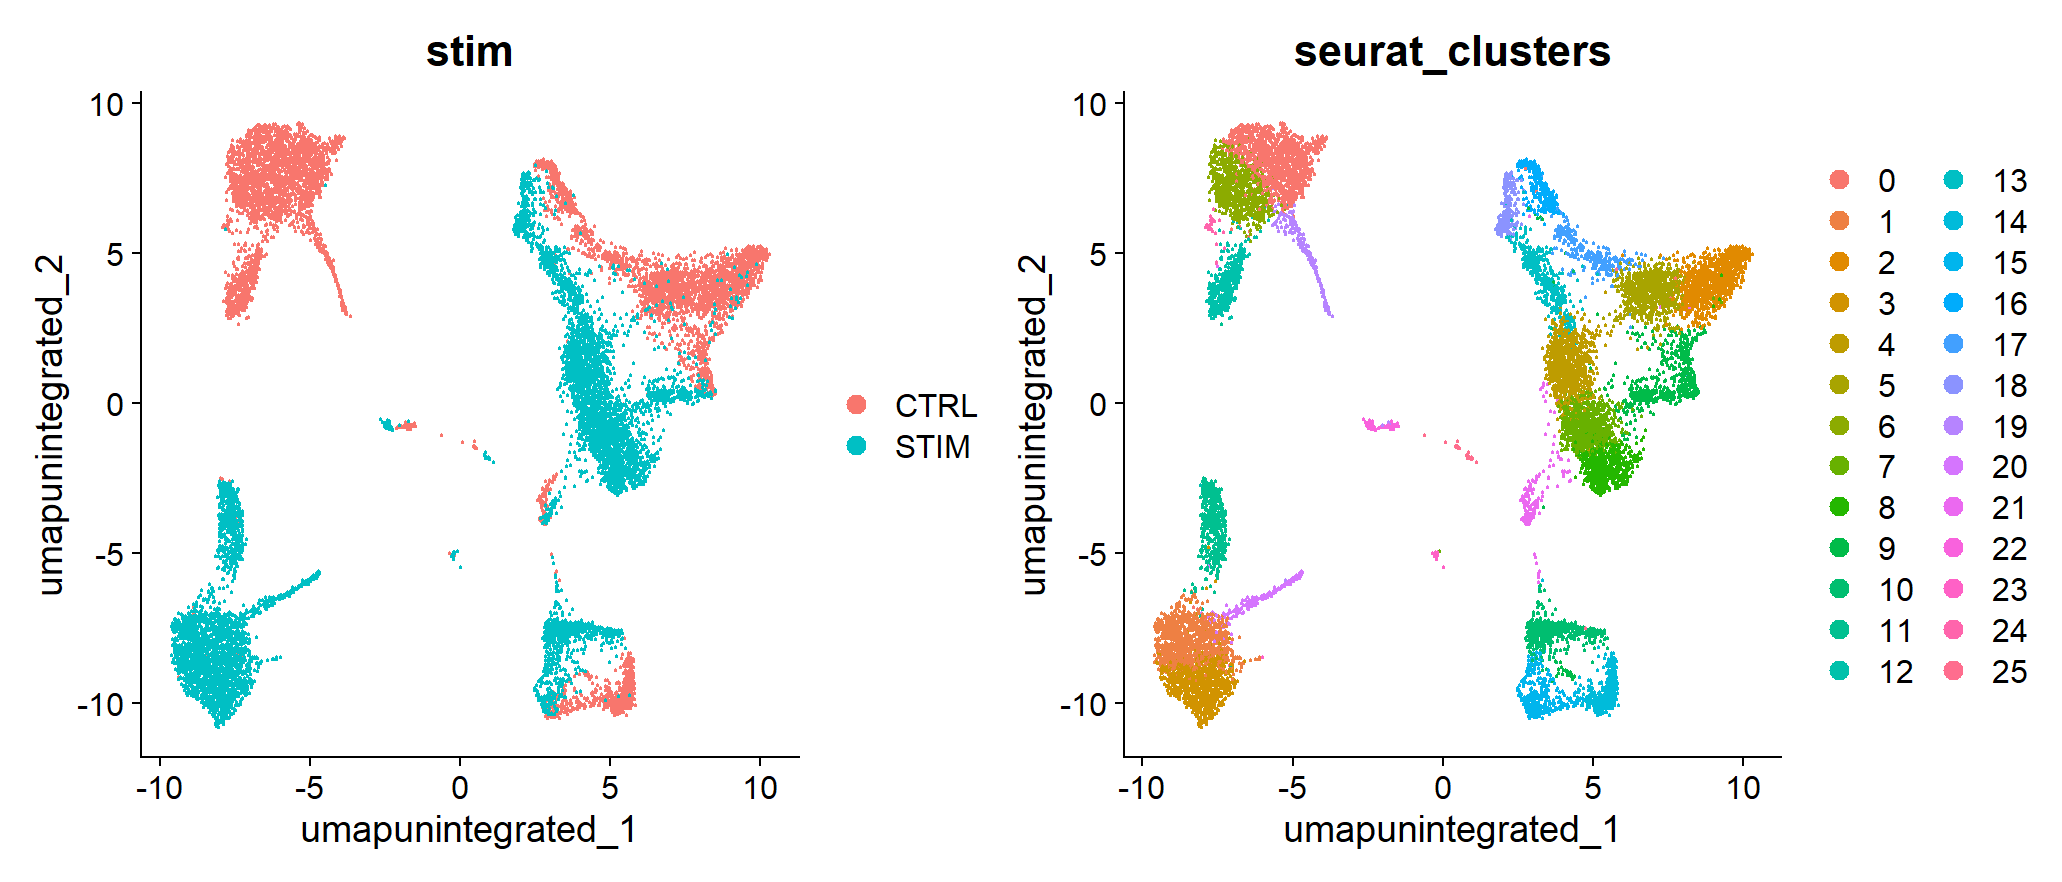
为了更直观地感受分别分析给两组比较带来的挑战,我们先用传统的方法对两组数据分别进行单独分析。从得到的UMAP图上我们很容易看到,两个数据集所分出的细胞簇总数超级多,这是因为两个数据集中每一种类型的细胞都按照数据集的类型被分为两类,而没有整合为一类细胞。这很显然对我们对比分析两组细胞不太有利。
1 | ifnb <- NormalizeData(ifnb) |
整合两组数据集(CCA降维)
利用IntegrateLayer()函数,可以通过典型相关分析(CCA),识别共享或同源基因来确定共享细胞类型或状态(也就是在不同组别中共享的细胞类型),进而建立跨数据集的关联,从而实现两组数据的整合。这一过程不会消除不同组别细胞之间基因表达的生物学差异,因此不会影响组间分析。整合后的数据将会存放在一个低维嵌入空间(integrated.cca)中。
此时两组数据仍然存储在两层中,因此我们使用JoinLayer()函数合并两组数据,该过程将会覆盖原始分层存储的数据。
随后,我们对CCA降维后的数据进行细胞聚类和UMAP降维。
1 | ifnb <- IntegrateLayers(object = ifnb, method = CCAIntegration, orig.reduction = "pca", new.reduction = "integrated.cca", verbose = FALSE) |
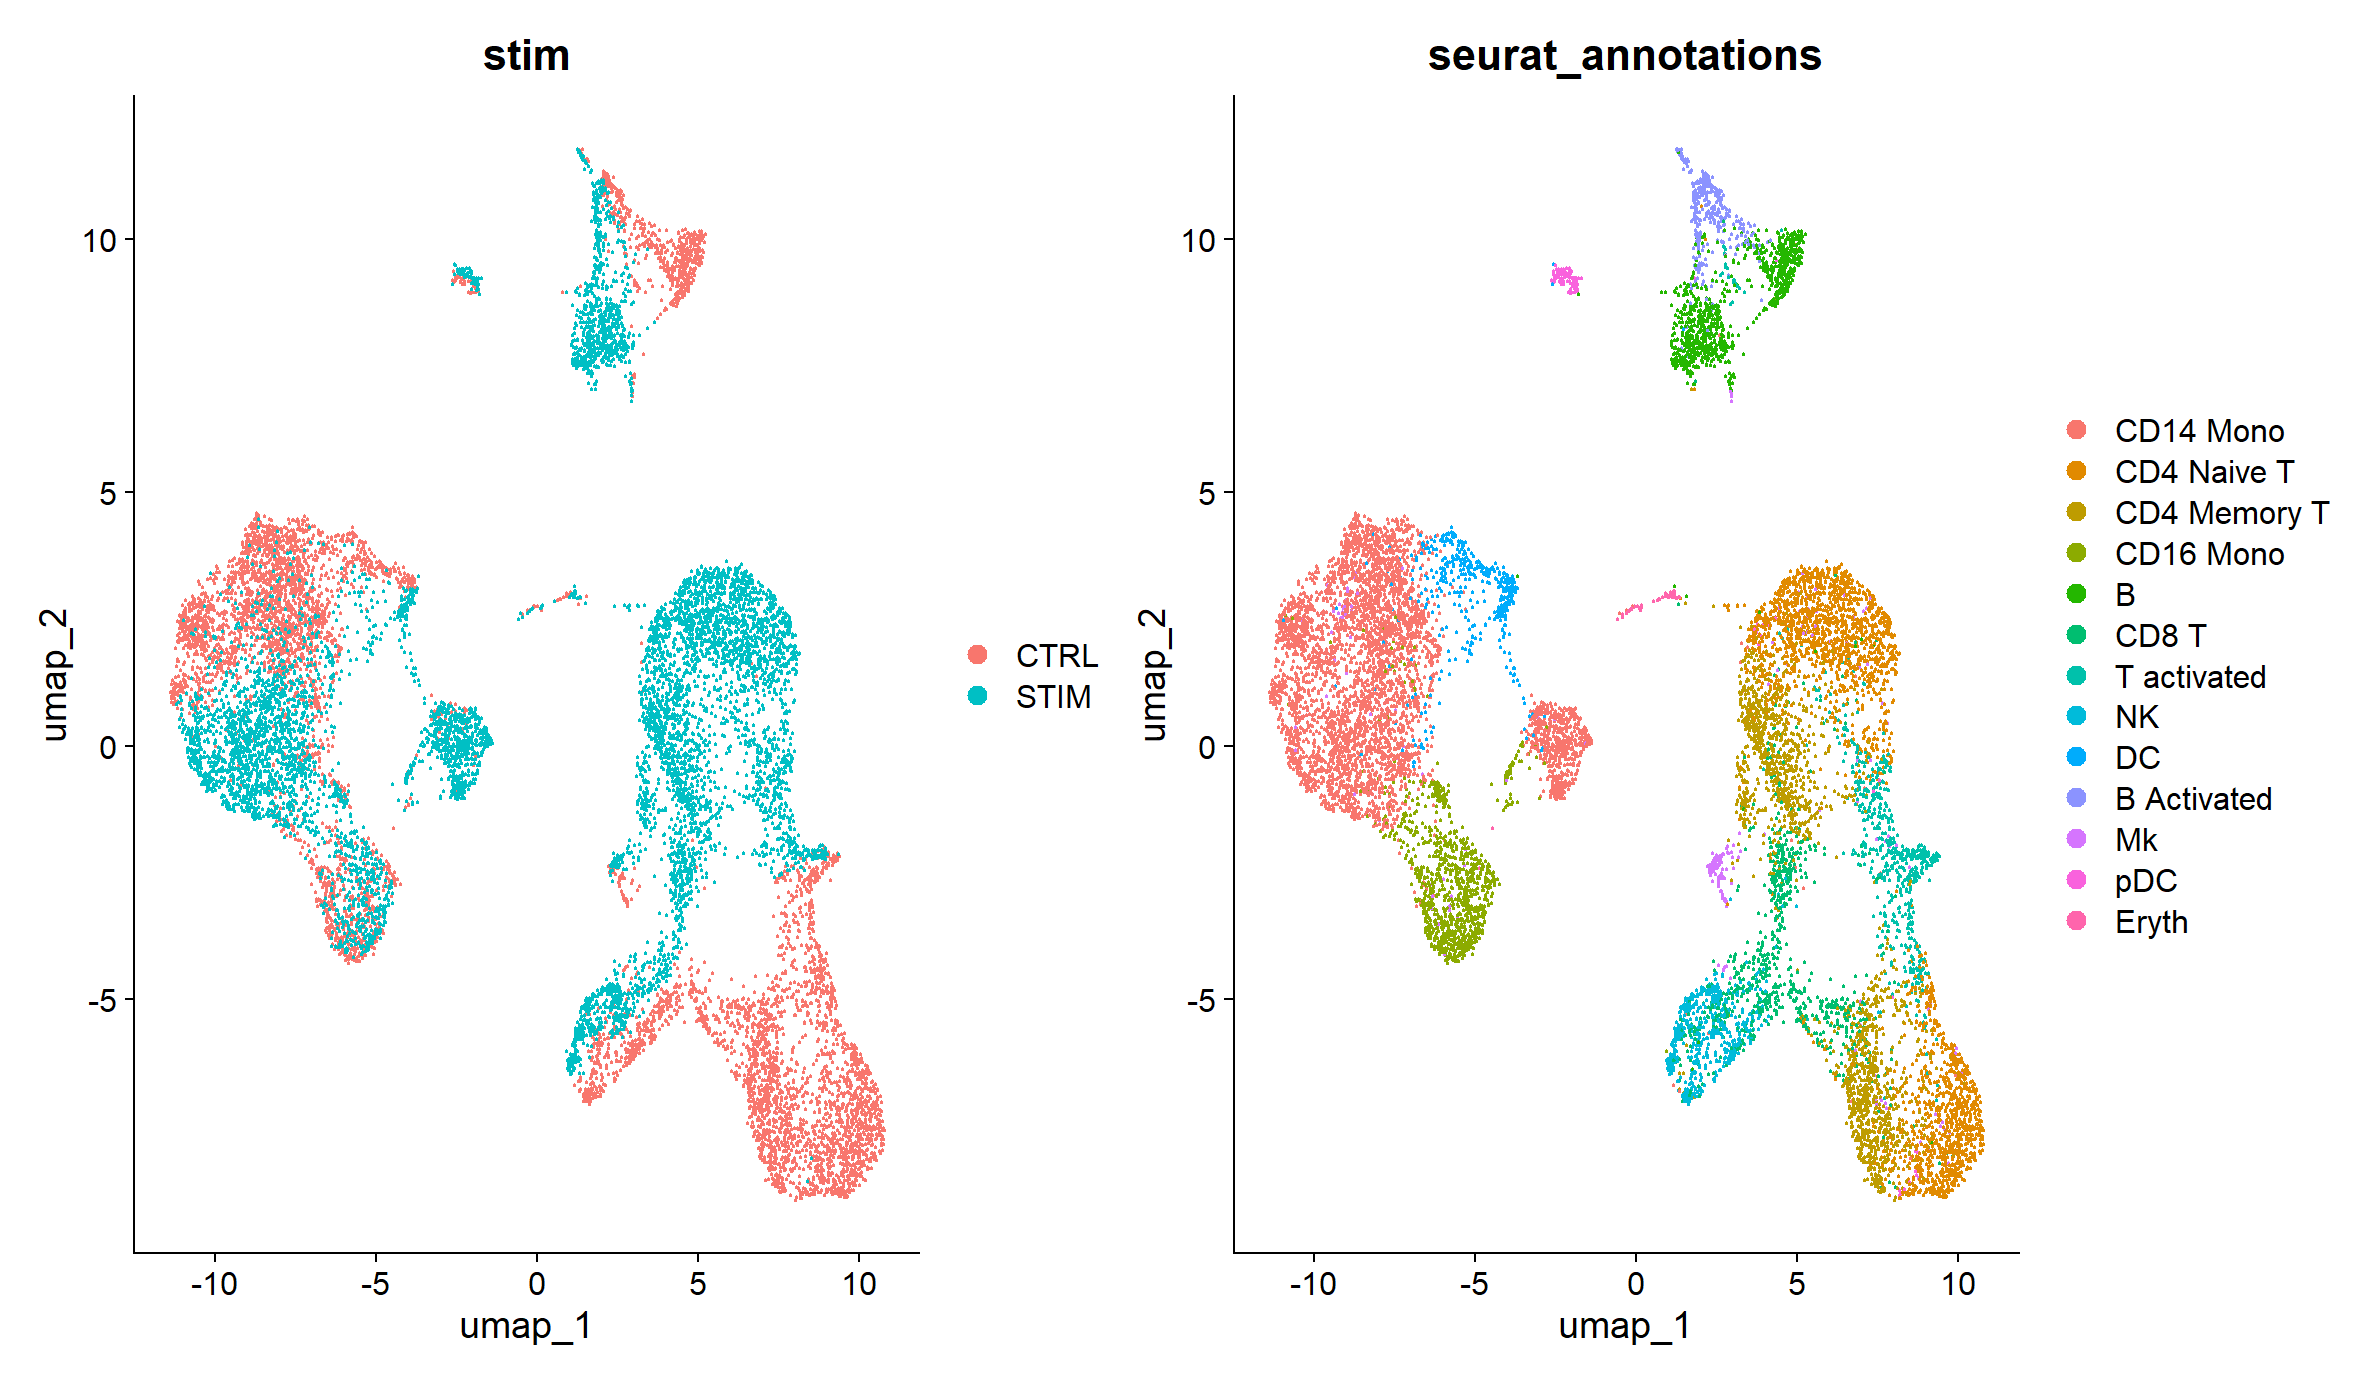
随后我们可以进行可视化。下图中左图为按照实验条件分组的图像,右图为按照CCA整合后聚类的人工注释结果分类的图像。
1 | DimPlot(ifnb, reduction = "umap", group.by = c("stim", "seurat_annotations")) |
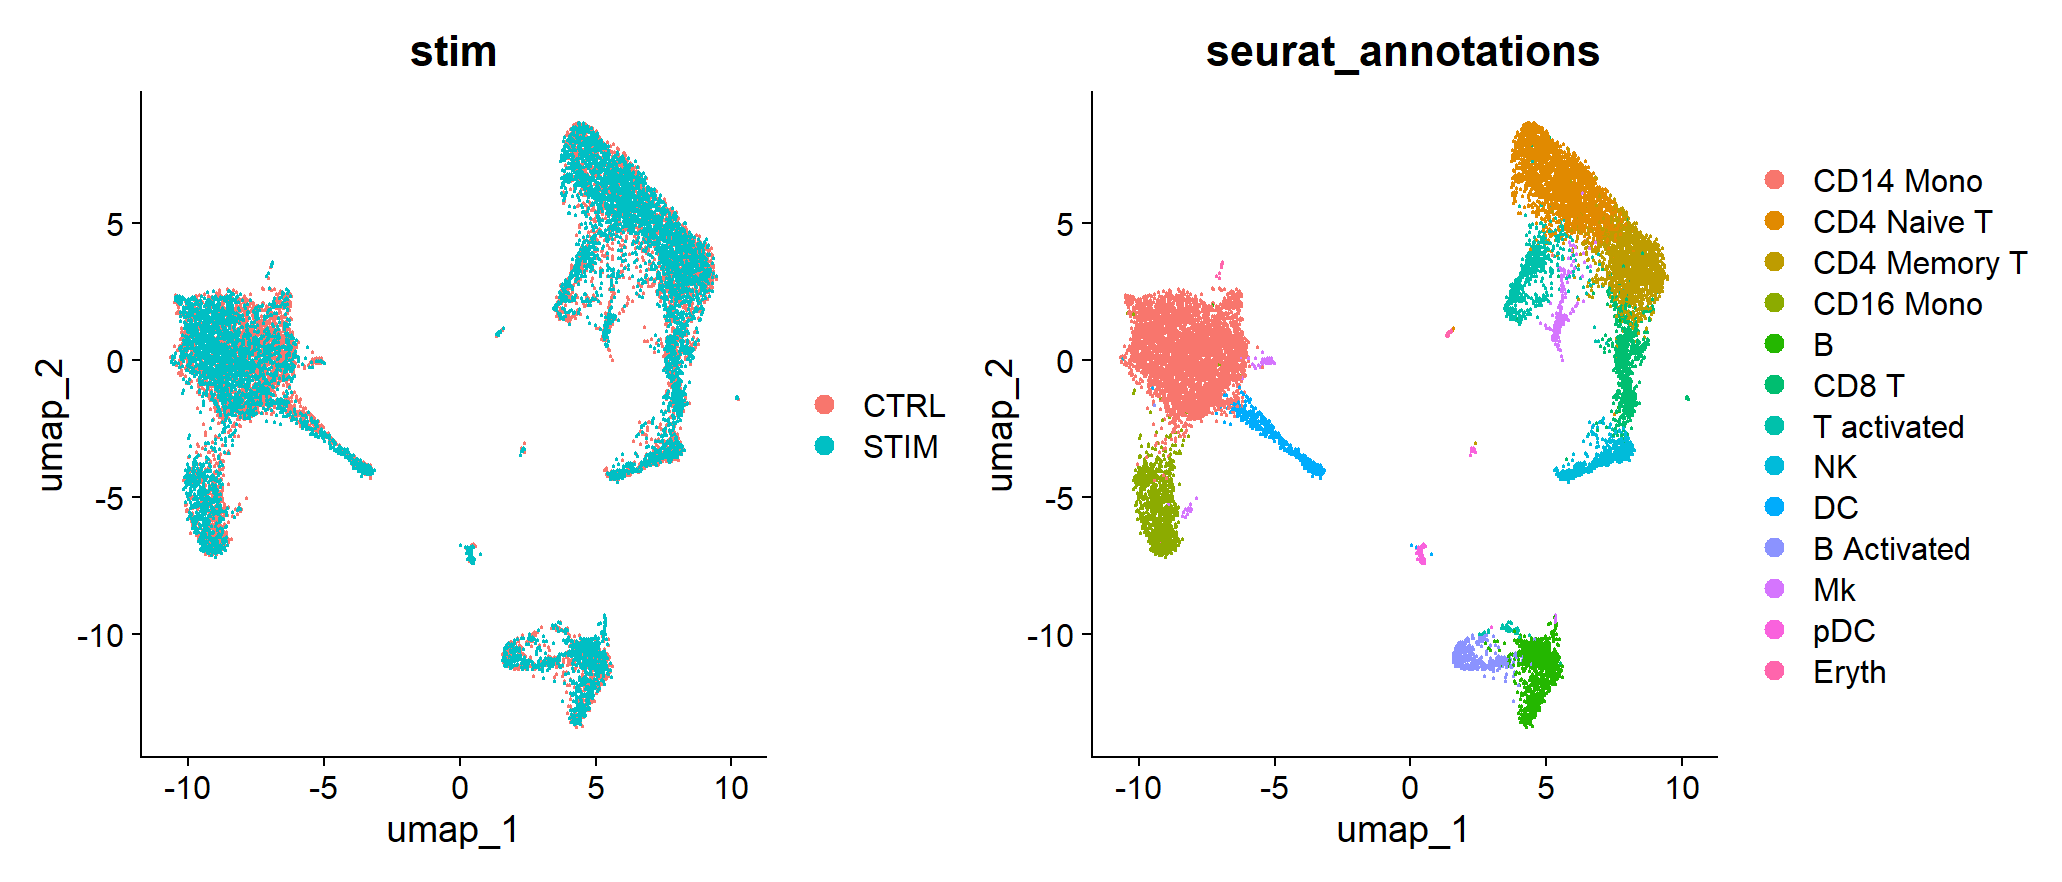
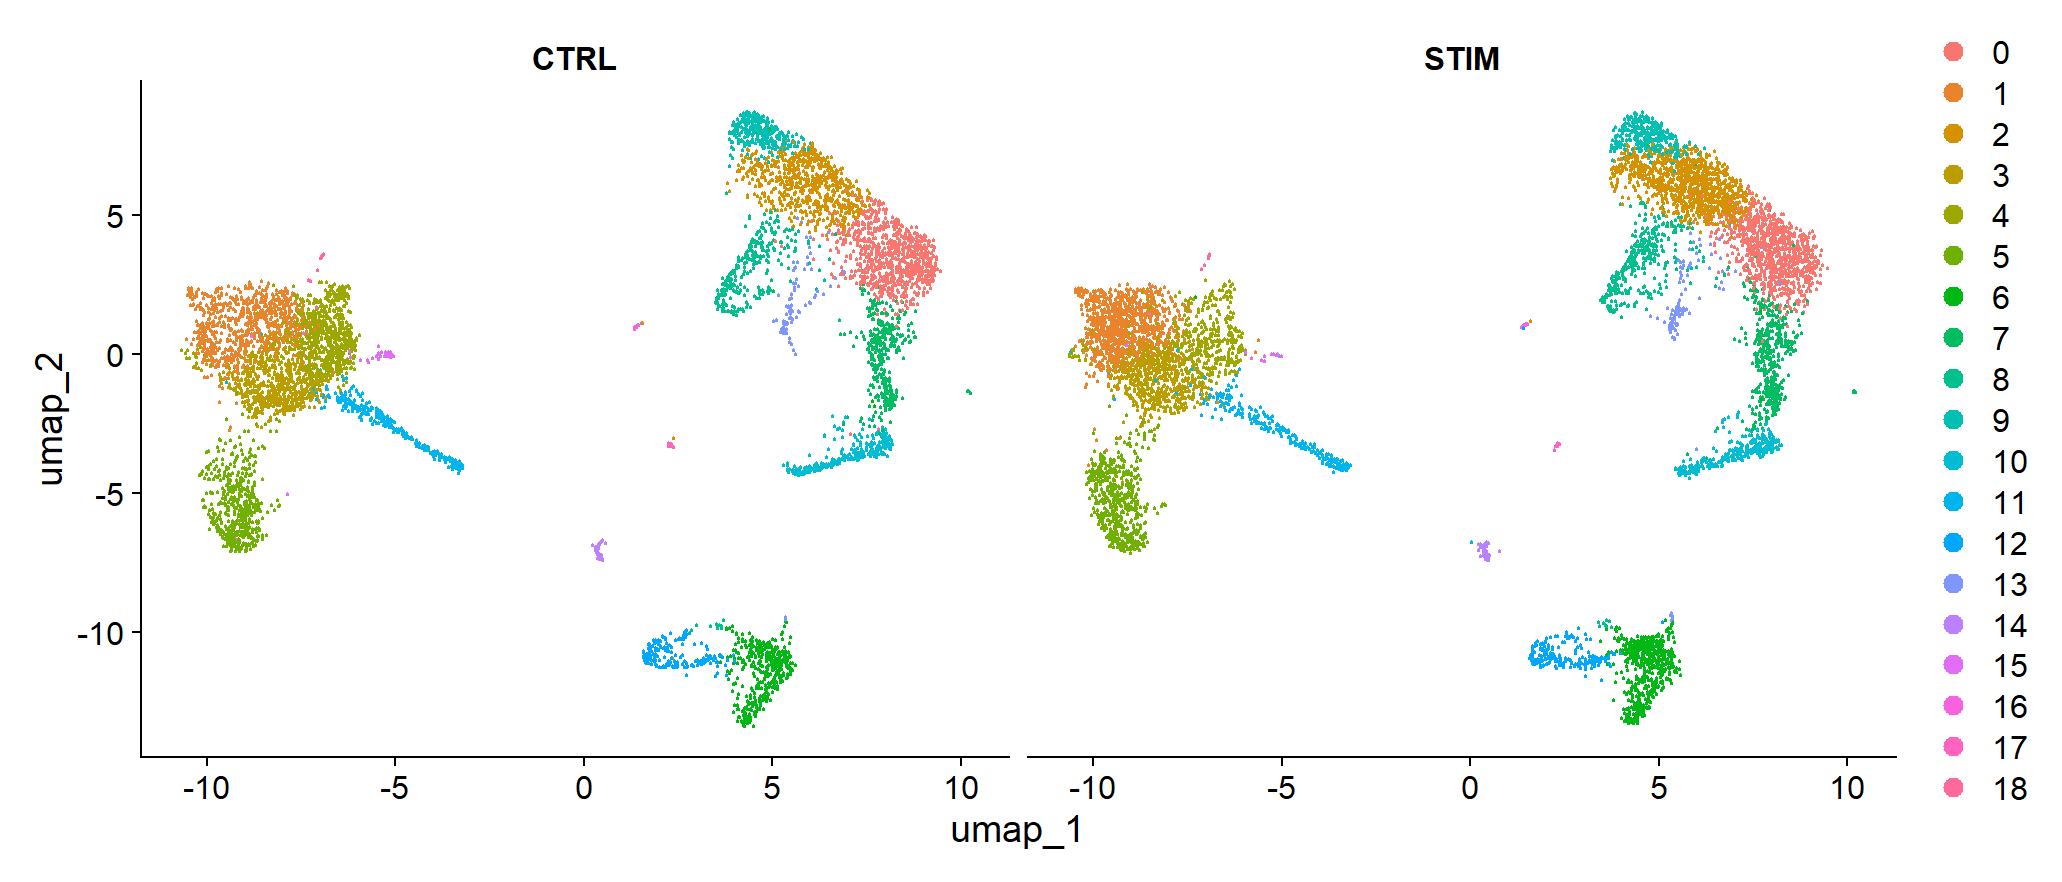
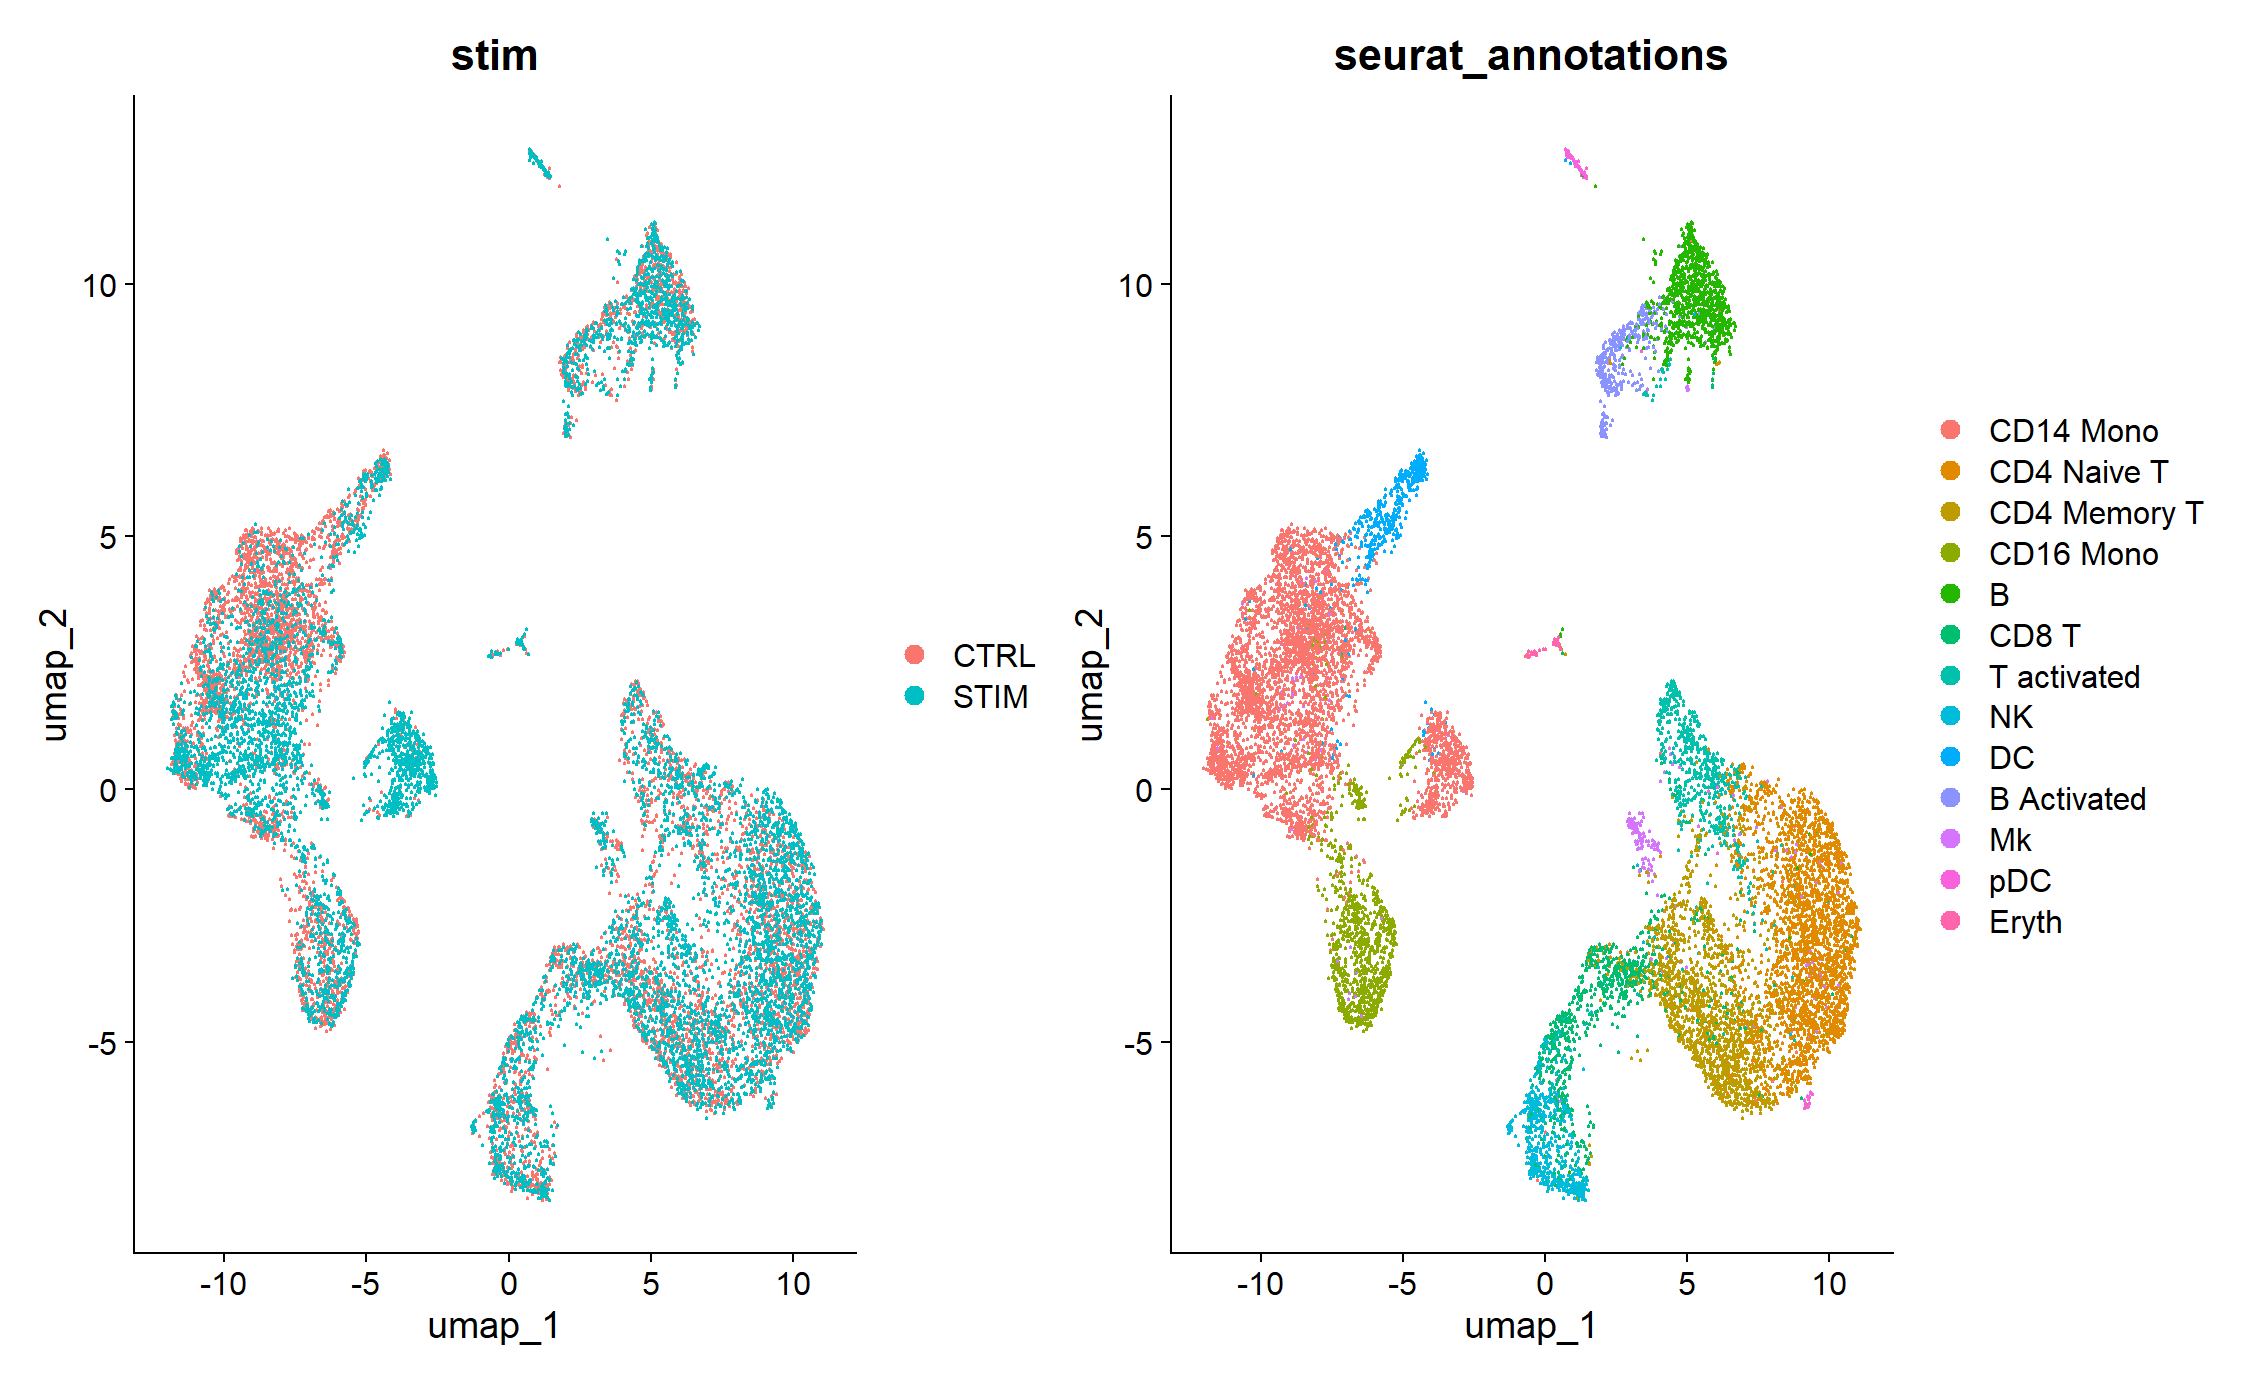
当然,通过调整split.by参数,我们可以将两组细胞数据分开,分别显示CCA整合后聚类的人工注释结果分类的图像。
1 | DimPlot(ifnb, reduction = "umap", split.by = "stim") |
识别保守的细胞类型标记
FindConservedMarker()函数,人如其名,可以帮助我们识别在不同处理条件下同一类型细胞中不随处理条件变化的稳定标记基因。其原理为:①在每个实验条件中,分别比较目标细胞群与其他所有细胞的差异表达基因,并计算每个条件的$p$值和表达量;②使用MadeDE包中的元分析,将不同实验条件的统计值(如$p$值)合并,得到跨条件统一的显著性评估。
以下述代码为例,我们确认了细胞簇6(即NK细胞)的保守标记基因。
1 | install.packages('BiocManager') |
- 运行结果
1 | > head(nk.markers) |
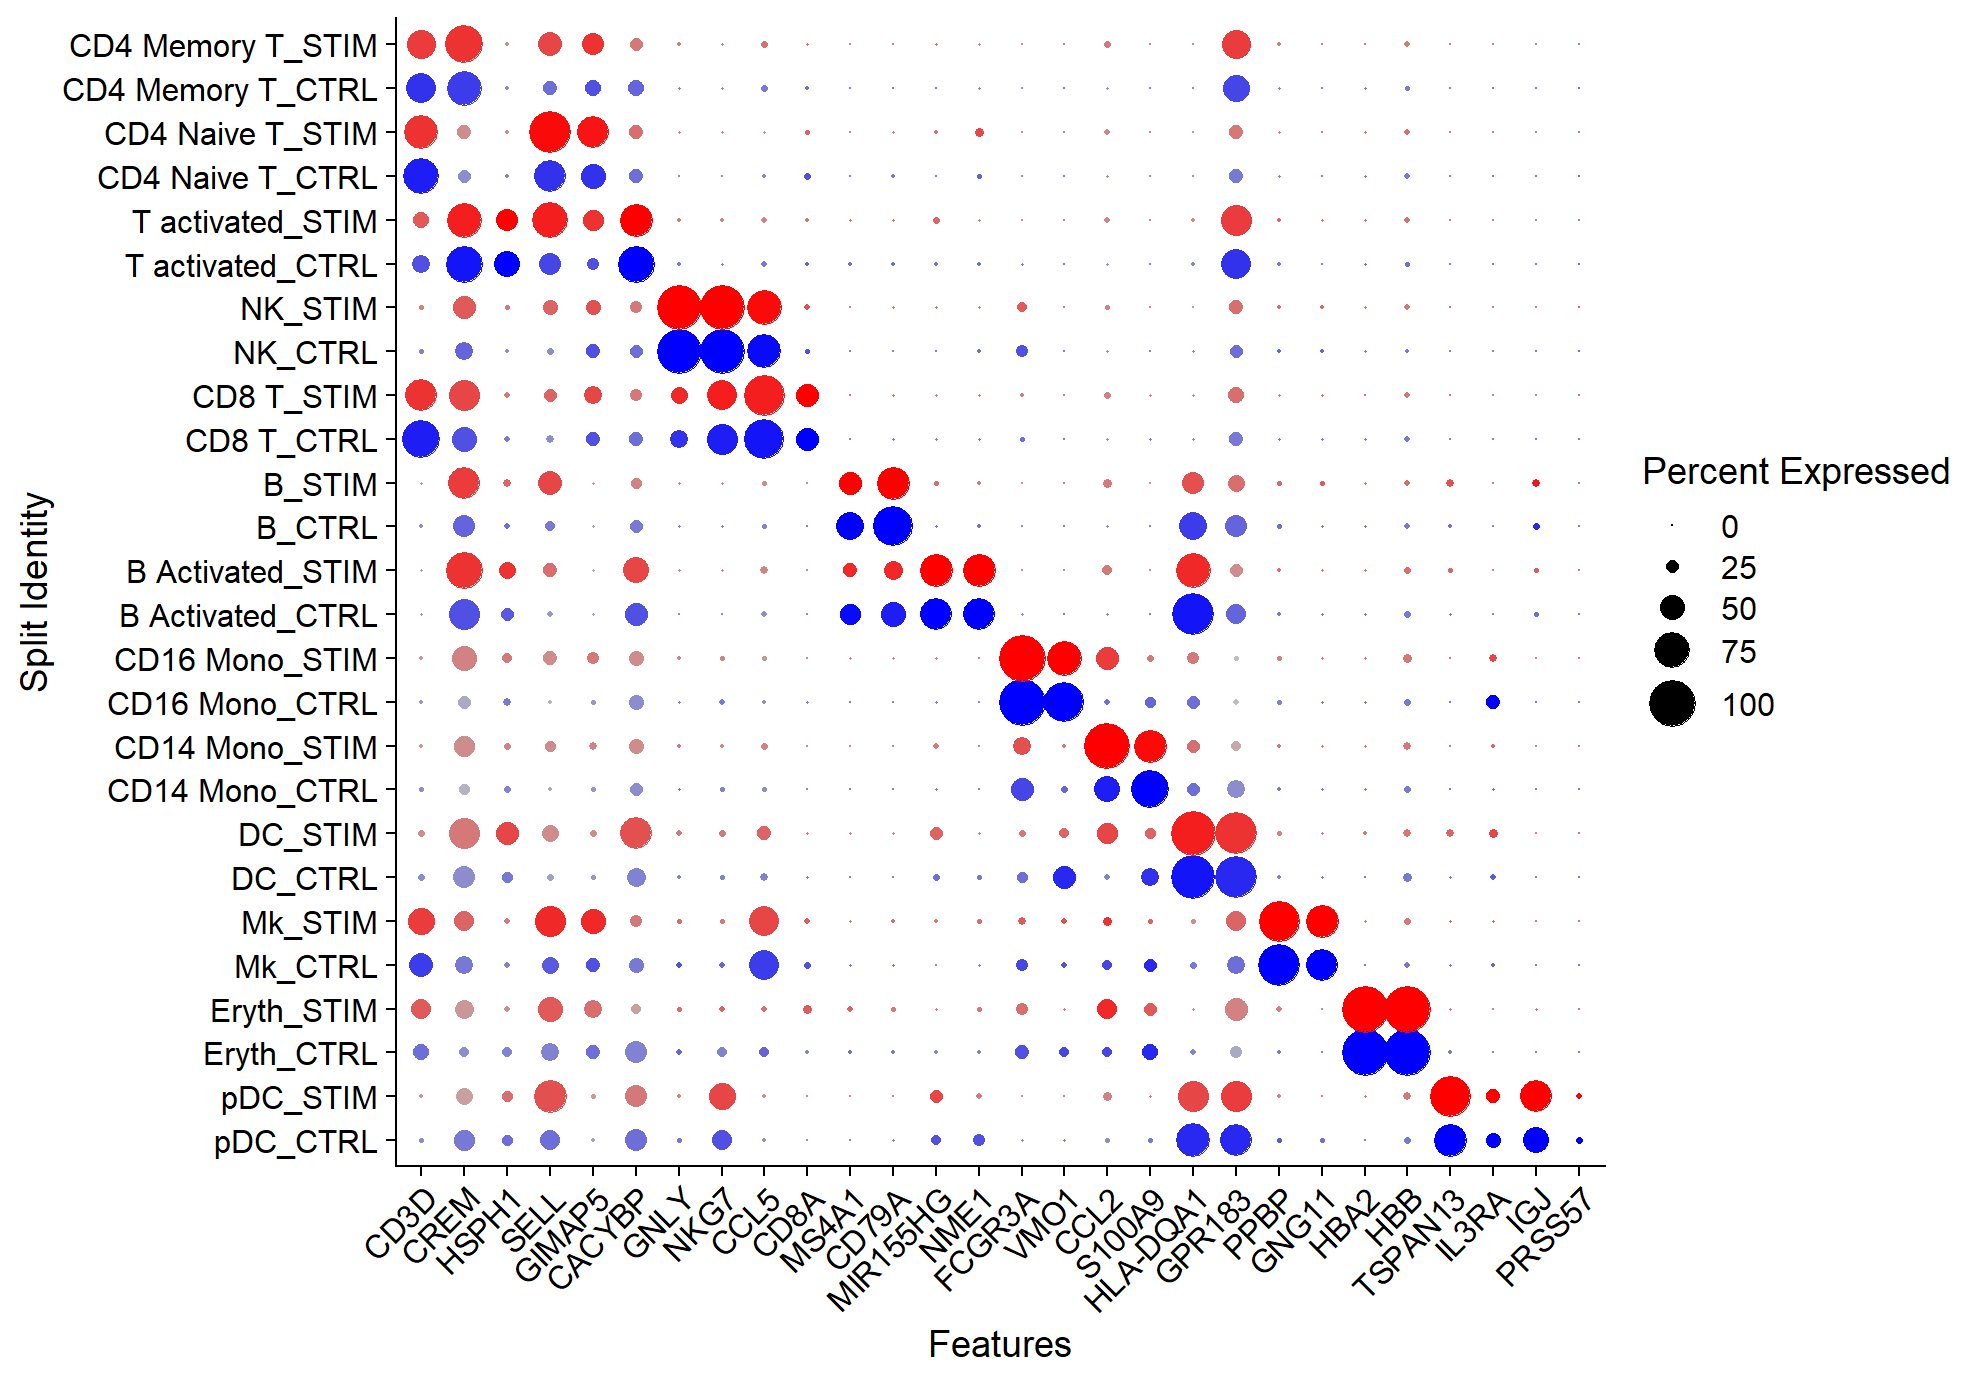
利用DotPlot()函数,且通过调整split.by参数,我们可以查看不同处理条件下的保守细胞基因,并展示其表达水平和在细胞簇中的表达百分比。
1 | Idents(ifnb) <- factor(Idents(ifnb), levels = c("pDC", "Eryth", "Mk", "DC", "CD14 Mono", "CD16 Mono", "B Activated", "B", "CD8 T", "NK", "T activated", "CD4 Naive T", "CD4 Memory T")) |
识别不同处理条件下细胞的差异表达基因
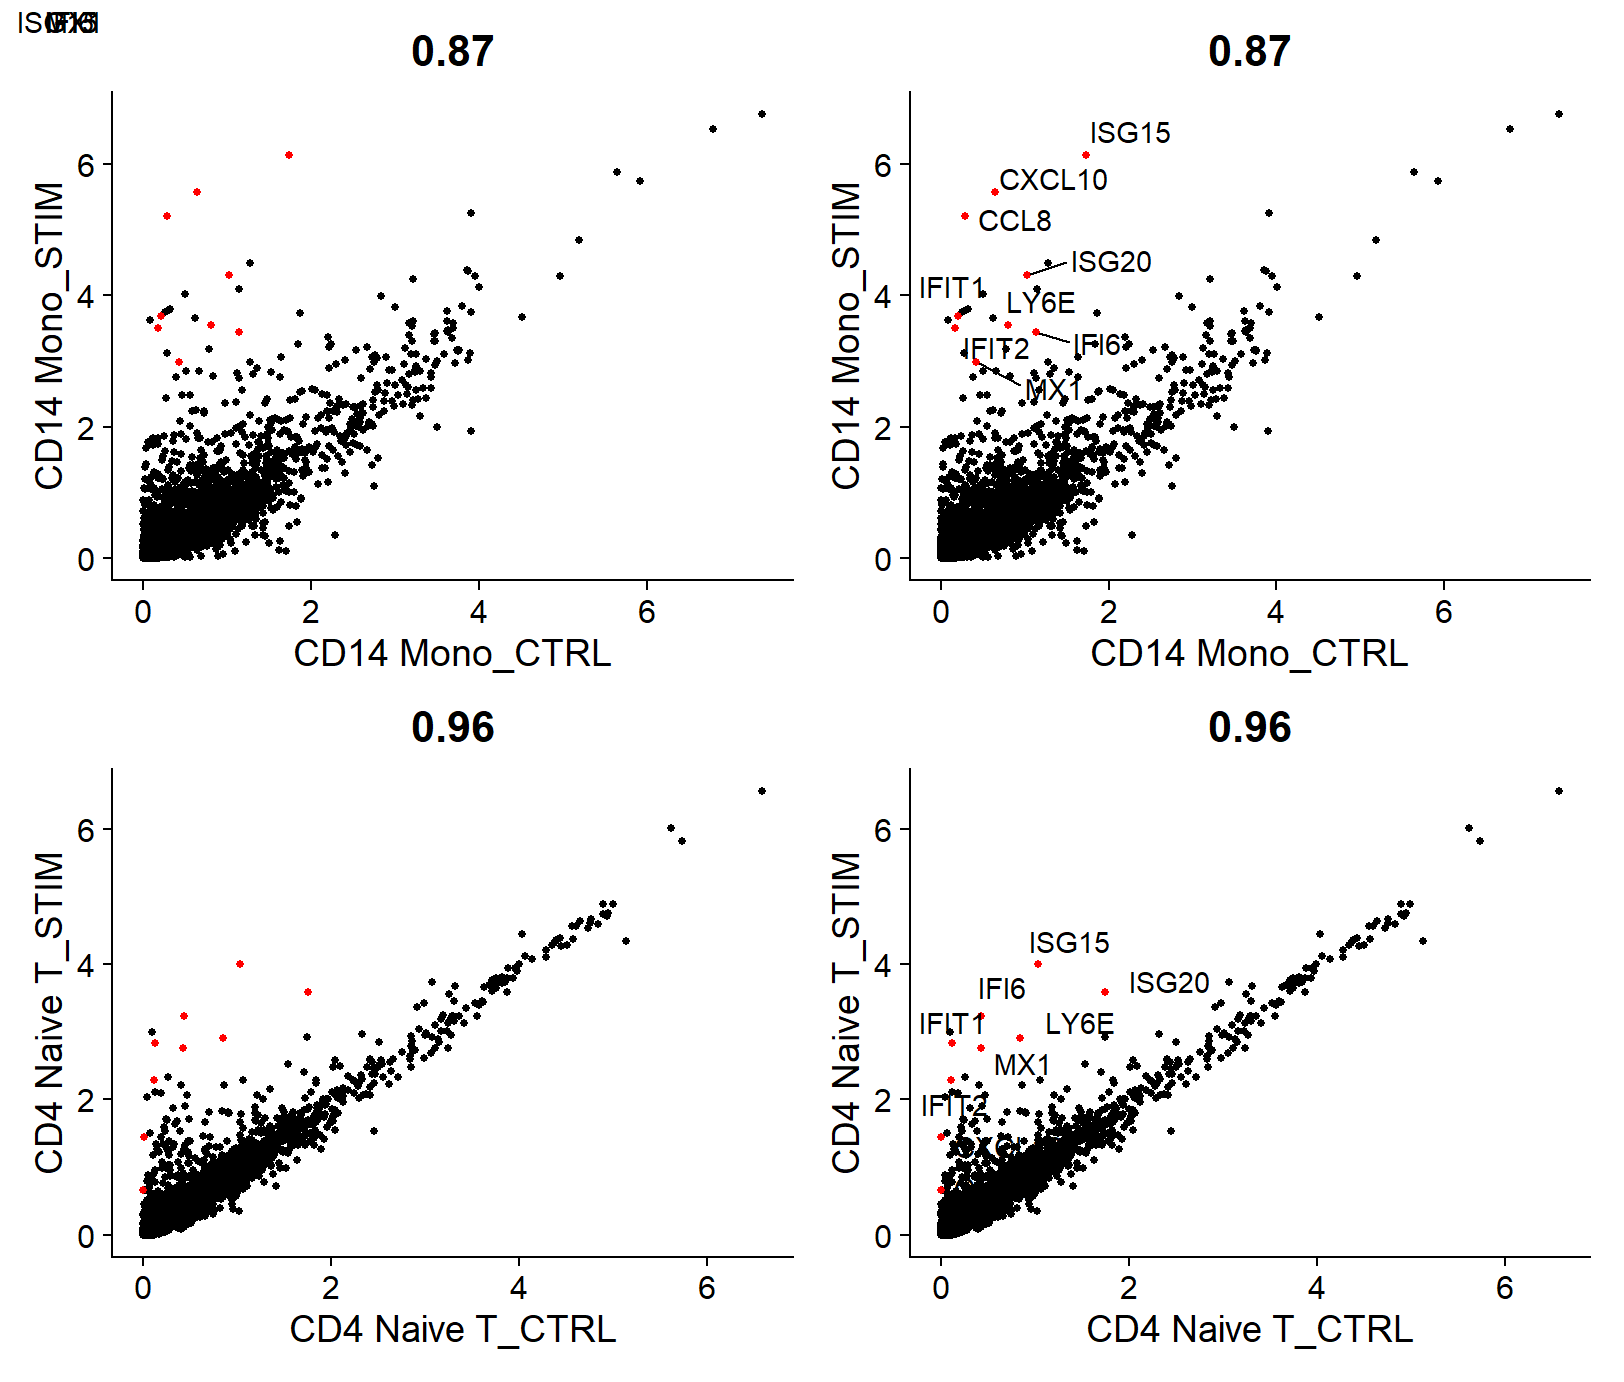
这一步我们将分析出在不同处理条件下,在同一细胞类型中表达存在显著差异的基因。但在这之前,我们需要把现在的数据转化为“伪批量”数据。这是因为,在单细胞测序中,单个细胞的基因表达量差异很大,某个基因可以在某个或某些细胞偶然性地高表达或低表达,这和细胞环境及所受刺激没有直接关联。伪批量(pseudo-bulk)是将同一实验条件下同一类型的多个细胞数据合并并计算的平均值。伪批量的稳定性和可靠性较原始数据(这里指没有转化为伪批量的数据)强,更容易发现不同刺激条件下基因表达的差异。
下面代码将以CD4 Naive T cells和CD14 Monocyte为例进行比较。如下图所示,很多相同的、可能与干扰素保守反应途径相关的基因在这两种细胞中都被上调,尽管CD14 Monocyte的转录水平差异更大。
1 | library(ggplot2) |
- 运行结果:
上述代码可以比较我们所指定的基因在不同刺激条件下的表达差异。然而,当我们不清楚在不同处理条件下哪些基因表达水平会发生显著变化时,如果一个一个的调出与比较,很显然效率会过于低下。这时候你可能会想到(没想到也没关系),在Seurat标准分析工作流程的教程中用到的FindMarkers()和FindAllMarkers()函数可以用来识别并列出不同细胞簇之间的差异表达基因,那么在这里能不能用呢?
答案是可以的。在这里,我们在meta.data这个”槽”中新建一列用以存储细胞类型和存储信息,然后将ident(默认分组标识)切换到这个列;也就是告诉机器,细胞按照这个标准分组。然后我们就可以上FindMarkers()函数啦,这样就可以区分出不同刺激条件下的差异表达基因。
1 | ifnb$celltype.stim <- paste(ifnb$seurat_annotations, ifnb$stim, sep = "_") |
- 运行结果:
1 | > head(b.interferon.response, n = 15) |
我们需要注意的是,在解释上述结果中所显示的$p$值要慎之又慎。原因主要在于忽略了各个细胞间的共同来源性(非独立性)。同一批次的各个细胞之间的遗传背景、环境暴露等因素相同或类似,且存在相互影响。而在统计学分析过程中,则默认每个细胞对于刺激所作出的反应是独立的。讲人话就是,假设有样本A、B各1000个细胞,如果我们直接将2000个细胞作为独立的“观测值”,分析时程序会误认为有2000个样本(但实质上只有A和B两个样本)。由于同一样本的细胞间变异通常小于样本间细胞的变异性,此时变异性会被稀释,从而导致更容易得到统计差异显著的结果,也就是“假阳性”。
如何解决上述问题呢?答案就是伪批量分析。通过计算样本内所有基因表达量的平均值,将同一样本内的多个细胞合并为“一个”细胞,最后在比较时就是两个“细胞”之间的比较啦!就可以顺利地解决问题!
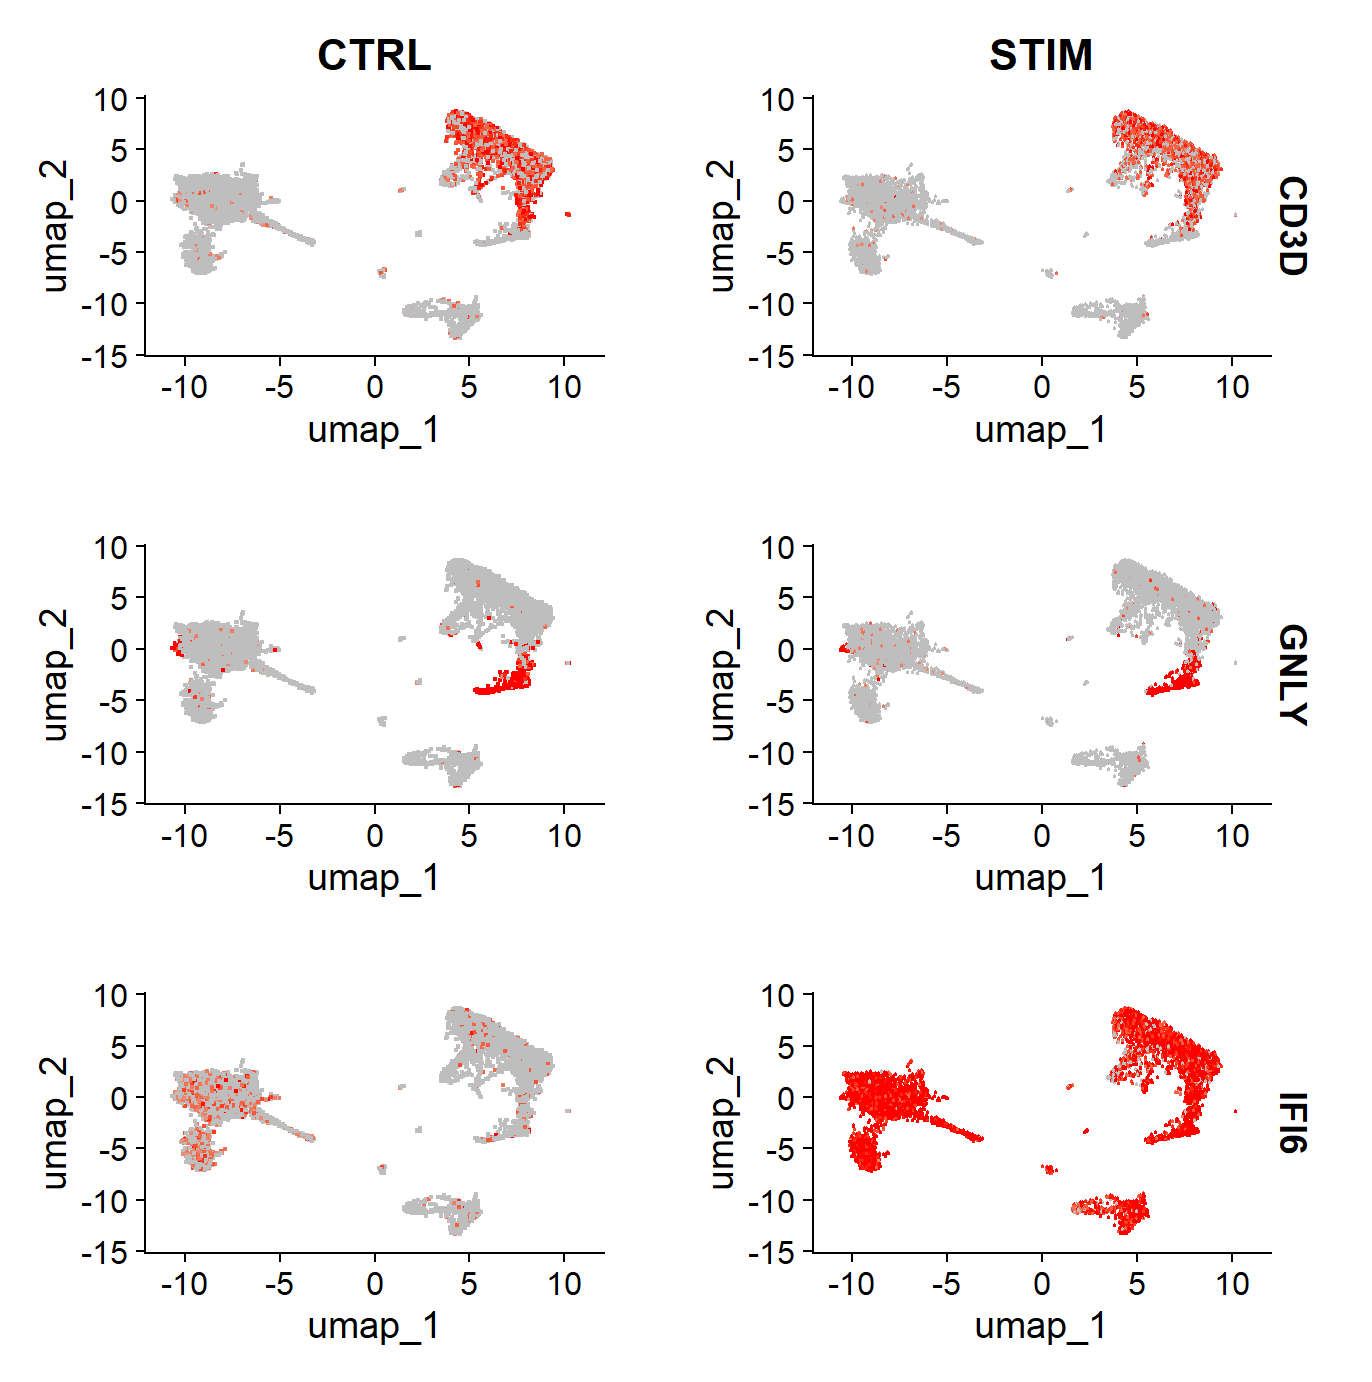
我们还可以利用FeaturePlot()和VlnPlot()函数,通过调整split.by参数进行可视化。
1 | FeaturePlot(ifnb, features = c("CD3D", "GNLY", "IFI6"), split.by = "stim", max.cutoff = 3, cols = c("grey", "red"), reduction = "umap") |
- 运行结果:
1 | plots <- VlnPlot(ifnb, features = c("CD14", "ISG15", "CXCL10"), split.by = "stim", group.by = "seurat_annotations", pt.size = 0, combine = FALSE) |
- 运行结果:
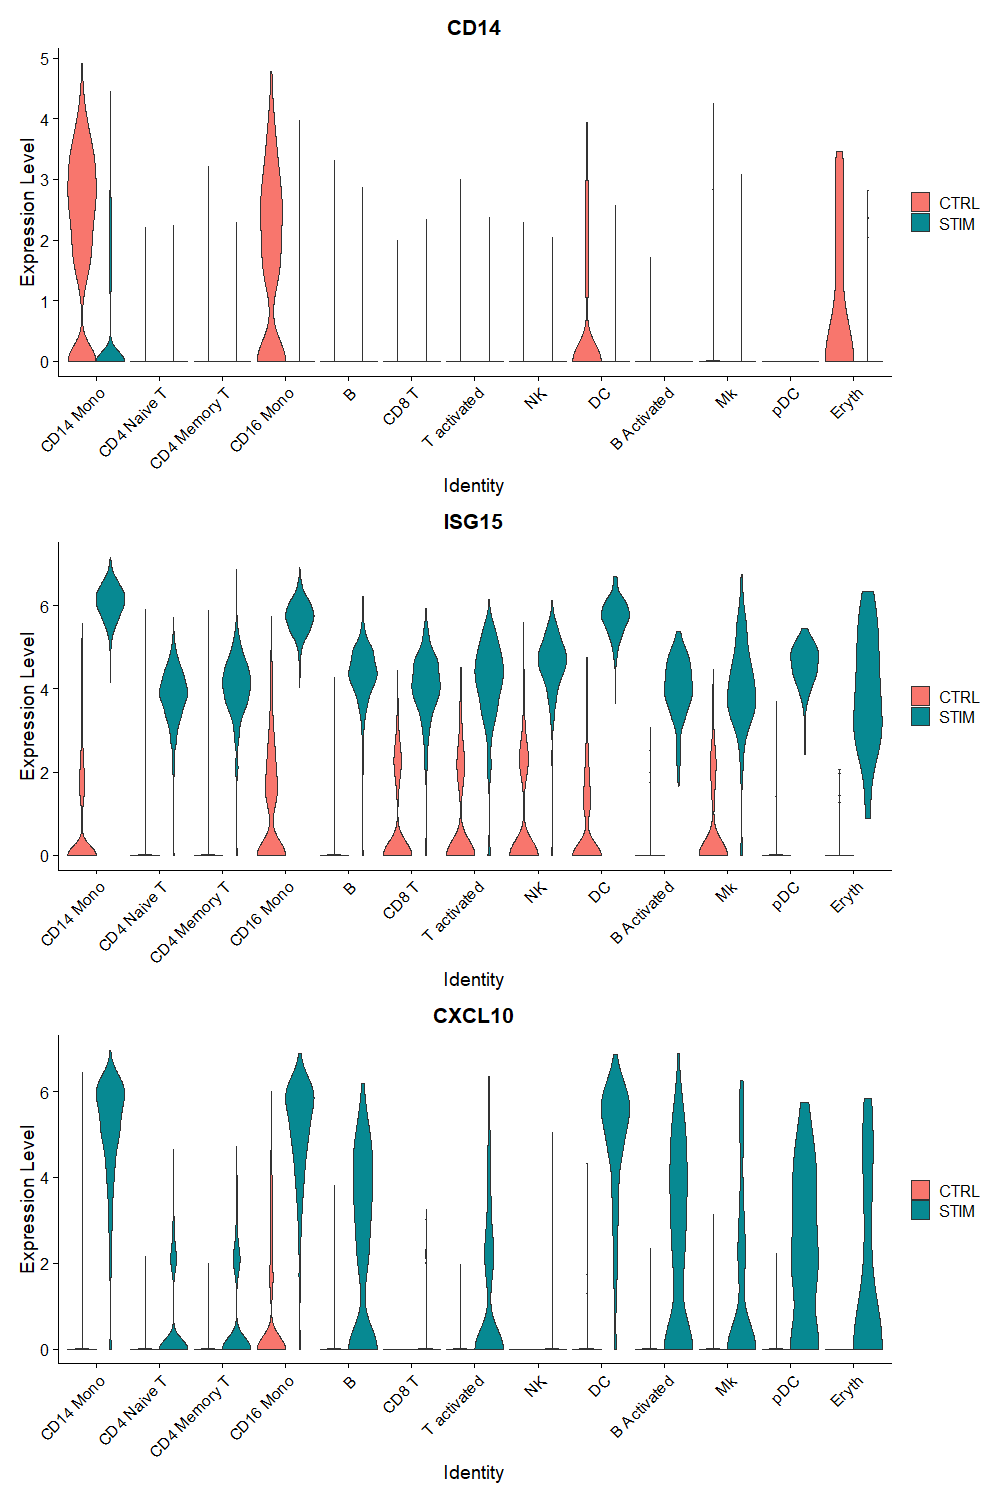
CD3D基因是T细胞的特征基因,而GNLY基因则是NK/CD8 T细胞的特征基因。从我们得到的图像中不难看出,其表达在两组细胞中差异并不大,说明这两个基因几乎不受干扰素刺激的影响,并且在对照组和刺激组中表现出相似的基因表达模式。IF16和ISG15基因是干扰素反应的核心基因,在刺激组中的表达明显上调。CD14和CXCL10基因是在干扰素(IFN)应答中具有细胞类型特异性的基因。在刺激组中,我们发现刺激组CD14 Monocyte的CD14基因反而出现下调,CXCL10基因在单核细胞和B细胞中表现出明显的上调。
这里值得一提的是,如果我们将CD14作为识别CD14 Monocyte的唯一标志基因的话,由于刺激组CD14基因表达下调,在分析的时候容易将这些细胞误认为非CD14 Monocyte而排除,就会造成分类的错误。这凸显了整合分析的重要性。
执行与SCTransform规范化数据集的集成
LogNormalize太差了怎么办!可以试试它!SCTransform标准化,更适合单细胞数据宝宝体质!(划掉)
还是和之前一样,用SCTransform标准化替代LogNormalize、FindVaribleFeatures、ScaleData这三步。在这里不做过多解释啦!
1 | ifnb <- LoadData("ifnb") |
- 运行结果:
1 | ifnb <- IntegrateLayers(object = ifnb, method = CCAIntegration, normalization.method = "SCT", verbose = F) |
- 运行结果:
1 | ifnb <- PrepSCTFindMarkers(ifnb) |
再往下就和前面一样啦,所以到这里!本篇完结撒花!
完整代码
1 | library(Seurat) |
Nahida
也许是各种学习小记的集合。
正在播放1 / 2