前言

单细胞测序中,实验和数据的收集往往不是一次性完成的,而是分为多个批次进行的。在不同批次之间,操作者、操作流程等诸多因素存在差异,可能给实验引入一些与真实生物学差异无关的系统性偏差,称为 批次效应 。

单细胞测序数据的整合通常是scRNA-seq测序的重要步骤之一。通过匹配不同数据集之间的共享细胞类型和状态,我们可以消除批次效应所引入的偏差,从而提高了统计功效。我们常使用的整合数据的方法有多种,包括Seurat早期版本发布的基于锚点的整合流程,其他团队发布的整合算法(如Harmony、scVI等)。Seurat v5版本的突破在于为这些不同的算法提供了一个通用的调用接口;只需要一行代码即可用不同的算法整合数据,为数据分析提供了极大的便利。

这里先加载需要用到的一系列R包。需要注意的是:

  1. SeuratWrappers和Azimuth这两个包的过程中遇到了下载失败的问题,这是因为这两个包并没有在CRAN上发布,因此无法通过install.packages()语句直接下载。你可以尝试在安装remotes包后,用remotes::install.github()语句下载。如果仍然下载失败,可以Win+R后输入inetcpl.cpl后确认,打开Internet属性界面;然后在“高级”选项下找到并勾选“使用TLS 1.0”、“使用TLS 1.1”、“使用TLS 1.2”。最后重新运行安装语句即可下载。
  2. 建议检查自己所使用的Seurat包的版本。如果为Seurat v5.3.0版本,建议回退5.2及之前的版本(install.packages("Seurat", version = "5.2.0")),或安装Github发布的最新开发版本(devtools::install_github("satijalab/seurat"))。原因见下述。
1
2
3
4
5
6
7
library(Seurat)
library(SeuratData)
library(SeuratWrappers)
library(Azimuth)
library(ggplot2)
library(patchwork)
options(future.globals.maxSize = 1e9)

Seurat v5对象中的layer

首先我们先介绍assay和layer的概念。Assay是存储同种分子类型数据的容器,多模态数据可通过多个独立的assay进行存储。layer是存储在同一assay内部的数据处理状态版本。​如果将Seurat对象比喻为一座图书馆,每一个assay即为这个图书馆内的一类藏书;而assay中的每一个layer则代表这类藏书的每一个版本。除此之外,这个图书馆还有一套“图书索引系统”,也就是meta.data,用来记录细胞的批次、干预信息。

Seurat早期版本中,每一个assay中能且仅能存储一个layer。这个限制会给我们带来了麻烦:我们在对数据处理的时候,处理后的数据不得不覆盖原先的数据,删除了原数据而导致难以回溯。而Seurat v5的一个突破点在于解除了这一限制,一个assay可以储存多个layer,可以储存多种处理状态下的实验数据(原始数据、未标准化的数据、标准化后的数据、Z-score标准化后的数据等)。

Azimuth包是一款自动化单细胞注释工具,通过预训练的参考模型将细胞精准映射到已知细胞类型,无需手动标注。在这里,我们加载PBMC数据集(pbmcsca)并质量控制后,使用Azimuth包,以pbmcsca(经过预先训练的参考数据集)为对照,获取细胞类型的预测结果。SeuratData提供的参考数据集似乎需要连接位于纽约的服务器下载,因此下载超级超级慢,在RStudio中容易超时报错。故在下载前先修改了timeout时间再进行下载。或者在浏览器中打开下载网址下载pbmcsca和pbmcref。尽管如此,下载速度慢的问题仍然难以解决,建议预留充足时间。

1
2
3
4
5
options(timeout = 600000000)
InstallData("pbmcsca")
obj <- LoadData("pbmcsca")
obj <- subset(obj, nFeature_RNA > 1000)
obj <- RunAzimuth(obj, reference = "pbmcref")

另外,如果你遇到了以下报错:

1
2
Error in ValidateParams_FindTransferAnchors(reference = reference, query = query, : 
Reference assay is SCT, but query assay is RNA. Mixing SCT and non-SCT in FindTransferAnchors is not supported.

有可能是因为Seurat v5.3.0版本中FindTransferAnchors函数对分析数据类型(SCT、RNA)的严格检查机制。Azimuth包提供的参照数据集pbmcsca仅包含SCTransform标准化后的版本;因此在运行时,如果所处理的数据仅包含未标准化的数据时,会报告SCT缺失;如果对数据进行SCTransform转换,又会报告RNA缺失。网络上推荐的方法为更换Seurat包的版本,可以回退5.2及之前的版本(install.packages("Seurat", version = "5.2.0")),也可以安装Github发布的最新开发版本(devtools::install_github("satijalab/seurat"))。我选择安装Github上的最新版本。

  • 输出结果:
1
2
3
4
5
6
7
> obj
An object of class Seurat
33789 features across 10434 samples within 4 assays
Active assay: RNA (33694 features, 0 variable features)
2 layers present: counts, data
3 other assays present: prediction.score.celltype.l1, prediction.score.celltype.l2, prediction.score.celltype.l3
2 dimensional reductions calculated: integrated_dr, ref.umap

这个数据集中一共有9个批次的数据,通过7个不同的技术平台得到。在Seurat早期版本中,我们需要将这些数据保存在9个不同的Seurat对象中,非常不方便。但在Seurat v5中,我们可以将这些数据全部塞进一个Seurat对象中,只需要拆分层次进行区分即可。每批数据分为counts层和data层,因此在拆分之后一共产生了18个layer。我们可以在不整合的情况下对数据进行分析,但需注意:此时各批次标准化和高变基因筛选是独立计算的,最终再形成跨批次的统一输出。

1
2
obj[["RNA"]] <- split(obj[["RNA"]], f = obj$Method)
obj
  • 运行结果:
1
2
3
4
5
6
7
8
> obj[["RNA"]] <- split(obj[["RNA"]], f = obj$Method)
> obj
An object of class Seurat
33789 features across 10434 samples within 4 assays
Active assay: RNA (33694 features, 0 variable features)
18 layers present: counts.Smart-seq2, counts.CEL-Seq2, counts.10x_Chromium_v2_A, counts.10x_Chromium_v2_B, counts.10x_Chromium_v3, counts.Drop-seq, counts.Seq-Well, counts.inDrops, counts.10x_Chromium_v2, data.Smart-seq2, data.CEL-Seq2, data.10x_Chromium_v2_A, data.10x_Chromium_v2_B, data.10x_Chromium_v3, data.Drop-seq, data.Seq-Well, data.inDrops, data.10x_Chromium_v2
3 other assays present: prediction.score.celltype.l1, prediction.score.celltype.l2, prediction.score.celltype.l3
2 dimensional reductions calculated: integrated_dr, ref.umap

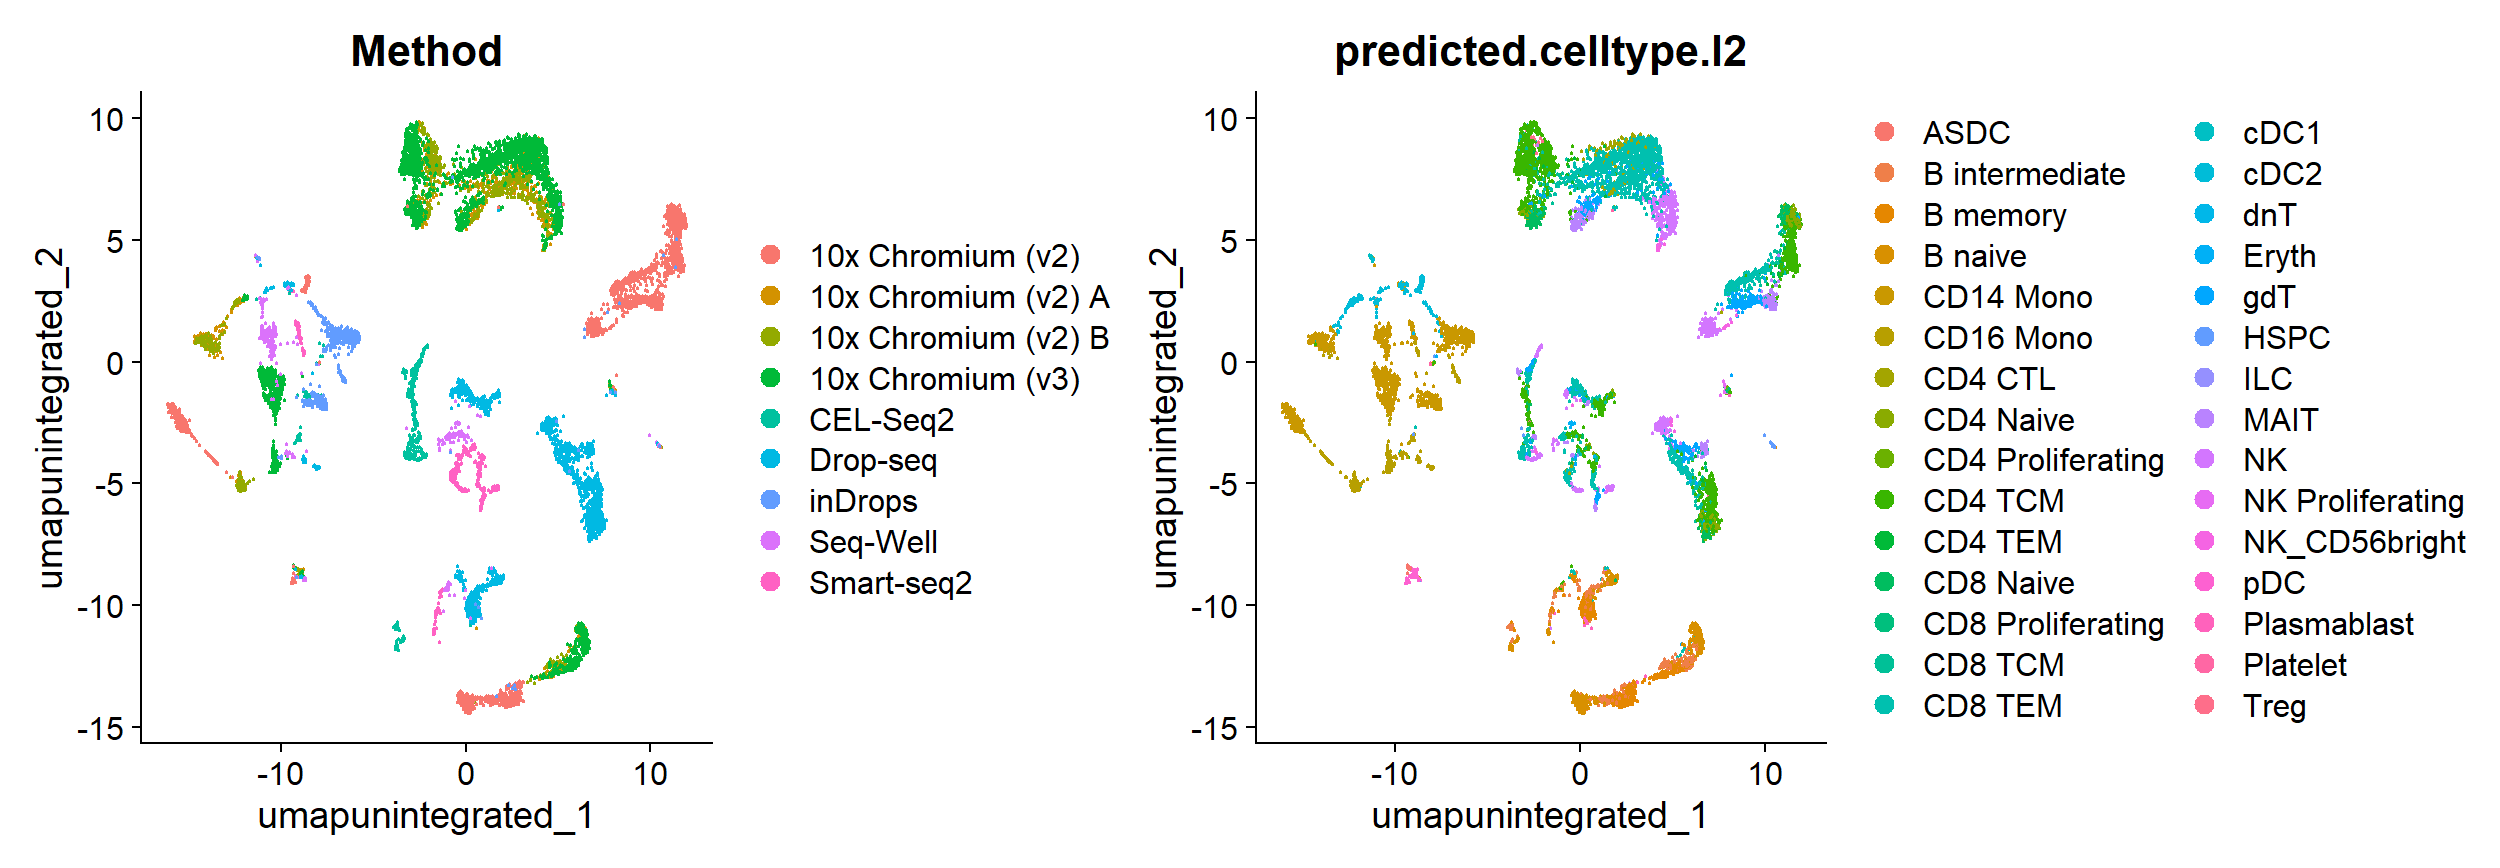
现在我们来对未整合的数据进行可视化。我们的细胞数据主要根据细胞类型和实验批次分类,然而在UMAP降维后的结果中,细胞簇主要按照其所使用的技术平台聚集,而不是按照真正的生物学差异聚集。这是由于不同的技术平台之间存在技术性偏差。如果此时直接聚类,我们将会得到以不同技术平台归类形成的假性细胞簇,而非我们所需要的按照真实生物学差异分类的真细胞簇。

1
2
3
4
5
obj <- FindNeighbors(obj, dims = 1:30, reduction = "pca")
obj <- FindClusters(obj, resolution = 2, cluster.name = "unintegrated_clusters")
obj <- RunUMAP(obj, dims = 1:30, reduction = "pca", reduction.name = "umap.unintegrated")
# 根据细胞分类的结果是预置于Azimuth包内的数据
DimPlot(obj, reduction = "umap.unintegrated", group.by = c("Method", "predicted.celltype.l2"))

运行结果:

通过上图不难发现,同一技术平台得出的细胞会聚集在一起,但同一细胞类型的细胞反而相距较远,呈碎片化分布。这两张图即批次效应的具象化显现。因此,我们需要通过整合分析来去除批次效应,才能得出有意义、站得住脚的结论。

通过单行代码实现不同批次数据的整合分析

Seurat v5支持通过IntegrateLayers()函数,实现不同批次数据的整合分析。其支持的算法有以下五种:

  • 基于锚点的CCA整合(设置method=CCAIntegration):适用于小型数据集(≤5万个细胞),可以精细地保留细胞亚群结构。但计算大数据集时计算速度慢、内存要求高。
  • 基于锚点的RPCA整合(设置method=RPCAIntegration):适用于存在较强技术噪声的小型数据集(≤10万个细胞),具有抗干扰能力强的特点。
  • Harmony(设置method=HarmonyIntegration):兼顾了精度和速度,适用于中型和大型数据集(5—100万个细胞),可满足大多数需求。
  • FastMNN(设置method=FastMNNIntegration):适用于超大规模数据集(>50万个细胞),但处理小型数据集时可能过度平滑。
  • scVI(设置method=scVIIntegration):适用于超大规模的数据集,尤其适用于处理复杂批次和多模态数据等复杂数据集。

以下是使用不同算法进行整合的代码示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
obj <- IntegrateLayers(
object = obj, method = CCAIntegration,
orig.reduction = "pca", new.reduction = "integrated.cca",
verbose = FALSE
)

obj <- IntegrateLayers(
object = obj, method = RPCAIntegration,
orig.reduction = "pca", new.reduction = "integrated.rpca",
verbose = FALSE
)

obj <- IntegrateLayers(
object = obj, method = HarmonyIntegration,
orig.reduction = "pca", new.reduction = "integrated.harmony",
verbose = FALSE
)

obj <- IntegrateLayers(
object = obj, method = FastMNNIntegration,
new.reduction = "integrated.mnn",
verbose = FALSE
)

obj <- IntegrateLayers(
object = obj, method = scVIIntegration,
new.reduction = "integrated.scvi",
conda_env = "../miniconda3/envs/scvi-env", verbose = FALSE
)

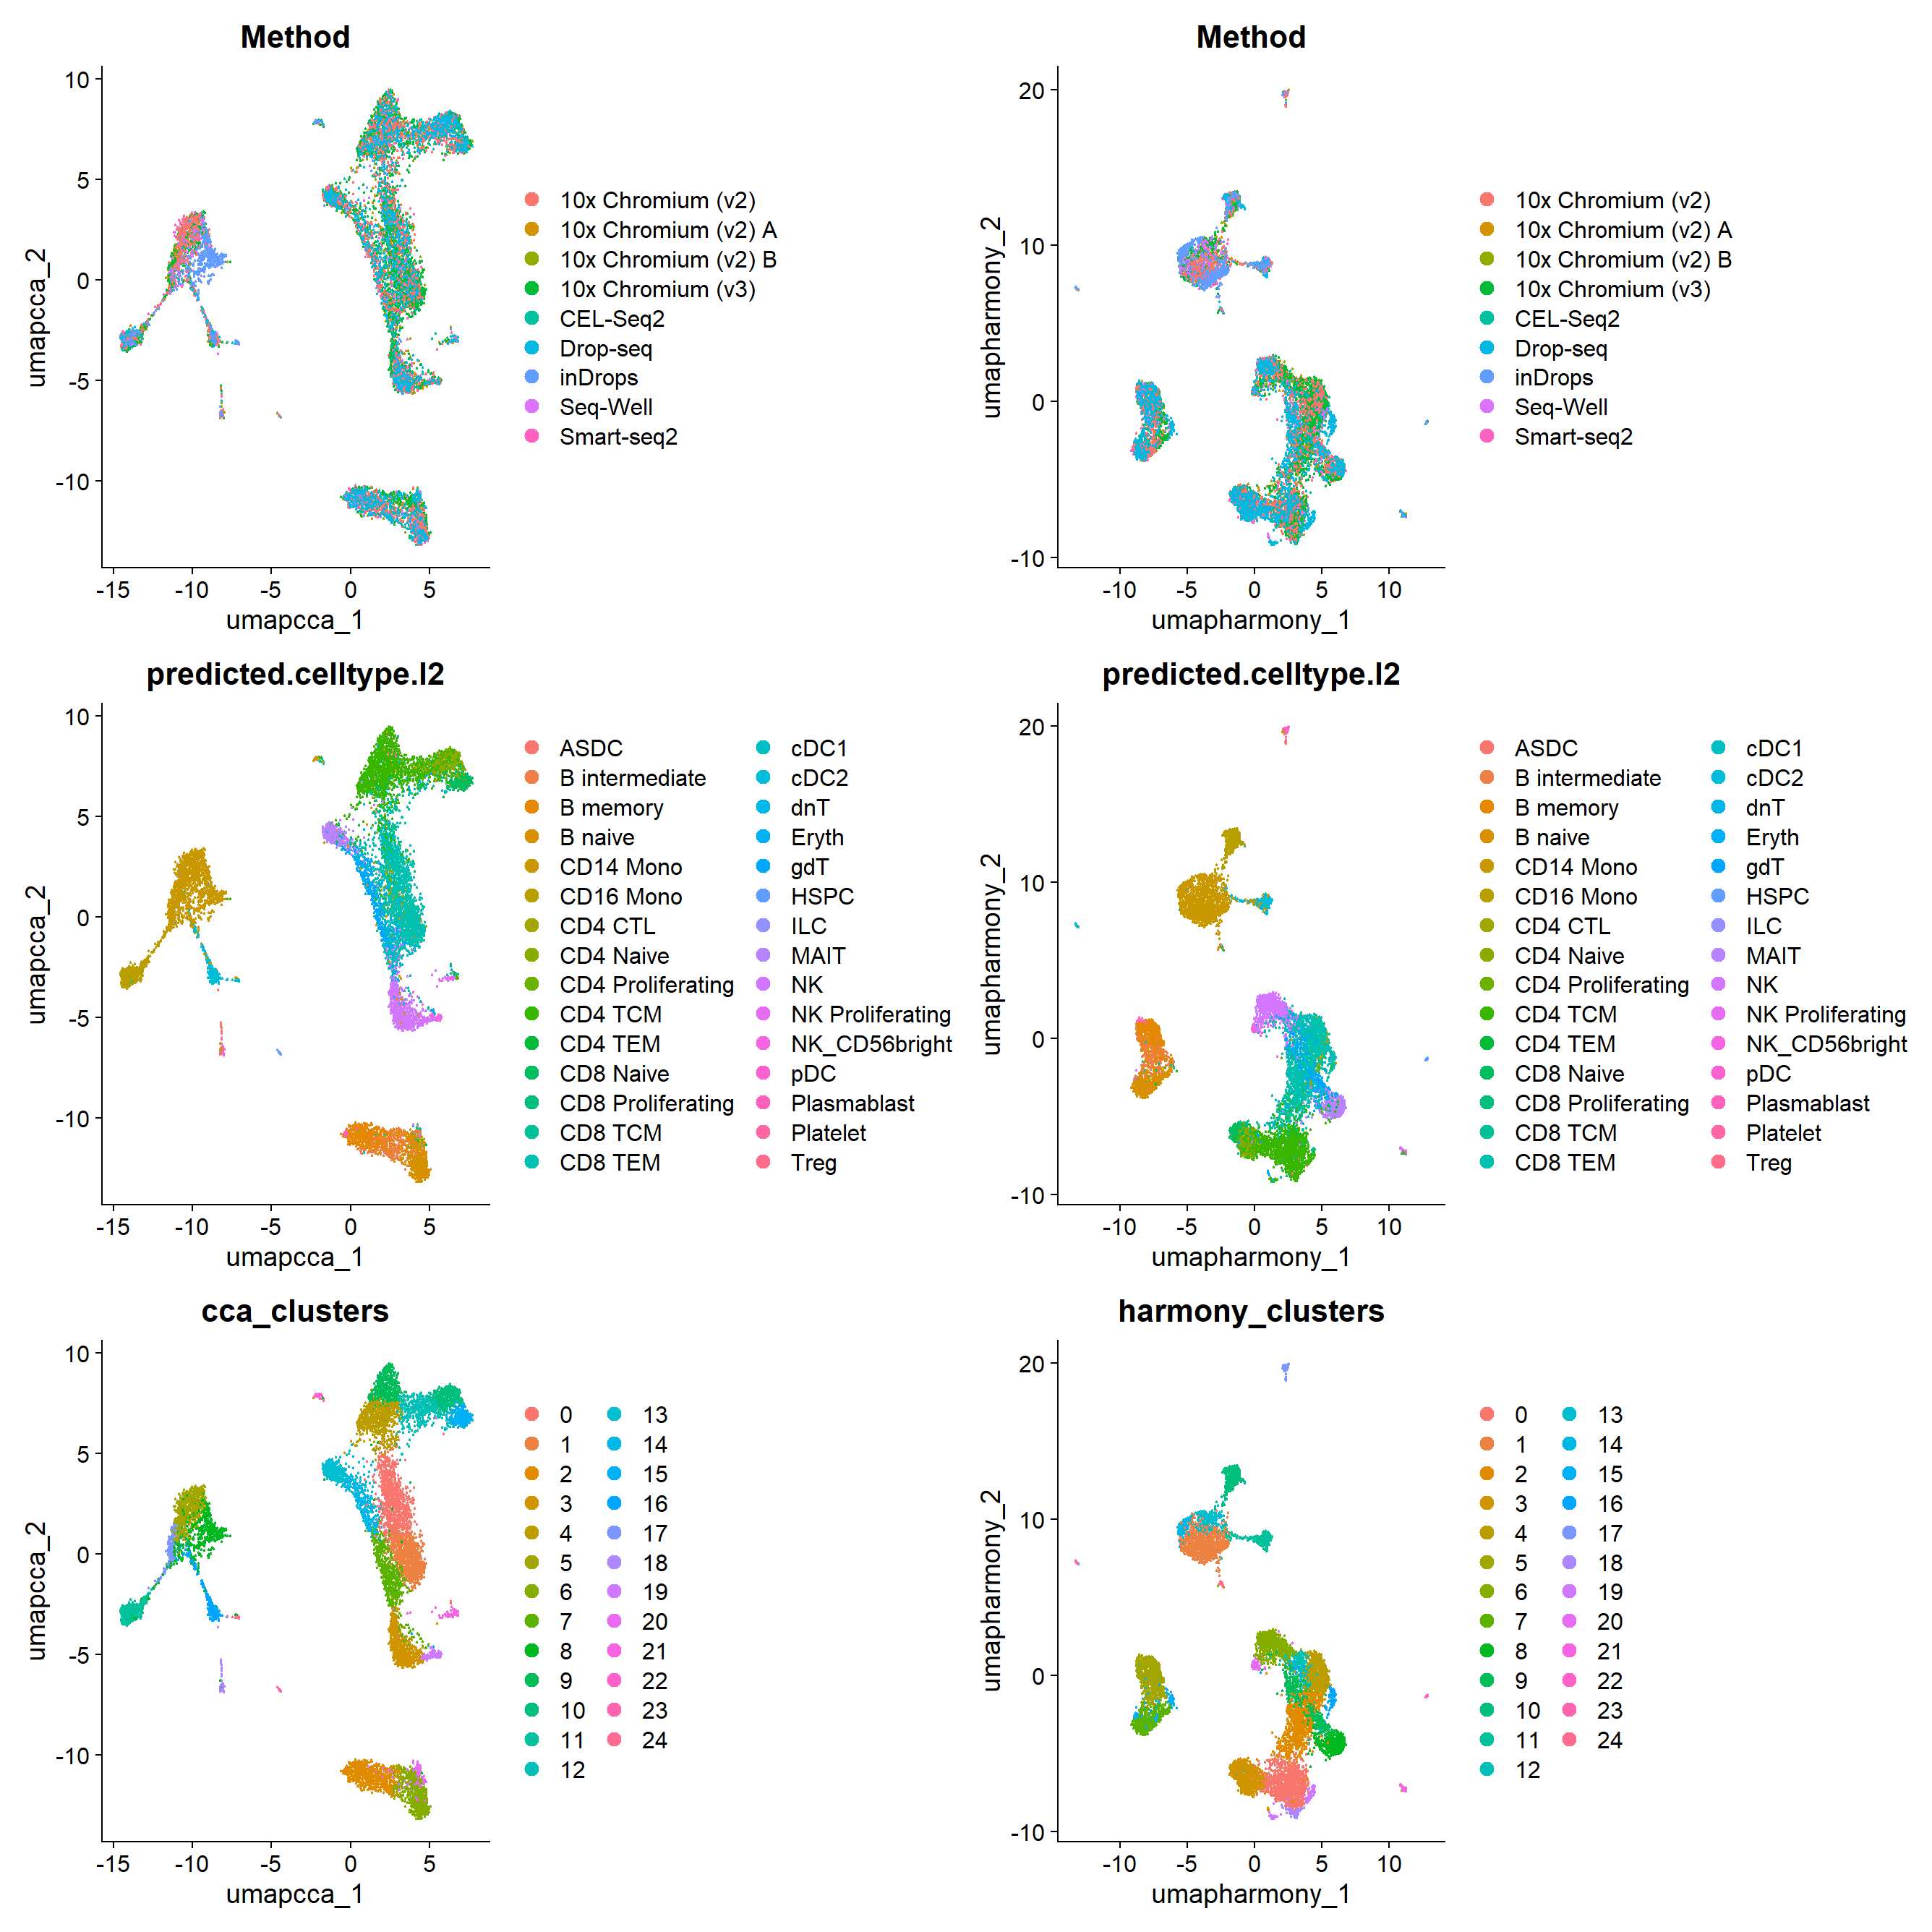
随后,我们可以进一步进行可视化和聚类,这里以CCA和Harmony为例:

注:官方教程中使用了CCA和scVI算法作为示范。但由于本人电脑性能原因(也有可能是一些暂时还没发现的错误),scVI无法正常运行,所以使用Harmony进行替代。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
obj <- FindNeighbors(obj, reduction = "integrated.cca", dims = 1:30)
obj <- FindClusters(obj, resolution = 2, cluster.name = "cca_clusters")

obj <- RunUMAP(obj, reduction = "integrated.cca", dims = 1:30, reduction.name = "umap.cca")
p1 <- DimPlot(
obj,
reduction = "umap.cca",
group.by = c("Method", "predicted.celltype.l2", "cca_clusters"),
combine = FALSE, label.size = 2
)

obj <- FindNeighbors(obj, reduction = "integrated.harmony", dims = 1:30)
obj <- FindClusters(obj, resolution = 2, cluster.name = "harmony_clusters")

obj <- RunUMAP(obj, reduction = "integrated.harmony", dims = 1:30, reduction.name = "umap.harmony")
p2 <- DimPlot(
obj,
reduction = "umap.harmony",
group.by = c("Method", "predicted.celltype.l2", "harmony_clusters"),
combine = FALSE, label.size = 2
)

wrap_plots(c(p1, p2), ncol = 2, byrow = F)

没有任何一种算法是完美的。我们需要对不同的算法整合后的结果进行评估,从而选择最适宜的方法继续分析。Seurat v5版本极大地简化了整合的操作复杂度,使得研究者可以更加专注于整合效果的比较。

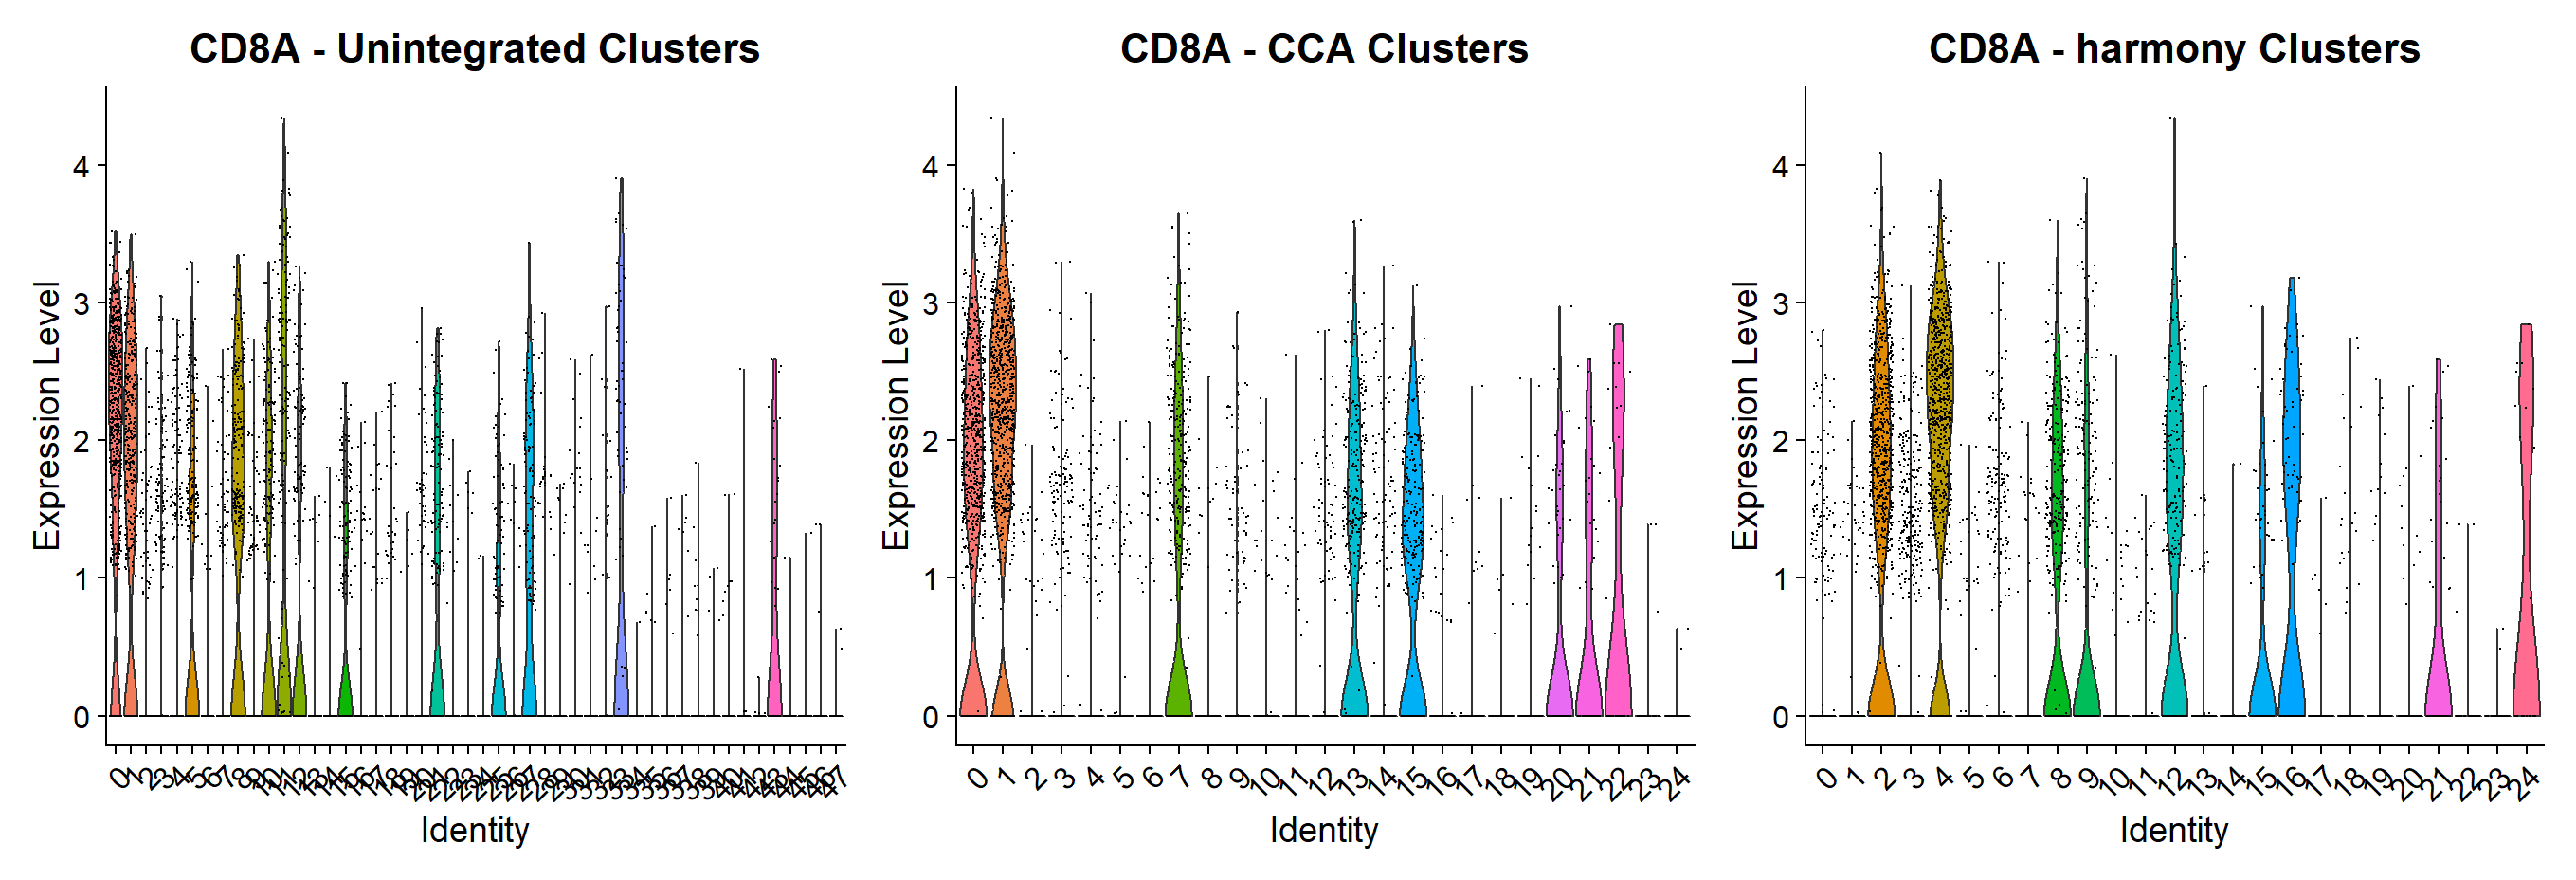
例如,我们可以比较特定细胞类型的标志基因在不同聚类结果中的分布情况。如果分布情况在不同聚类算法的结果之间出现巨大差异,则说明整合算法对真实生物学信息存在较大的破坏作用,需要慎重采纳。

1
2
3
4
5
6
7
8
9
10
11
12
13
p1 <- VlnPlot(
obj,
features = "rna_CD8A", group.by = "unintegrated_clusters"
) + NoLegend() + ggtitle("CD8A - Unintegrated Clusters")
p2 <- VlnPlot(
obj, "rna_CD8A",
group.by = "cca_clusters"
) + NoLegend() + ggtitle("CD8A - CCA Clusters")
p3 <- VlnPlot(
obj, "rna_CD8A",
group.by = "harmony_clusters"
) + NoLegend() + ggtitle("CD8A - harmony Clusters")
p1 | p2 | p3

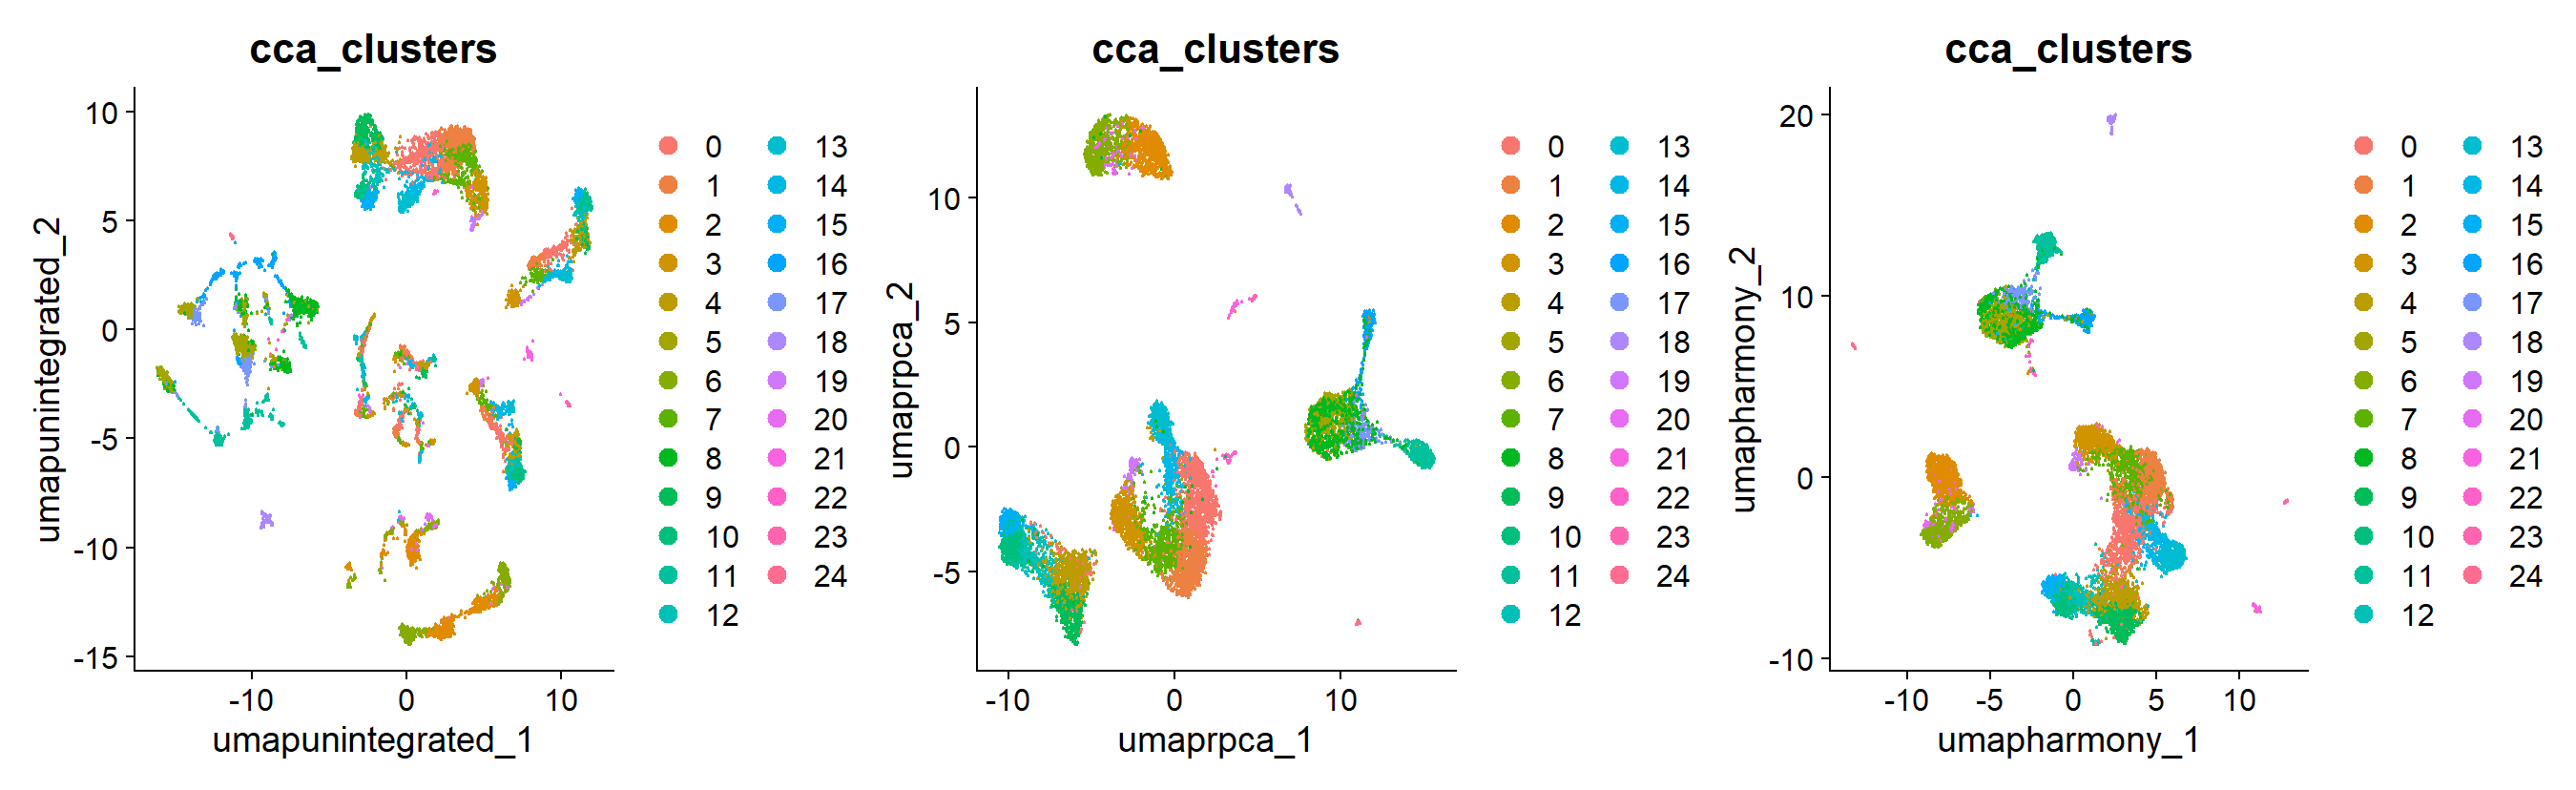
我们还可以将一种聚类方法得到的细胞分簇结果投射到不同聚类方法形成的UMAP图上,以评估该算法保留原细胞群结构的能力。若同一群细胞在不同 UMAP 中分散混乱,说明整合未能保留一致的生物学结构。

1
2
3
4
5
obj <- RunUMAP(obj, reduction = "integrated.rpca", dims = 1:30, reduction.name = "umap.rpca")
p4 <- DimPlot(obj, reduction = "umap.unintegrated", group.by = c("cca_clusters"))
p5 <- DimPlot(obj, reduction = "umap.rpca", group.by = c("cca_clusters"))
p6 <- DimPlot(obj, reduction = "umap.harmony", group.by = c("cca_clusters"))
p4 | p5 | p6

现在,我们来总结一下我们前面做的所有事情。整合算法的目的是消除不同批次数据之间的批次效应,其前提是算法能够识别不同数据所来源的批次。因此,我们通过split将数据包中的不同批次数据分开为不同的layer,以便整合算法的进行。随后,我们使用了整合算法消除不同批次数据之间的批次效应。这就好比你手头上有中英文的菜单各一本,它们除了语言不同之外,其余都保持一致。如果你想要把这两份菜单整理成一份新的菜单,那么你需要将这两份菜单的每一页都拆解出来(split),然后逐一匹配两份菜单的对应页(整合)。此时的整合分析工作已经基本完成,但你还需要为它画上一个圆满的句号,即将这些分开的数据重新合并为一个整体。借用前面的比喻,现在需要做的事情,就是把匹配好的纸张重新装订为一本全新的双语菜单。值得一提的是,在合并之后如果有需要,可以将数据重新拆分。

1
2
obj <- JoinLayers(obj)
obj

运行结果:

1
2
3
4
5
6
7
8
> obj <- JoinLayers(obj)
> obj
An object of class Seurat
35789 features across 10434 samples within 5 assays
Active assay: RNA (33694 features, 2000 variable features)
3 layers present: data, counts, scale.data
4 other assays present: prediction.score.celltype.l1, prediction.score.celltype.l2, prediction.score.celltype.l3, mnn.reconstructed
11 dimensional reductions calculated: integrated_dr, ref.umap, pca, umap.unintegrated, integrated.cca, integrated.rpca, integrated.harmony, integrated.mnn, umap.cca, umap.harmony, umap.rpca

最后值得一提的是,我们可以使用SCTransform后的数据进行整合分析。其步骤为:

  1. 先对原始数据进行SCTransform标准化;
  2. 在IntegrateLayers函数中设置normalization.method参数。
1
2
3
4
5
6
7
8
9
10
11
options(future.globals.maxSize = 3e+09)
obj <- SCTransform(obj)
obj <- RunPCA(obj, npcs = 30, verbose = F)
obj <- IntegrateLayers(
object = obj,
method = RPCAIntegration,
normalization.method = "SCT",
verbose = F
)
obj <- FindNeighbors(obj, dims = 1:30, reduction = "integrated.dr")
obj <- FindClusters(obj, resolution = 2)

完整代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
devtools::install_github("satijalab/seurat")
library(Seurat)
library(SeuratData)
library(SeuratWrappers)
library(Azimuth)
library(ggplot2)
library(patchwork)
options(future.globals.maxSize = 3e9)
#InstallData("pbmcsca")

obj <- LoadData("pbmcsca")
obj <- subset(obj, nFeature_RNA > 1000)
options(timeout = 600000000)
obj <- RunAzimuth(obj, reference = "pbmcref")
obj

obj[["RNA"]] <- split(obj[["RNA"]], f = obj$Method)
obj

obj <- NormalizeData(obj)
obj <- FindVariableFeatures(obj)
obj <- ScaleData(obj)
obj <- RunPCA(obj)

obj <- FindNeighbors(obj, dims = 1:30, reduction = "pca")
obj <- FindClusters(obj, resolution = 2, cluster.name = "unintegrated_clusters")
obj <- RunUMAP(obj, dims = 1:30, reduction = "pca", reduction.name = "umap.unintegrated")
# visualize by batch and cell type annotation
# cell type annotations were previously added by Azimuth
DimPlot(obj, reduction = "umap.unintegrated", group.by = c("Method", "predicted.celltype.l2"))

obj <- IntegrateLayers(
object = obj, method = CCAIntegration,
orig.reduction = "pca", new.reduction = "integrated.cca",
verbose = FALSE
)

obj <- IntegrateLayers(
object = obj, method = RPCAIntegration,
orig.reduction = "pca", new.reduction = "integrated.rpca",
verbose = FALSE
)

obj <- IntegrateLayers(
object = obj, method = HarmonyIntegration,
orig.reduction = "pca", new.reduction = "integrated.harmony",
verbose = FALSE
)

#BiocManager::install("batchelor")
obj <- IntegrateLayers(
object = obj, method = FastMNNIntegration,
new.reduction = "integrated.mnn",
verbose = FALSE
)

library(reticulate)
obj <- IntegrateLayers(
object = obj, method = scVIIntegration,
new.reduction = "integrated.scvi",
conda_env = "D:/software/Anaconda/envs/scvi-env",
verbose = TRUE
)

obj <- FindNeighbors(obj, reduction = "integrated.cca", dims = 1:30)
obj <- FindClusters(obj, resolution = 2, cluster.name = "cca_clusters")

obj <- RunUMAP(obj, reduction = "integrated.cca", dims = 1:30, reduction.name = "umap.cca")
p1 <- DimPlot(
obj,
reduction = "umap.cca",
group.by = c("Method", "predicted.celltype.l2", "cca_clusters"),
combine = FALSE, label.size = 2
)

obj <- FindNeighbors(obj, reduction = "integrated.harmony", dims = 1:30)
obj <- FindClusters(obj, resolution = 2, cluster.name = "harmony_clusters")

obj <- RunUMAP(obj, reduction = "integrated.harmony", dims = 1:30, reduction.name = "umap.harmony")
p2 <- DimPlot(
obj,
reduction = "umap.harmony",
group.by = c("Method", "predicted.celltype.l2", "harmony_clusters"),
combine = FALSE, label.size = 2
)

wrap_plots(c(p1, p2), ncol = 2, byrow = F)


p1 <- VlnPlot(
obj,
features = "rna_CD8A", group.by = "unintegrated_clusters"
) + NoLegend() + ggtitle("CD8A - Unintegrated Clusters")
p2 <- VlnPlot(
obj, "rna_CD8A",
group.by = "cca_clusters"
) + NoLegend() + ggtitle("CD8A - CCA Clusters")
p3 <- VlnPlot(
obj, "rna_CD8A",
group.by = "harmony_clusters"
) + NoLegend() + ggtitle("CD8A - harmony Clusters")
p1 | p2 | p3

obj <- RunUMAP(obj, reduction = "integrated.rpca", dims = 1:30, reduction.name = "umap.rpca")
p4 <- DimPlot(obj, reduction = "umap.unintegrated", group.by = c("cca_clusters"))
p5 <- DimPlot(obj, reduction = "umap.rpca", group.by = c("cca_clusters"))
p6 <- DimPlot(obj, reduction = "umap.harmony", group.by = c("cca_clusters"))
p4 | p5 | p6

obj <- JoinLayers(obj)
obj

options(future.globals.maxSize = 3e+09)
obj <- SCTransform(obj)
obj <- RunPCA(obj, npcs = 30, verbose = F)
obj <- IntegrateLayers(
object = obj,
method = RPCAIntegration,
normalization.method = "SCT",
verbose = F
)
obj <- FindNeighbors(obj, dims = 1:30, reduction = "integrated.dr")
obj <- FindClusters(obj, resolution = 2)